专注高性能计算领域资讯
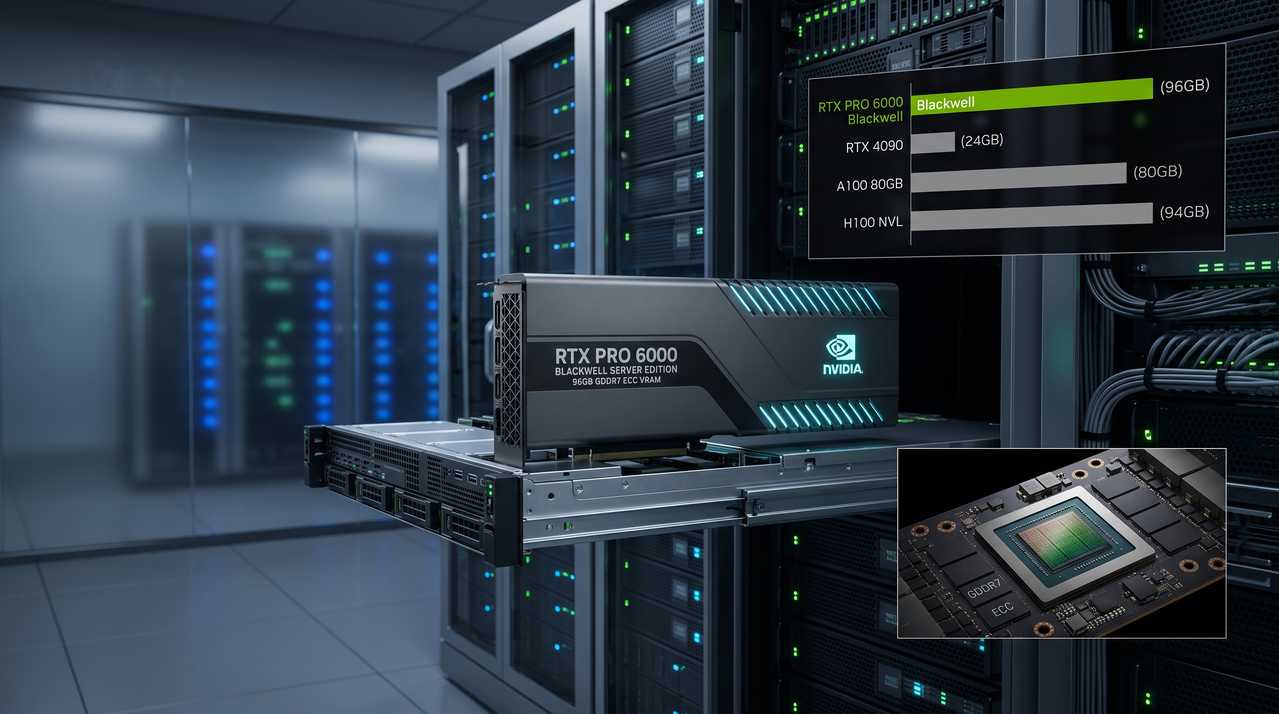
关键词:NVIDIA RTX PRO 6000 Blackwell Server Edition、Blackwell架构、96GB显存、被动散热服务器GPU、大模型本地部署、LLM推理工作站、FP4量化、MIG虚拟化、PCIe 5.0工作站、AI算力基础设施 一、开篇:当24GB显存成为瓶颈,AI工程师的OOM噩梦 如果你是个正经搞AI的,一定对这张报错截图不陌生: 这就是传说中的OOM(Out […]
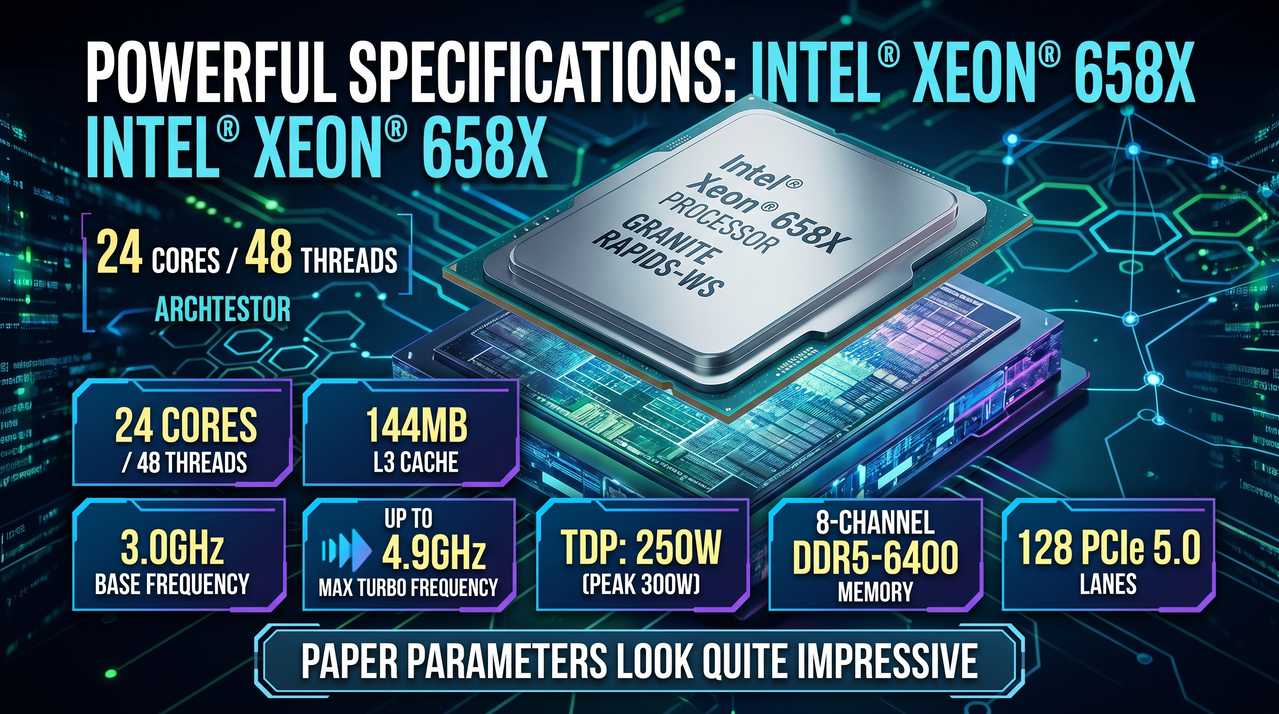
关键词:Intel Xeon 658X、Granite Rapids-WS、AI训练工作站、科学计算、多GPU配置、DDR5 8通道、PCIe 5.0工作站、分子动力学仿真、CFD工作站配置 一、开篇:24核48线程,到底够不够用? 2026年2月,Intel发布了基于Granite Rapids-WS架构的Xeon 658X处理器。24核48线程、144MB L3缓存、基础频率3.0GHz、睿频 […]
——UltraLAB便携超算系列:登机箱里的双路服务器,机场安检直接过 一、移动算力的真空地带 做科研的人,大概率遇到过这种场景: 去杭州开学术会议,晚上十点,同屋的哥们蹲在酒店走廊里,笔记本插着电源,风扇狂转像要起飞。导师临时要一组对比实验数据,笔记本已经跑了三个小时,进度条才走到40%。 “你咋不用远程连实验室服务器?” “试了,VPN连不上,就算连上,排队 […]
一、当算力遇上存储瓶颈 在某国家重点实验室的流体力学仿真中心,工程师们曾遇到过一个令人困惑的现象:他们耗资数百万部署的GPU计算集群,在处理大规模CFD(计算流体力学)任务时,GPU利用率却长期徘徊在40%以下。经过数周的排查,问题根源被锁定在存储子系统——当数百个计算节点同时读取网格数据时,传统机械硬盘阵列的IOPS(每秒输入输出操作数)迅速饱和,整个集群陷入了”算力等数据̶ […]
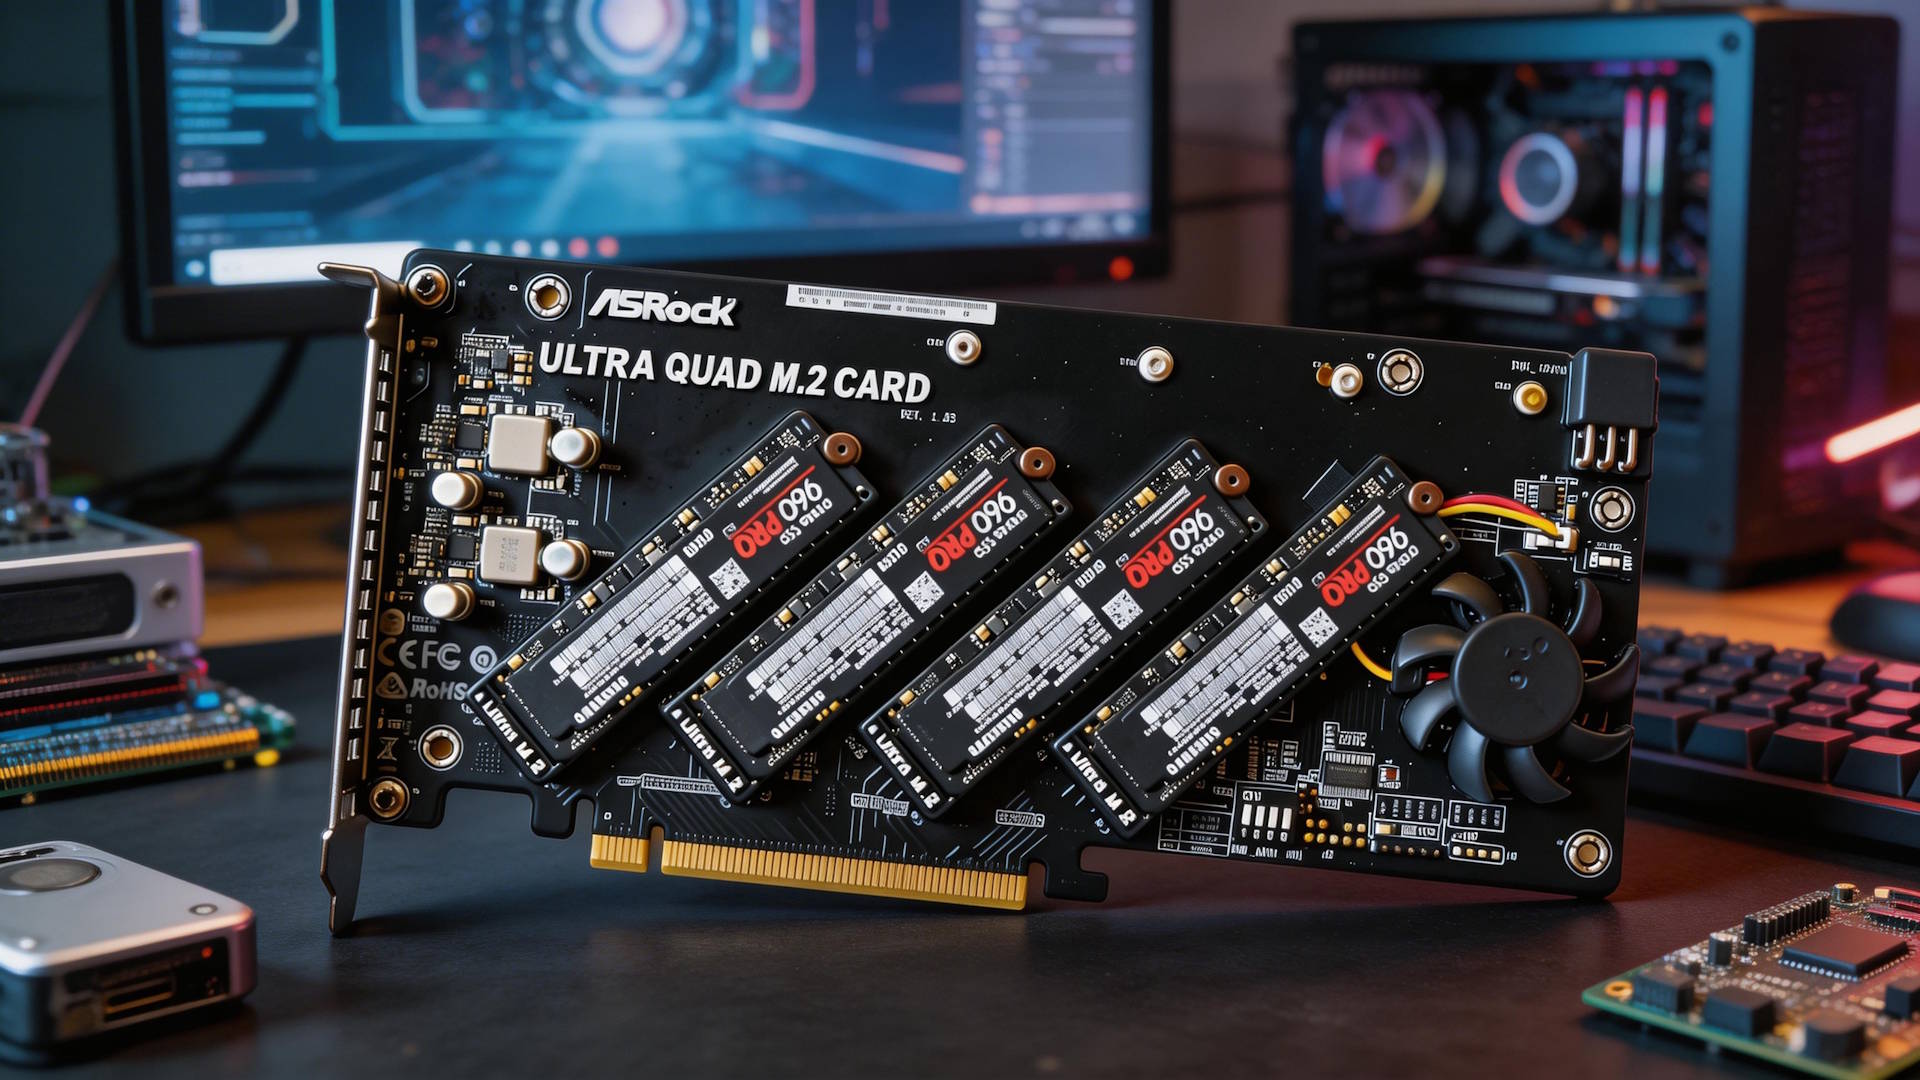
一、先讲个悲伤的故事 去年,我帮一位做视频剪辑的朋友升级工作站。他三年前买的”高端”主机,当时配置看起来挺唬人:i9处理器、64G内存、RTX 3080。结果今年想加装一块新的AI加速卡跑Stable Diffusion,拆开机箱一看——傻眼了。 PCIe插槽满了。更惨的是,他想再加装两块高速NVMe SSD做剪辑缓存,发现M.2接口只有两个,而且第二个还是和SATA接口共 […]
一、问题 在现代数据中心和高性能计算环境中,存储I/O瓶颈已成为制约系统整体性能的关键短板。当CPU核心数从几十个扩展到上百个,内存带宽达到数百GB/s时,存储子系统却常常成为数据流动的”窄门”。 一个典型的场景是:某AI训练集群配备了最新的GPU加速卡,但在加载大规模数据集时,系统却频繁处于等待状态——GPU利用率骤降,训练进程被I/O阻塞。监测数据显示,单个PCIe 4 […]
精选行业动态 + 全网热点,不遗漏关键信息