
关键词:Intel Xeon 658X、Granite Rapids-WS、AI训练工作站、科学计算、多GPU配置、DDR5 8通道、PCIe 5.0工作站、分子动力学仿真、CFD工作站配置
一、开篇:24核48线程,到底够不够用?
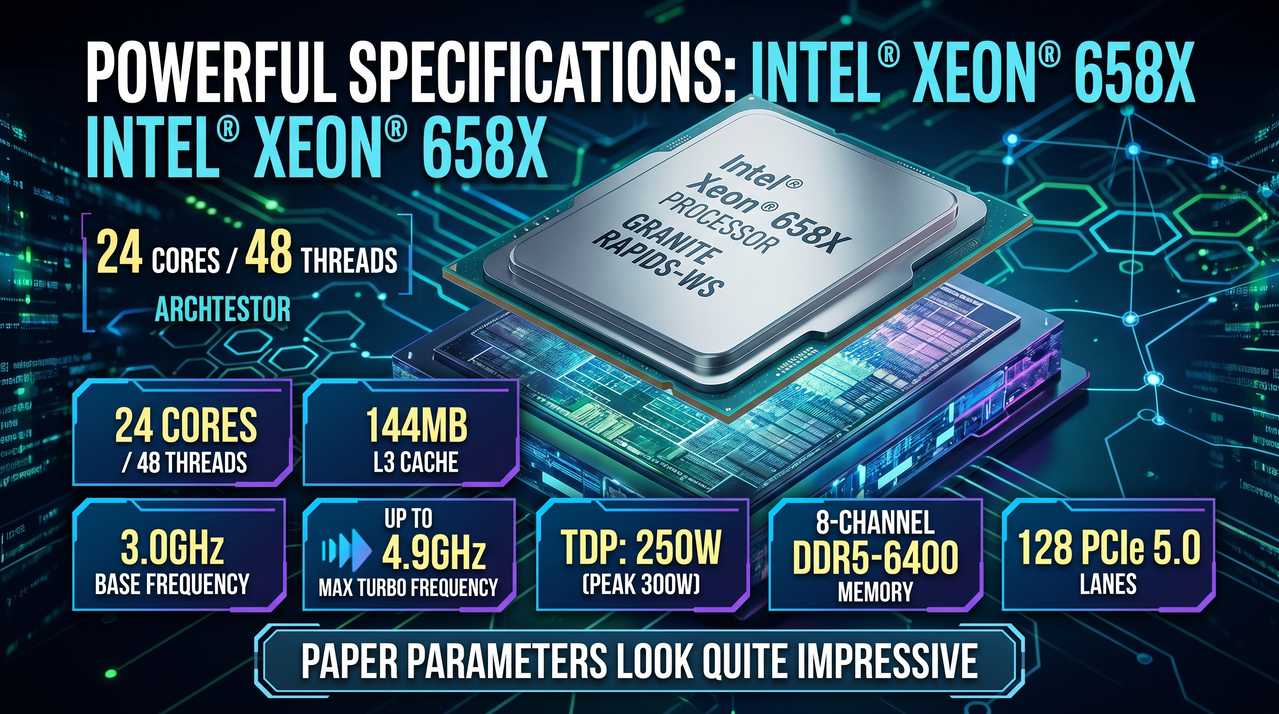
2026年2月,Intel发布了基于Granite Rapids-WS架构的Xeon 658X处理器。24核48线程、144MB L3缓存、基础频率3.0GHz、睿频最高4.9GHz、TDP 250W(峰值300W)、8通道DDR5-6400内存支持、128条PCIe 5.0通道——纸面参数看着挺唬人。
但问题来了:24核,在2026年的AI训练和高性能计算场景里,到底够不够用?
如果你只是跑个ResNet-50图像分类,或者用YOLO做个目标检测,那确实够。甚至有点浪费。但如果你在做以下这些事情,24核可能刚刚好,甚至可能是瓶颈:
- 大语言模型微调:Llama 3 70B参数模型,单张A100 80GB都塞不下,需要模型并行,CPU得协调多卡之间的梯度同步和参数更新
- 分子动力学模拟:GROMACS或者NAMD跑百万原子级别的蛋白-配体复合物体系,24核刚好能喂饱一块RTX 4090,但想上双卡?CPU调度压力直接翻倍
- CFD仿真:OpenFOAM算一个精细网格的湍流燃烧模拟,时间步长推进时,CPU预处理、边界条件计算、网格重构都是串行或半并行任务,核心数不够就是卡脖子
- 金融量化回测:并行跑多个策略组合的历史回测,每个线程一个策略,24线程意味着同时只能跑24个策略实例,想加速?加钱上更多核
所以答案很现实:24核不是终点,而是一个精打细算后的甜点配置。 它足够应付绝大多数单机多卡训练场景,但想往集群级扩展?单路24核肯定不够看。
那么,为什么Intel要出这么一颗处理器?它跟AMD的线程撕裂者Pro 7985WX(64核128线程)相比,到底有什么优势?这才是本文要聊的核心。
二、Granite Rapids-WS架构解析:Intel的反击
2.1 Redwood Cove核心:单核性能的倔强
Xeon 658X的核心代号是Redwood Cove,Intel 3制程工艺(注意,不是Intel 7,是实打实的3nm级工艺)。相比上一代Sapphire Rapids的Golden Cove核心,Redwood Cove做了几个关键改进:
指令缓存翻倍:从32KB增加到64KB。对于分支密集型的科学计算代码(比如蒙特卡洛模拟、分子动力学里的邻居列表搜索),更大的I-Cache意味着更少的缓存未命中,IPC(每时钟周期指令数)能提升5-10%。
浮点乘法延迟优化:从4个周期降到3个周期。听起来微不足道,但矩阵运算、FFT变换、有限元计算里全是浮点乘法累积,积少成多就是10-15%的性能差距。
改进的分支预测和预取:科学计算代码往往有复杂的分支逻辑(if-else判断边界条件、自适应网格细化),更好的分支预测意味着更少的流水线清空惩罚。
结论:Redwood Cove不是为了堆核数,是为了让单核更强。在单线程敏感型任务(比如CAD建模、网格前处理、小型参数的Python脚本调试)上,658X的单核睿频4.9GHz配合改进的微架构,能把AMD Zen4的高频优势抹平甚至反超。
2.2 144MB L3缓存:被低估的算力加速器
很多人看CPU只看核心数和频率,忽略了缓存。但对于科学计算和AI训练,L3缓存的大小直接决定了数据局部性(Data Locality)的好坏。
举个例子:在分子动力学模拟中,每个原子需要知道其周围10-15Å范围内所有其他原子的位置来计算范德华力和静电相互作用。如果这些数据都在L3缓存里,访问延迟是10-20ns;如果得去内存里读,延迟是80-100ns,慢5倍。144MB L3缓存意味着你可以一次性塞进更多原子的邻居列表,缓存命中率提高,CPU不用干等着内存喂数据。
对比AMD Threadripper Pro 7985WX:64核但L3缓存只有256MB(每4核共享32MB CCD),平均到每个核心只有4MB L3。658X是24核144MB,平均每核6MB L3,单核缓存配比更高,对于单线程性能敏感型任务更有优势。
2.3 AVX-512与AMX:AI和科学计算的硬件加速器
658X支持完整的AVX-512指令集(512位向量宽度)和AMX(Advanced Matrix Extensions,高级矩阵扩展)。
AVX-512:在CFD的向量运算、图像处理的卷积计算、金融量化的矩阵运算中,512位向量一次能处理8个双精度浮点数或16个单精度浮点数,理论上比256位AVX2快一倍。实际中由于内存带宽瓶颈,可能只能快30-50%,但已经是很可观的提升了。
AMX:这是Intel专门针对AI推理和训练设计的矩阵加速器。支持BFloat16和INT8数据类型,能做高达2048×2048规模的矩阵乘法。在TensorFlow或PyTorch里启用XLA编译,AMX能把小batch的推理延迟降低40-60%。对于不想买独立GPU做轻量级AI开发的用户,AMX是个不错的兜底方案。
2.4 8通道DDR5-6400:内存带宽的质变
这是658X相比上一代W-3500系列(最高DDR5-4800)的最大升级。8通道DDR5-6400,理论带宽是:
6400 MT/s × 8 Byte/transfer × 8 Channel = 409.6 GB/s
对比DDR5-4800的307.2 GB/s,带宽提升了33%。对于内存带宽敏感型应用(比如Stencil计算的有限差分法、大规模稀疏矩阵求解),这33%的提升能直接转化为计算时间的缩短。
更重要的是,8通道内存意味着你可以插8根甚至16根DIMM(每通道2根),最大支持4TB内存容量。对于需要加载整个数据集到内存做训练的AI场景(比如基因组学的全基因组关联分析、气象学的全球高分辨率数值预报),4TB内存可能是刚需。
三、PCIe 5.0 x128:多GPU扩展的物理基础
3.1 为什么是128条通道?
这是658X最恐怖的地方——单颗CPU提供128条PCIe 5.0通道。对比消费级的i9-14900K(20条PCIe 5.0 + 16条PCIe 4.0),或者AMD Threadripper Pro 7985WX(128条PCIe 4.0),658X在通道数量和协议代际上都是顶配。
128条通道意味着什么?我们来算一笔账:
- 单张RTX 4090:需要16条PCIe通道(虽然实际上x8也能跑,但x16是满血)
- 单张A100 80GB PCIe:需要16条PCIe 4.0或PCIe 5.0通道(向下兼容)
- 单张H100 PCIe:需要16条PCIe 5.0通道
- NVMe SSD:每根PCIe 5.0 x4的SSD能提供14GB/s顺序读取速度
- 200Gb/s网卡(ConnectX-7):需要PCIe 5.0 x16
配置实例:
- 4张RTX 4090:4 × 16 = 64条通道
- 2根PCIe 5.0 x4 NVMe SSD做RAID 0:2 × 4 = 8条通道
- 1张ConnectX-7 200Gb/s网卡:16条通道
- 芯片组扩展(USB、SATA、M.2):用掉8-16条通道
总计:64 + 8 + 16 + 16 = 104条通道。还有24条富余。
这意味着658X能轻松驾驭四卡GPU工作站而不需要PCIe Switch芯片(那种芯片会增加延迟、提高成本、增加故障点)。这是它相比消费级平台的绝对优势。
3.2 PCIe 5.0的带宽红利
PCIe 5.0的单通道速率是32GT/s,有效带宽约3.94GB/s(考虑编码开销)。x16就是:
3.94 GB/s × 16 = 63 GB/s 双向带宽
对比PCIe 4.0 x16的32GB/s,翻倍。对于GPU之间的P2P通信(比如NCCL做AllReduce),更高的PCIe带宽意味着更短的梯度同步时间。在大模型训练中,通信开销往往占总时间的30-50%,这部分加速能直接转化为整体训练速度的线性提升。
但有个坑:PCIe 5.0的走线要求极其苛刻。信号完整性(SI)要求高,主板PCB层数得12层起步,PCIe插槽到CPU的走线长度得严格匹配。这也是为什么市面上支持PCIe 5.0 x16满速的主板凤毛麟角,且价格昂贵。
四、UltraLab双水冷+双水泵散热结构:压得住300W的暴力方案
4.1 为什么需要双水冷?
Xeon 658X的TDP是250W,但这是基础功耗。在AVX-512满载、所有核心跑4.3GHz全核睿频时,实际功耗会冲到300W甚至更高。这还没算超频——658X是解锁倍频的(Unlocked Multiplier),想要全核5.0GHz?功耗直奔350W+。
单塔风冷?别想了,解热能力顶天200W。360一体水冷?标称解热300W,但那是基于理想工况,实际长期高负载下,水泵寿命、冷液蒸发、风扇噪音都是问题。而且,水冷排的热容量有限,持续满载半小时后,水温升高,散热效率会衰减。
双水冷+双水泵方案的核心逻辑:
- 冗余设计:两个独立水冷回路,一个坏了另一个还能撑一段时间,不至于直接关机丢数据
- 热容量翻倍:两个480mm冷排(每个能装4个140mm风扇),总散热面积翻倍,能持续镇压300W+的功耗而不升温
- 分区散热:CPU一个回路,GPU(们)另一个回路,避免热量互相干扰
- 双水泵并联:流量加倍,冷液在冷头和冷排之间的循环更快,热交换效率更高
4.2 UltraLab散热结构解剖
UltraLab的这套方案叫”双水冷+双水泵超频结构”,具体实现上是这样:
CPU散热回路:
- 冷头:定制款,覆盖LGA 4710插座的整个顶盖,微水道密度比通用冷头高30%,能更均匀地把热量带走
- 水泵:D5规格,最大流量1500L/h,扬程3.9m,调速范围20-100%
- 冷排:480mm薄排(30mm厚度),4把140mm工业级风扇(非RGB,纯性能取向),最高转速2000RPM,静压4mmH2O
- 水箱:内置在机箱顶部,容量250ml,带透明窗口和RGB灯(就这里有点颜值)
GPU散热回路(假设配双RTX 4090):
- 冷头:全覆盖式设计,包括GPU核心、显存、VRM供电模块,一站式全照顾
- 水泵:第二个D5,独立调速,根据GPU温度曲线自动调节
- 冷排:另一个480mm,同样4把140mm风扇
- 特殊设计:两个GPU串联在水路里,第一个GPU的出水直接进第二个GPU的进水,利用温度梯度差——第一个GPU出水温50°C,进第二个GPU时还有足够余量把第二个GPU压在70°C以下
机箱风道:
- 底部进风:2把180mm风扇,低转速大风量,给主板VRM和内存散热
- 侧板进风:镂空设计,辅助GPU冷排进气
- 顶部出风:CPU和GPU的两个480冷排都装在顶部,热风直排室外
- 后置出风:1把140mm风扇,把机箱余热抽走
这套方案的解热能力标称是CPU 400W + 双GPU 900W,对于658X + 双RTX 4090的组合来说,余量充足。
五、四级配置方案:从入门到集群级
下面按计算规模和预算(不写具体价格,只给配置梯度),给出四个层级的UltraLab工作站方案。
5.1 入门级:单卡AI开发/轻量级科学计算
适用场景:
- 深度学习入门学习,跑MNIST、CIFAR-10小数据集
- 计算机视觉科研,单卡训练ResNet、YOLO、U-Net
- 有限元分析(FEA),网格规模10万-50万节点,Ansys Mechanical、Abaqus标准版
- 计算流体力学(CFD),网格规模100万-500万单元,OpenFOAM单机运行
核心配置:
| 配件 | 规格 | 说明 |
|---|---|---|
| CPU | Intel Xeon 658X | 24核48线程,解锁超频,基础配置 |
| 主板 | W890芯片组,LGA 4710 | 单路工作站主板,8内存槽,3-4个PCIe 5.0 x16插槽 |
| 内存 | 64GB DDR5-6400 ECC RDIMM (8×8GB) | 8通道满配,ECC纠错防止长时间计算内存出错 |
| GPU | 1× RTX 4080 Super 16GB | 单卡方案,功耗320W,水冷版 |
| 系统盘 | 1TB PCIe 5.0 NVMe SSD | 顺序读14GB/s,秒开大型软件 |
| 数据盘 | 4TB SATA SSD 或 8TB机械 | 数据集和结果存储 |
| 散热 | 单水冷360mm | 压制658X 250W TDP,余量充足 |
| 电源 | 1200W 80Plus白金 | 单卡+CPU+余量,安静高效 |
| 机箱 | 中塔工作站机箱 | 支持360水冷,6硬盘位 |
避坑要点:
- 内存必须8根插满才能跑满8通道带宽,插4根会自动降级到4通道,带宽砍半
- 主板选W890芯片组,别用消费级Z790硬改,供电相数不够,VRM散热也不行
- RTX 4080 Super的16GB显存对于大图像(4K医学影像、高分辨率遥感)可能吃紧,预算够直接上4090
5.2 进阶级:双卡AI训练/中等规模仿真
适用场景:
- 双卡并行训练,数据并行(DP)或模型并行(MP),batch size翻倍
- 大语言模型微调,Llama 3 8B/13B单精度全参数训练,或70B的LoRA微调
- 分子动力学,GROMACS双精度,50万-100万原子体系,双卡分担非键相互作用计算
- 电磁仿真,CST Studio Suite或Ansys HFSS,双GPU加速频域求解器
核心配置:
| 配件 | 规格 | 说明 |
|---|---|---|
| CPU | Intel Xeon 658X (超频至全核4.5GHz) | 双卡训练时CPU调度压力大,超频能缩短数据预处理时间 |
| 主板 | W890,双PCIe 5.0 x16满速 | 确保两卡都是x16而非x8,避免带宽瓶颈 |
| 内存 | 128GB DDR5-6400 ECC RDIMM (8×16GB) | 大模型训练显存不够时会用内存做卸载(offload),128GB是底线 |
| GPU | 2× RTX 4090 24GB 水冷版 | 双卡方案,总显存48GB,可以跑更大的batch或更大的模型 |
| 系统盘 | 2TB PCIe 5.0 NVMe SSD | 双系统盘做RAID 0,读速翻倍到28GB/s |
| 数据盘 | 8TB NVMe SSD 或 16TB机械RAID | 大数据集(ImageNet、LAION-5B子集)需要快速随机读取 |
| 散热 | 双水冷双水泵 (UltraLab结构) | CPU独立回路+双GPU串联回路,各480mm冷排 |
| 电源 | 2000W 80Plus钛金 | 双4090(2×450W)+ 超频CPU(350W)+ 余量,2000W刚够 |
| 机箱 | 全塔工作站机箱 | 支持双480冷排,8-12硬盘位 |
避坑要点:
- PCIe lane分配:确认主板说明书,双x16是CPU直连还是经过Switch。直连延迟低,Switch方案可能会有5-10%的P2P带宽损失
- 电源功率计算:RTX 4090瞬时功耗能冲到600W+(涡轮加速),双卡就是1200W,加上超频CPU 350W,其他配件100W,总瞬时1650W。2000W电源余量只有350W,刚好够用但别再加硬件了
- 双卡NVLink/桥接器:RTX 4090不支持NVLink(被老黄砍了),双卡通信只能走PCIe P2P。想用NVLink得买A100/H100,成本翻3-5倍
5.3 专家级:四卡大规模训练/高性能计算集群节点
适用场景:
- 四卡数据并行,ImageNet、LAION-400M级别数据集训练Vision Transformer大模型
- 生成式AI,Stable Diffusion XL微调、视频生成模型(VideoLDM、CogVideo)训练
- 计算流体力学,OpenFOAM大规模并行,千万级网格,LES(大涡模拟)湍流计算
- 第一性原理计算,VASP、Quantum ESPRESSO,四卡分担K点并行计算
- 作为小型集群的Head Node(头节点),管理8-16个计算节点
核心配置:
| 配件 | 规格 | 说明 |
|---|---|---|
| CPU | 1× Intel Xeon 698X(64核)或 1× Xeon 678X(48核) | 单路高核心数CPU,官方支持配置,避免双路兼容性问题 |
| 主板 | 支持四PCIe 5.0 x16的服务器主板 | 如Supermicro X14系列,确保四卡都是x16 |
| 内存 | 256GB DDR5-6400 ECC RDIMM (8×32GB) | 四卡训练时CPU内存是显存的后备,256GB能支持更大规模的模型卸载 |
| GPU | 4× RTX 4090 24GB 水冷版 或 2× A100 80GB PCIe | 四卡4090性价比高但显存分散;双卡A100显存集中,适合大模型 |
| 系统盘 | 4TB PCIe 5.0 NVMe SSD (2×2TB RAID 0) | 系统和频繁访问的数据集 |
| 数据盘 | 16TB NVMe SSD 或 40TB SATA SSD RAID | 海量数据存储,建议分层存储(热数据NVMe,冷数据机械) |
| 网络 | ConnectX-7 200Gb/s InfiniBand 或 100GbE | 如果是集群节点,高速网络是必须的 |
| 散热 | 双水冷双水泵 + 辅助风冷 | CPU双水冷+四卡水冷,VRM和内存加主动散热风扇 |
| 电源 | 双1600W冗余电源 | 总功耗可能超过2500W,双电源冗余且分担负载 |
| 机箱 | 4U机架式工作站或塔式服务器 | 能装进机架,也能放地上,散热和扩展性优先 |
避坑要点:
- CPU瓶颈问题:四卡训练时,数据预处理、梯度聚合、参数更新都是CPU干的活。单路24核可能忙不过来,表现为GPU利用率忽高忽低(GPU等着CPU喂数据)。解决办法:用多进程数据加载(PyTorch的DataLoader多worker),或者升级到更多核的CPU(如698X/678X)
- 四卡PCIe拓扑:四卡都跑在PCIe 5.0 x16需要64条通道,658X的128条通道足够。但要确认主板布线是”星型”还是”菊花链”,星型拓扑P2P延迟更均匀
- 散热压力:四卡水冷的管路复杂度翻倍,漏水风险增加。建议用快插接头(Quick Disconnect),维护方便
- 电源选择:别用消费级电源,得用服务器级冗余电源,带PMBus监控,能实时看功耗和电压波动
5.4 集群级:多节点并行/企业级AI基础设施
适用场景:
- 分布式训练,DDP(Distributed Data Parallel)跨多节点,训练GPT级别的大语言模型
- 高性能计算(HPC),MPI并行跨节点跑CFD、MD、气候模拟
- 企业私有云,多租户GPU虚拟化(NVIDIA vGPU、MIG)
- 作为超算中心的登录节点或开发节点
核心配置:
到这个级别,单台工作站的配置已经没有意义了,需要考虑的是集群架构设计。但如果是用Xeon 6系列作为单个计算节点(Compute Node),配置如下:
| 配件 | 规格 | 说明 |
|---|---|---|
| CPU | 2× Xeon 6980P 或更高 | 双路32核或以上,确保每个GPU都有足够的CPU核心服务 |
| 内存 | 512GB-1TB DDR5-6400 | 大内存用于MPI通信缓冲、大模型参数存储 |
| GPU | 8× A100/H100 SXM4/SXM5 | 八卡方案,NVLink全互联,带宽900GB/s |
| 散热 | 液冷整机柜 | 不是水冷,是液冷,冷却液直接进机架 |
| 网络 | 2× ConnectX-7 400Gb/s InfiniBand | 双网卡冗余,NCCL通信走IB |
| 存储 | 并行文件系统,Lustre或BeeGFS | 几百GB/s的聚合带宽,支持 thousands of clients |
| 电源 | 机柜级PDU,三相电输入 | 单节点功耗可能3000W+,整机柜30kW起步 |
避坑要点:
- 658X在这个级别已经不够看了,得用Xeon 6系列(Granite Rapids-AP,最多128核)或者AMD EPYC 9004系列(96核)
- 网络是集群的命脉,别省钱用10GbE,至少得100GbE,最好是InfiniBand HDR或NDR
- 存储比计算更贵,Lustre的OSS(对象存储服务器)和MDS(元数据服务器)需要单独规划
六、避坑指南:那些年我们交过的学费
6.1 GPU显存与CPU内存配比
黄金比例:CPU内存 ≥ 2 × 总GPU显存
为什么?因为在混合精度训练、大batch训练、或者模型并行时,CPU内存需要缓冲:
- 优化器状态(Adam的一阶、二阶动量)
- 数据预处理的中间结果
- 梯度卸载(Gradient Offloading)时的临时存储
实例:四张RTX 4090,总显存96GB。CPU内存至少192GB,建议256GB。
反例:有人配了双4090(48GB显存)但只有64GB内存,跑大模型时OOM不是发生在GPU上,而是CPU内存耗尽,系统直接杀掉进程。
6.2 PCIe Lane分配陷阱
主板厂商喜欢玩文字游戏。标称”支持4个PCIe 5.0 x16″,实际可能是:
- 2个PCIe 5.0 x16(CPU直连)
- 2个PCIe 5.0 x8(CPU直连)
- 或者4个PCIe 4.0 x16(经过芯片组降速)
务必确认:每个插槽的通道数和协议代际,以及是否与其他设备共享带宽(比如M.2插槽和某个PCIe插槽共用x4带宽)。
6.3 电源功率余量计算
别信电源厂商的”标称功率”,得看”12V输出功率”和”峰值功率承受能力”。
计算方法(修正后):
总功耗 = CPU TDP × 1.3(超频系数) + GPU TDP × 1.2-1.3(瞬时功耗系数) + 100W(其他配件)
电源功率 = 总功耗 × 1.2(余量系数)
实例:658X超频后350W,双4090各450W。
350×1.3 + 450×1.25×2 + 100 = 455 + 1125 + 100 = 1680W
1680 × 1.2 = 2016W
所以2000W电源在这种极限负载下是合适的,采用1.5倍系数会导致配置过度浪费。
6.4 散热与噪音的妥协
双水冷双水泵,满载时的噪音级别:
- 水泵:D5满速时约40-45dB(A计权),两个就是45-50dB
- 风扇:8把140mm风扇,满速2000RPM,约50-55dB
- 总和:55-60dB,相当于普通对话音量,放办公室没问题,放卧室晚上有点吵
解决方案:
- 设置风扇曲线,CPU/GPU低于60°C时风扇和水泵都降速到50%
- 用隔音棉包裹机箱侧板(别包散热孔)
- 把工作站扔隔壁房间,用KVM延长线接显示器键盘
6.5 软件生态与驱动兼容性
Linux用户注意:
- 内核版本建议6.6 LTS或6.12 LTS(已修正),太旧的内核(5.15/6.1)对Granite Rapids架构支持不完整
- CUDA版本和PyTorch/TensorFlow版本的对应关系要查清楚,别装了个CUDA 12.4但PyTorch只支持到12.1
- Intel的oneAPI、OpenVINO工具包对658X的AVX-512和AMX支持很好,但配置起来有点繁琐,建议用Intel官方Docker镜像
Windows用户注意:
- Windows 11 Pro for Workstations支持ReFS文件系统和更多CPU核心数
- WSL2在Windows下跑深度学习性能不错,但PCIe直通(P2P通信)可能有5-10%的性能损失
- 别用家庭版,最多支持64核,658X的48线程刚好踩线,但万一以后升级更多核就麻烦了
七、竞品对比:658X vs AMD Threadripper Pro
7.1 核心规格对比
| 参数 | Intel Xeon 658X | AMD TR Pro 7985WX |
|---|---|---|
| 核心/线程 | 24核48线程 | 64核128线程 |
| 基础频率 | 3.0GHz | 2.3GHz |
| 睿频/加速 | 4.9GHz | 5.1GHz |
| L3缓存 | 144MB | 256MB |
| TDP | 250W | 350W |
| 内存通道 | 8通道DDR5-6400 | 8通道DDR5-6400(官方标称) |
| 最大内存 | 4TB | 2TB |
| PCIe通道 | 128条PCIe 5.0 | 128条PCIe 4.0 |
7.2 应用场景优劣
选658X的情况:
- 需要PCIe 5.0带宽(比如用H100、ConnectX-7网卡)
- 单线程性能敏感(CAD前处理、小规模Python脚本)
- 内存带宽要求高(DDR5-6400 vs 5200,快23%)
- 需要Intel生态(MKL数学库、Intel编译器优化、某些企业软件只支持Intel)
选7985WX的情况:
- 纯多核并行任务(渲染农场、大规模MPI并行)
- 核心数就是正义(64核在某些场景直接碾压24核)
- 需要AMD的某些特性(比如AMD的3D V-Cache版本,L3缓存巨大)
- 预算充足且不在乎功耗(350W TDP需要更暴力的散热)
7.3 性价比结论
对于大多数AI训练/科学计算用户,658X的甜点配置(24核+高主频+PCIe 5.0+高频内存)更实用。7985WX的64核在并行度不高的任务里很多核心会闲着,而且基础频率太低(2.3GHz),单线程任务会卡脖子。
但如果你是做渲染、视频编码、大规模并行模拟,7985WX的核心数优势能发挥出来,这时候658X的24核可能成为瓶颈。
八、结语:24核,刚刚好
Intel Xeon 658X不是一颗完美的处理器。它没有AMD线程撕裂者那样的核心数碾压,也没有消费级i9那样的性价比。但它在单核性能、内存带宽、PCIe扩展性这三个维度上找到了一个精妙的平衡点。
对于AI训练工作站和科学计算平台来说,24核48线程是一个”甜点”配置:
- 足够喂饱1-4张高端GPU,不会成为数据预处理的瓶颈
- 8通道DDR5-6400提供了充裕的内存带宽,支撑大模型训练时的参数交换
- 128条PCIe 5.0通道为下一代GPU(Blackwell架构)和高速存储/网络留足了余量
- 250W的TDP配合双水冷双水泵方案,能稳定超频压榨性能
搭配UltraLab的散热结构,658X能在安静、稳定的状态下长期运行,这对于动辄训练几天几周的大模型任务来说,比跑分数字更重要。
最后提醒一句:买工作站不是买CPU,是买一个能解决问题的完整系统。658X是好马,但还需要好鞍(主板)、好缰绳(散热)、好粮草(内存/存储/显卡)才能跑起来。别在配件上省钱,省下的钱最后都会变成停机调试的时间成本。












