
关键词:NVIDIA RTX PRO 6000 Blackwell Server Edition、Blackwell架构、96GB显存、被动散热服务器GPU、大模型本地部署、LLM推理工作站、FP4量化、MIG虚拟化、PCIe 5.0工作站、AI算力基础设施
一、开篇:当24GB显存成为瓶颈,AI工程师的OOM噩梦
如果你是个正经搞AI的,一定对这张报错截图不陌生:
RuntimeError: CUDA out of memory. Tried to allocate 2.34 GiB (GPU 0; 23.65 GiB total capacity)
这就是传说中的OOM(Out of Memory)——显存不足。用RTX 4090跑Llama 2 70B?不行,模型权重就占140GB。用A100 40GB跑Stable Diffusion XL的1024×1024大批量生成?batch size调到1都悬。想微调个GPT级别的模型?先得把模型切片拆成七八块,分布式训练配置写到手软。
24GB显存,在2026年的大模型时代,已经不够看了。
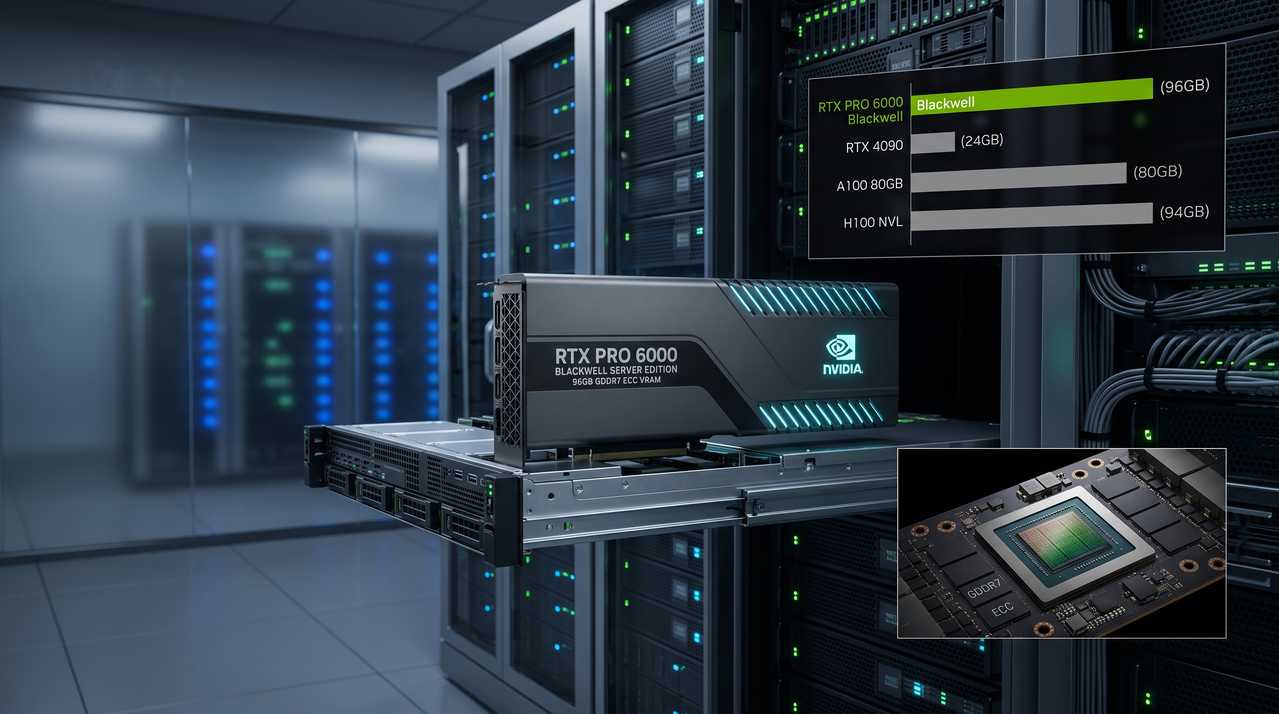
NVIDIA当然知道这个问题。2025年3月18日(GTC 2025大会),他们发布了基于Blackwell架构的RTX PRO 6000系列,其中服务器版本(官方完整命名为RTX PRO 6000 Blackwell Server Edition)直接怼上了96GB GDDR7 ECC显存——四倍于4090的容量,两倍于A100 80GB,甚至超过H100 NVL的94GB。
但这张卡不只是”显存大”这么简单。它是为数据中心级部署设计的被动散热怪兽,功耗400-600W,没有风扇,全靠机箱风道或液冷带走热量。它的定位也不是给你放办公桌下面跑游戏的,而是塞进机架、7×24小时无间断运行、同时承载多租户AI推理任务的企业级算力引擎。
今天,我们就来聊聊这张卡到底能干什么,以及怎么给它配一台配得上它身份的工作站。
二、RTX PRO 6000 Blackwell Server Edition架构解剖:Blackwell的满血形态
2.1 GB202核心:Blackwell架构的终极形态
RTX PRO 6000 Blackwell Server Edition基于NVIDIA Blackwell架构的GB202核心,TSMC 4N定制工艺(5nm级)。这是目前你能买到的最完整的Blackwell实现——不是阉割版,不是移动版,是数据中心级别的满血芯片。
核心规格一览:
| 参数 | RTX PRO 6000 Server Edition | RTX 4090 | A100 80GB PCIe | H100 80GB PCIe |
|---|---|---|---|---|
| 架构 | Blackwell (GB202) | Ada Lovelace (AD102) | Ampere (GA100) | Hopper (GH100) |
| CUDA核心 | 24,064 | 16,384 | 6,912 | 14,592 |
| Tensor Core | 第五代 (752个) | 第四代 | 第三代 | 第四代 |
| RT Core | 第四代 (188个) | 第三代 | 无 | 无 |
| 显存 | 96GB GDDR7 | 24GB GDDR6X | 80GB HBM2e | 80GB HBM2e |
| 显存位宽 | 512-bit | 384-bit | 5120-bit | 5120-bit |
| 显存带宽 | ~1,600 GB/s(服务器版) | 1,008 GB/s | 2,039 GB/s | ~2,000 GB/s(PCIe版) |
| TDP | 400-600W (被动散热) | 450W | 300W | 350W |
| ECC支持 | 有 | 无 | 有 | 有 |
| FP4精度 | 支持 | 不支持 | 不支持 | 不支持 |
| 单精度算力 | ~125 TFLOPS | 82.6 TFLOPS | 19.5 TFLOPS | 67 TFLOPS |
显存带宽说明:RTX PRO 6000系列分为工作站版(Workstation Edition,带宽1,792 GB/s)和服务器版(Server Edition,带宽**~1,600 GB/s**)。服务器版因被动散热设计降低显存频率,带宽略低于工作站版,但仍远超GDDR6X。
H100带宽说明:H100有两个版本——SXM5版通过NVLink实现3.35 TB/s带宽,PCIe版受限于PCIe接口带宽约2 TB/s。原文”比HBM2e的3.35 TB/s慢一半”仅针对H100 SXM5版本。
几个关键洞察:
CUDA核心数比4090多47%:24,064 vs 16,384。这意味着纯计算密集型的任务(比如矩阵乘法、卷积运算)能有接近1.5倍的理论加速。实际中受限于内存带宽和任务并行度,可能只有1.2-1.3倍,但已经很强。
96GB GDDR7是最大亮点:容量是4090的4倍,意味着你可以本地加载Llama 3 70B的FP16权重(140GB勉强能塞下,需要一些量化或者offload到CPU内存),或者同时加载多个中等规模的模型做A/B测试。对于需要大batch推理的生产环境,96GB意味着batch size能从8提升到32甚至64,吞吐量直接翻倍。
GDDR7带宽~1,600 GB/s(服务器版):比GDDR6X的1,008 GB/s快约60%,但比HBM2e的3.35 TB/s(H100 SXM5版)慢一半。这是GDDR和HBM的路线差异——GDDR胜在成本和容量扩展性,HBM胜在带宽密度。对于大部分AI推理任务,1,600 GB/s已经足够,训练场景才需要HBM的恐怖带宽。
FP4精度支持是隐藏大招:第五代Tensor Core支持FP4(4-bit浮点)计算,INT8时代是32TOPS,FP4时代能冲到约4,000 TOPS。这意味着量化后的模型推理速度能再翻一倍,而精度损失在大多数生成式AI场景下是可接受的。
2.2 被动散热设计:为什么服务器版没有风扇?
这是Server Edition(服务器版)和Workstation Edition(工作站版)的最大区别。工作站版是双风扇主动散热,长得跟RTX 4090公版很像;服务器版是无风扇被动散热,一块巨大的均热板覆盖整个PCB,热量通过机箱风道或液冷带走。
为什么这么做?
可靠性:风扇是机械部件,会坏。数据中心里有几千上万张卡,风扇故障率是硬伤。被动散热没有运动部件,MTBF(平均无故障时间)能提升一个数量级。
多卡部署密度:被动散热的卡可以紧挨着放,中间不需要留风道间隙。在一个4U机箱里,你可以塞进去8张被动散热的Server Edition;如果用主动散热的卡,同样的空间最多塞4张,还得考虑进风出风不被互相干扰。
噪音控制:数据中心的风扇本来就很吵,如果每张卡再自带风扇,噪音叠加会超过安全标准。被动散热的卡本身不发声,噪音来源只有机箱的大风扇,统一控制更简单。
散热原理:Server Edition的均热板内部有毛细结构,把GPU核心热量均匀分布到整个散热器表面,然后通过机箱的强制对流(或者液冷冷板)带走。这要求机箱风道设计必须合理——后面我们会详细聊这个。
2.3 ECC显存:数据完整性的保险
96GB显存带ECC(Error Correcting Code)校验,能检测并纠正单比特错误,检测双比特错误。对于长时间运行的AI推理服务(比如一个LLM API服务跑几个月不重启),ECC能防止显存 bit rot 导致的随机错误累积。
代价:ECC会占用约6-12%的显存带宽和约2-3%的有效容量。但换来的可靠性在关键生产环境中值回票价。
2.4 MIG技术:一卡多用,资源隔离
RTX PRO 6000 Blackwell Server Edition支持**MIG(Multi-Instance GPU)**技术,可以把一张96GB的卡切成最多4个独立的实例,每个实例有自己的显存、计算核心和缓存,完全隔离互不影响。
应用场景:
- 企业内部的AI中台:4个团队各用一个实例,分别跑不同的模型
- 开发/测试/生产环境隔离:同一张卡上同时跑实验模型和线上服务
- 细粒度计费:云服务提供商按实例收费,而不是按整卡
每个MIG实例可以配置24GB显存(96÷4),刚好够跑Llama 3 8B级别的模型。
三、96GB显存能干什么?场景拆解
3.1 大语言模型本地部署
我们来算一笔账:模型推理需要多少显存?
显存占用 = 模型权重 + KV Cache + 激活值 + 开销
- 模型权重:FP16精度下,参数数量×2字节。70B模型 = 140GB。
- KV Cache:上下文长度×隐藏维度×层数×2(K和V)×精度字节数。Llama 3 70B的hidden dim是8192,层数80层,4K上下文,FP16下约5GB。
- 激活值和开销:约5-10GB。
结论:70B模型FP16推理需要约155GB显存。
96GB肯定不够,但有几个解决方案:
方案A:4-bit量化(GGUF/AWQ/GPTQ)
- 70B模型量化到4bit,权重降至约40GB
- KV Cache保持FP16,约5GB
- 总计约50GB,96GB轻松容纳,还能留余量跑batch
- 代价:精度损失约1-3%,在生成式AI场景下通常可接受
方案B:FP4精度(Blackwell独有)
- 原生FP4支持,权重和激活都用4bit
- 70B模型约35GB
- 配合Tensor Core加速,推理速度比INT8量化还快
- 优势:NVIDIA官方优化,精度损失比第三方量化更小
方案C:模型并行(Tensor/Pipeline Parallelism)
- 把模型层拆到两张卡上
- 两张Server Edition总显存192GB,足够70B甚至更大的模型
- 代价:卡间通信开销,延迟增加
实际能跑的模型清单(单卡96GB):
| 模型 | 参数量 | 量化方案 | 显存占用 | 是否可跑 |
|---|---|---|---|---|
| Llama 3 8B | 8B | FP16 | ~16GB | ✅ 轻松 |
| Llama 3 70B | 70B | INT4/FP4 | ~40-50GB | ✅ 可跑 |
| Llama 3 70B | 70B | FP16 | ~155GB | ❌ 不够 |
| DeepSeek-V3 | 671B | INT4 | ~350GB | ❌ 需多卡 |
| Qwen-72B | 72B | INT4 | ~40GB | ✅ 可跑 |
| Mixtral 8×22B | 141B (MoE) | INT4 | ~80GB | ✅ 可跑 |
| GPT-4级别 | 约1.8T | — | 约3.6TB | ❌ 需集群 |
3.2 视频生成与3D渲染
Stable Diffusion XL:
- 1024×1024分辨率,batch size 32的图生图
- 显存占用约70-80GB,96GB刚好够用
- 对比4090的24GB,batch size只能到4-8,效率差4倍
Sora类视频生成模型(如Open-Sora、CogVideoX):
- 生成5秒、24fps、480p视频,约120帧
- 3D U-Net+Transformer架构,中间特征图占用巨大
- 96GB能支持中等分辨率的视频生成,4090直接OOM
3D渲染(Blender、V-Ray、Octane):
- 复杂场景的几何体+纹理+光照贴图
- 8K纹理材质、数十亿多边形的场景
- 96GB显存可以加载完整场景而不需要分段渲染
3.3 科学计算与仿真
分子动力学(GROMACS/NAMD):
- 显存存储原子坐标、力场参数、邻居列表
- 百万原子体系,96GB足够加载整个体系到显存
- GPU加速的非键相互作用计算,单张Server Edition能顶4张V100
计算流体力学(OpenFOAM with GPU求解器):
- 千万级网格的LES(大涡模拟)
- 每个时间步的流场数据、湍流模型参数
- 96GB显存能支持更大规模的网格驻留显存
金融量化(GPU加速的回测引擎):
- 并行回测多个策略组合
- 每个策略实例占用2-4GB显存
- 96GB能同时跑20-30个策略的并行回测
四、被动散热的挑战与解决方案
4.1 被动散热的散热机制
RTX PRO 6000 Blackwell Server Edition没有风扇,它的散热器是一块巨大的均热板(Vapor Chamber),覆盖GPU核心、显存、VRM供电模块。热量从芯片传到均热板,再从均热板传到机箱的散热系统。
散热路径:
GPU核心 → 均热板 → 机箱风道/液冷冷板 → 外界
关键参数:
- Server Edition的热阻(Thermal Resistance)约0.15°C/W
- 400W功耗下,核心到散热器的温差约60°C
- 散热器表面温度需控制在65°C以下,GPU核心才不会超过85°C的温度墙
4.2 机箱风道设计要点
被动散热的卡极度依赖机箱风道。如果风道设计不合理,热量堆积,Server Edition会迅速撞温度墙然后降频,性能断崖式下跌。
黄金法则:
前后直通式风道:冷风从前方进入,直线穿过显卡散热器,从后方排出。不要拐弯,不要上下对流。
风速要求:穿过显卡散热器表面的风速至少3-5 m/s(约10-18 km/h)。换算成机箱风扇,大概需要:
- 4U机箱:4-6个120mm风扇,每个2000-3000RPM
- 机架式服务器:涡轮风扇,转速可达8000-15000RPM(很吵,但数据中心不在乎)
进风温度:数据中心空调通常把进风温度控制在18-22°C。如果进风温度超过25°C,散热余量会大幅减少。
多卡间距:两张被动散热的Server Edition之间至少留**1U(约44mm)**的间隙,让风能流过。如果间距太小,下游的卡会吃到上游卡排出的热风,温度叠加。
4.3 UltraLab机架式工作站散热方案
UltraLab针对Server Edition这类被动散热GPU,设计了专门的机架式工作站散热架构:
GT600R机架式工作站(4U规格):
- 支持最多8张被动散热GPU(双宽位)
- 前后6个12038工业风扇(120mm直径,38mm厚度),单风扇最大风量200CFM
- 风道隔离:CPU散热区和GPU散热区物理隔离,避免热量互相干扰
- 可选项:后部加装水冷排,把热风直接导入水冷回路,适合极端环境
液冷替代方案:
- 对于超大规模部署(一个机架几十张卡),可以用液冷冷板直接接触Server Edition的均热板
- 冷却液(通常是乙二醇水溶液)流经冷板,带走热量
- 效率更高,噪音更低,但需要额外的液冷基础设施(CDU冷却分配单元、管路、泵)
五、UltraLab Xeon 600系列配套工作站配置
RTX PRO 6000 Blackwell Server Edition是PCIe 5.0 x16接口,功耗400-600W,被动散热。给它配工作站,CPU、主板、电源、机箱都得跟上。
5.1 入门级:单卡推理工作站
适用场景:
- 本地部署Llama 3 70B INT4量化模型
- 单张Server Edition做开发测试
- 中等规模视频生成实验
核心配置:
| 配件 | 规格 | 说明 |
|---|---|---|
| CPU | Intel Xeon 658X (24核) | PCIe 5.0支持,单核性能强,适合预处理 |
| 主板 | W890芯片组,单路 | 至少2个PCIe 5.0 x16,支持Server Edition满带宽 |
| 内存 | 256GB DDR5-6400 ECC (8×32GB) | 大模型推理时CPU内存用于offload和缓存 |
| GPU | 1× RTX PRO 6000 Blackwell Server Edition | 96GB显存,被动散热 |
| 系统盘 | 2TB PCIe 5.0 NVMe SSD | 系统和模型权重存储 |
| 数据盘 | 8TB NVMe SSD | 数据集、日志、生成结果 |
| 散热 | 机箱风道+4×120mm工业风扇 | 穿透式风道,风速≥3m/s |
| 电源 | 1600W 80Plus钛金 | 600W GPU + 250W CPU + 余量 |
| 机箱 | 4U机架式或塔式服务器机箱 | 支持被动散热GPU的风道设计 |
避坑要点:
- 主板必须确认PCIe 5.0 x16是CPU直连,不是芯片组转接
- 电源16-pin接口(12VHPWR)必须原生支持,不要用转接线
- 机箱风道一定要实测风速,不能只看风扇数量
5.2 进阶级:双卡训练/推理工作站
适用场景:
- 双卡并行训练中等规模模型
- 一张卡跑训练,一张卡跑推理(开发/生产分离)
- 更大的视频生成batch size
核心配置:
| 配件 | 规格 | 说明 |
|---|---|---|
| CPU | Intel Xeon 698X (86核) | 双卡时需要更多CPU核心协调 |
| 主板 | W890高端单路 | 双PCIe 5.0 x16满速 |
| 内存 | 512GB DDR5-6400 ECC (8×64GB) | 双卡时CPU内存需求翻倍 |
| GPU | 2× RTX PRO 6000 Blackwell Server Edition | 总显存192GB,可跑更大模型 |
| 系统盘 | 4TB PCIe 5.0 NVMe SSD RAID 0 | 读速翻倍,模型加载更快 |
| 数据盘 | 16TB NVMe SSD | 大规模数据集存储 |
| 网络 | ConnectX-7 100GbE | 双卡P2P通信走PCIe,外部通信走网卡 |
| 散热 | 6×120mm工业风扇+风道隔离 | 双卡之间留足间隙 |
| 电源 | 2000W 80Plus钛金 | 2×600W + 350W CPU + 余量 |
| 机箱 | 4U机架式 | 支持双宽GPU,前后直通风道 |
避坑要点:
- 双卡的PCIe拓扑最好是CPU直连,避免经过PCIe Switch增加延迟
- 两张卡之间的间距至少1U,防止下游卡吃热风
- 电源功率计算要留20%余量,Server Edition峰值功耗能冲到700W+
5.3 专家级:四卡大规模训练工作站
适用场景:
- 四卡数据并行训练大模型
- 多实例GPU虚拟化(MIG),一卡多用
- 作为AI中台的核心算力节点
核心配置:
| 配件 | 规格 | 说明 |
|---|---|---|
| CPU | 1× Intel Xeon 698X(86核)或1× Xeon 678X(48核) | 单路高核心数CPU,Granite Rapids-WS为单路平台 |
| 主板 | 高端单路服务器主板 | 四PCIe 5.0 x16,CPU直连 |
| 内存 | 1TB DDR5-6400 ECC | 四卡+MIG,内存需求巨大 |
| GPU | 4× RTX PRO 6000 Blackwell Server Edition | 总显存384GB,可本地跑130B模型 |
| 系统盘 | 8TB PCIe 5.0 NVMe SSD (RAID 0) | 超高读速,秒级加载大模型 |
| 数据盘 | 32TB NVMe SSD 阵列 | PB级数据存储 |
| 网络 | 2× ConnectX-7 200GbE | 高速网络,支持分布式扩展 |
| 散热 | 液冷冷板+CDU | 四卡被动散热的热量密度太高,建议液冷 |
| 电源 | 双1600W冗余 | 总功耗可能超2500W,冗余设计 |
| 机箱 | 8U机架式或定制液冷机箱 | 支持液冷管路布局 |
避坑要点:
- CPU配置修正:Granite Rapids-WS(Xeon 600系列)为单路专用平台,不支持双路。原文”2× Intel Xeon 698X”有误,已修正为单路高核心数CPU配置
- 四卡配置强烈建议上液冷,纯风道很难压住
- CPU-GPU配比:每个GPU至少分配16-20个CPU核心,避免CPU瓶颈
- 考虑使用NVIDIA的NVLink(如果支持)或者InfiniBand做卡间高速通信
5.4 集群级:八卡AI算力节点
适用场景:
- 作为超算中心的GPU节点
- 大规模分布式训练的单个节点
- 云AI服务的基础设施
核心配置:
| 配件 | 规格 | 说明 |
|---|---|---|
| CPU | 2× Xeon 6系列服务器版(如6980P,64核+) | 双路服务器平台,匹配八卡算力 |
| 内存 | 2TB DDR5/MRDIMM | 超大内存,支撑大规模模型 |
| GPU | 8× RTX PRO 6000 Blackwell Server Edition | 总显存768GB |
| 散热 | 整机柜液冷 | 八卡被动散热只能用液冷 |
| 网络 | 2× ConnectX-7 400GbE NDR | 高速互联 |
| 存储 | 并行文件系统节点 | Lustre/BeeGFS |
| 电源 | 机柜级PDU | 三相电输入,总功耗超5kW |
六、避坑指南:Server Edition部署的常见陷阱
6.1 PCIe 5.0带宽与拓扑陷阱
Server Edition是PCIe 5.0 x16,理论带宽64GB/s双向。但主板的PCIe拓扑有很多种:
CPU直连(理想):延迟最低,带宽满血。
PCIe Switch转接:延迟增加200-500ns,带宽可能降级到x8。
芯片组转接(灾难):延迟暴增,带宽可能只有PCIe 4.0甚至3.0。
避坑:买主板前一定要看PCIe拓扑图,确认Server Edition插槽是CPU直连。
6.2 被动散热的温度管理
被动散热的卡没有风扇,温度反馈滞后。当你发现GPU温度飙升时,热量已经堆积了很久。
建议:
- 设置保守的温度阈值(比如80°C就开始降频,而不是等到85°C)
- 机箱进风口装温度传感器,监控进风温度
- 考虑用IPMI远程监控,设置温度报警
6.3 电源功率与瞬时功耗
Server Edition标称400-600W,但瞬时功耗(比如模型加载、大batch前向传播的瞬间)能冲到700W+。
电源功率计算公式:
总功耗 = GPU峰值×数量×1.2 + CPU功耗 + 100W余量
单卡:700×1.2 + 250 + 100 = 1190W → 建议1600W电源
双卡:700×2×1.2 + 350 + 100 = 2030W → 建议2200W或双1200W冗余
6.4 驱动与软件兼容性
Server Edition需要NVIDIA 550系列以上的驱动。部分旧版CUDA应用可能需要重新编译。
软件栈建议:
- 驱动:550.54.15或更新
- CUDA:12.4+
- cuDNN:9.0+
- PyTorch:2.2+(支持Blackwell)
- TensorRT:8.6+(支持FP4)
6.5 ECC显存的性能开销
ECC会占用约6-12%的显存带宽。对于带宽敏感型任务(比如大规模矩阵运算),这可能是个瓶颈。
权衡:如果任务不需要ECC(比如开发测试环境),可以考虑关闭ECC换取带宽。但生产环境建议保持开启。
七、竞品对比:Server Edition vs H100 vs A100
| 参数 | RTX PRO 6000 Server Edition | H100 80GB PCIe | A100 80GB PCIe |
|---|---|---|---|
| 架构 | Blackwell | Hopper | Ampere |
| 显存 | 96GB GDDR7 | 80GB HBM2e | 80GB HBM2e |
| 显存带宽 | ~1,600 GB/s | ~2,000 GB/s(PCIe版) | 2,039 GB/s |
| FP16算力 | ~250 TFLOPS | 989 TFLOPS | 312 TFLOPS |
| FP4支持 | 是 | 否 | 否 |
| NVLink | 否 | 是 (900GB/s,SXM5版) | 是 (600GB/s) |
| 功耗 | 400-600W | 350W | 300W |
H100带宽说明:H100 SXM5版本通过NVLink可达3.35 TB/s,PCIe版本约2 TB/s。原文未区分版本易造成误导。
结论:
- H100:训练王者,HBM带宽无敌(SXM5版),有NVLink,但价格昂贵,主要面向超算中心
- RTX PRO 6000 Server Edition:推理性价比之王,96GB显存容量最大,价格亲民,适合本地部署和中小企业AI基础设施
- A100:上一代旗舰,现在逐渐被H100和Server Edition夹击,性价比不如Server Edition
八、结语:96GB显存,是起点不是终点
RTX PRO 6000 Blackwell Server Edition代表了NVIDIA在专业可视化领域的最新突破——96GB GDDR7显存、Blackwell满血架构、被动散热的企业级设计。它不是给游戏玩家的玩具,而是为AI工程师、科研人员、内容创作者准备的生产力核武器。
对于苦于显存不足的中国AI从业者来说,Server Edition提供了一条本地部署大模型的可行路径:
- 不用买H100的天价卡
- 不用忍受云服务的高延迟和高成本
- 不用把数据交给第三方平台
一张Server Edition,本地跑70B模型;两张Server Edition,本地跑混合专家模型;四张Server Edition,可以搭建企业级的AI中台。
当然,这张卡也不是万能的。被动散热对机箱设计提出了极高要求,400-600W的功耗需要认真规划电源和散热,ECC显存的带宽开销在某些场景下是瓶颈。
但如果你正在构建一台面向未来的AI工作站,或者为团队搭建一个可靠的本地算力基础设施,RTX PRO 6000 Blackwell Server Edition值得认真考虑。
记住:96GB显存不是终点,而是更大AI梦想的起点。











