
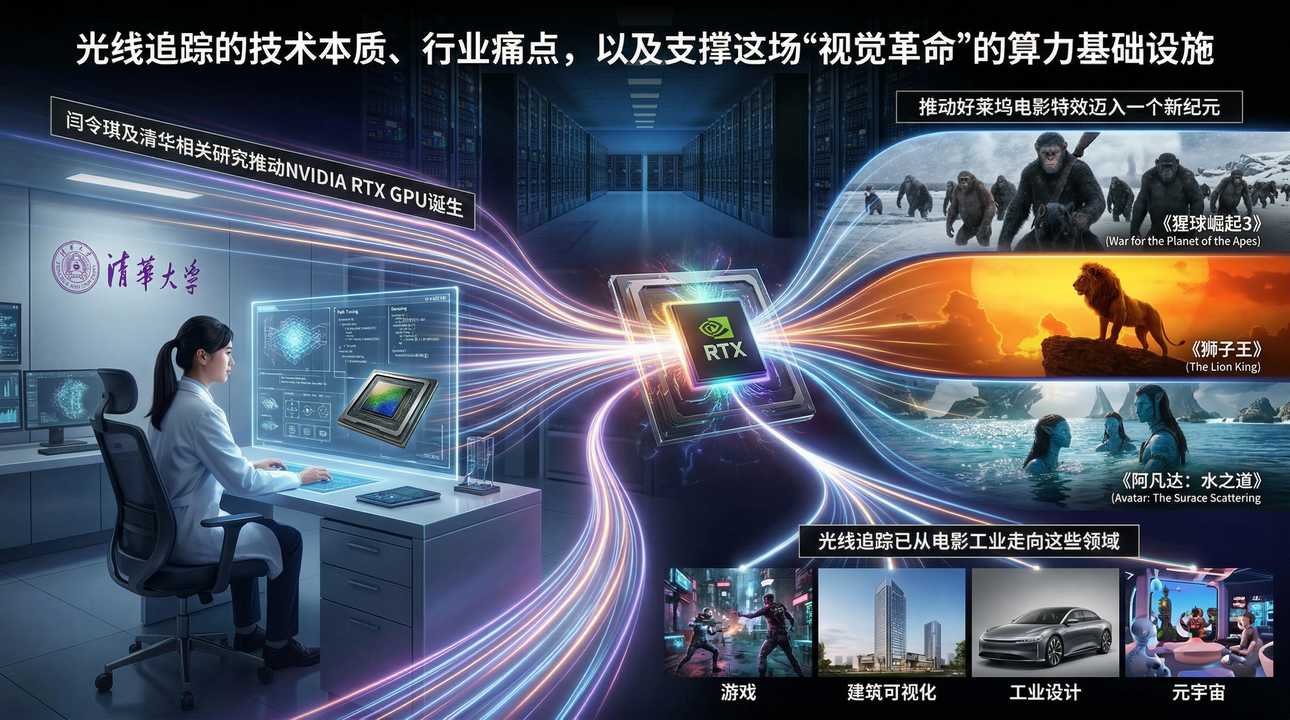
引言:当”渲染”成为一门艺术
2018年,电影《猩球崛起3:终极之战》获得奥斯卡最佳视觉效果奖提名。观众惊叹于片中猩猩毛发在雨林光线下逼真的反射效果,却不知道这项技术背后,有一位来自清华的”80后”科学家——闫令琪。
闫令琪,清华大学计算机系2009级本科生,2013年赴加州大学伯克利分校深造,2018年获博士学位。读博五年期间,他以第一作者身份发表了7篇SIGGRAPH论文,创下该领域最高纪录。2019年,他获得SIGGRAPH最佳博士论文奖,被官方盛赞”论文的每一章都可自成一篇博士论文”。
更重要的是,他在实时光线追踪方面的开创性研究,直接推动了NVIDIA RTX GPU架构的诞生。从《猩球崛起3》到《狮子王》再到《阿凡达:水之道》,他的技术让好莱坞电影特效迈入了一个新纪元。
今天,光线追踪已从电影工业走向游戏、建筑可视化、工业设计,甚至元宇宙。本文将以闫令琪及清华相关研究为线索,拆解光线追踪的技术本质、行业痛点,以及支撑这场”视觉革命”的算力基础设施。
一、光线追踪:从数学公式到视觉魔法
1.1 为什么光栅化不够用了?
传统实时渲染使用**光栅化(Rasterization)**技术——把三维场景投影成二维图像,然后用贴图和光照模型”假装”出真实感。这种方法快,但假:阴影边缘锐利、反射像贴纸、全局光照只能靠”烘焙”预制。
**光线追踪(Ray Tracing)**走的是另一条路:模拟真实物理世界中光线的传播。从相机(眼睛)出发,向每个像素发射光线,计算光线与场景中物体的交点,再追踪反射、折射、阴影,直到光线碰到光源或消失。
**渲染方程(Rendering Equation)**是这一切的数学基础,由James Kajiya在1986年提出:
L_o(p,ω_o) = L_e(p,ω_o) + ∫_Ω f_r(p,ω_i,ω_o) L_i(p,ω_i) (n·ω_i) dω_i
简单说:一个点的出射光 = 自发光 + 所有入射光经表面反射后的积分。这个积分方程没有解析解,必须用蒙特卡洛方法数值求解——随机采样光线路径,足够多的样本后,平均值收敛到真实解。
1.2 路径追踪:从”一眼假”到”以假乱真”
**路径追踪(Path Tracing)**是光线追踪的终极形态。它不区分”直接光照”和”间接光照”,而是让光线在场景中随机反弹,每条路径都是一串”相机→表面→表面→…→光源”的随机行走。
这种方法能自然产生:
- 软阴影:光源有一定面积,阴影边缘自然模糊
- 全局光照:墙面反射的光照亮角落(Color Bleeding)
- 焦散:光线穿过玻璃杯在桌面上形成的光斑
- 次表面散射:光线穿透皮肤、蜡等半透明材质
代价是计算量爆炸。一部电影级画面,可能需要每像素数千条路径,单帧渲染数小时。这也是为什么长期以来,路径追踪只用于离线渲染(如皮克斯的RenderMan)。
1.3 实时光线追踪:从”数小时”到”毫秒级”
闫令琪的研究突破了这一瓶颈。他提出的实时光线追踪算法,通过重要性采样、去噪重建、混合渲染等技术,将光线追踪加速到能在游戏帧率(60fps)下运行。
2018年,NVIDIA发布RTX系列显卡,首次在消费级硬件上实现硬件加速光线追踪。RTX的RT Core专门用于光线-三角形求交计算,而Tensor Core则用于AI去噪——用神经网络把少量采样的”噪点图”重建为平滑图像。
这不是巧合。闫令琪在博士期间就与NVIDIA深度合作,他的研究成果直接融入了RTX架构。从RTX 2080到RTX 4090,再到专业级的RTX 6000 Ada,实时光线追踪已成为高端GPU的标配。
二、算法本质:光线追踪是如何工作的?
2.1 光线-物体求交:渲染的”原子操作”
光线追踪的核心操作是:给定一条射线(起点+方向),找到场景中第一个与之相交的物体表面。
朴素的算法需要遍历所有三角形,复杂度O(N)。对于包含数百万三角形的电影场景,这不可接受。
加速结构是关键:
- BVH(Bounding Volume Hierarchy):用层次包围盒快速剔除不可能相交的区域
- KD-Tree:将空间递归分割,光线只遍历经过的节点
- 八叉树/网格:均匀空间划分,适合动态场景
现代GPU的RT Core本质上就是硬件加速的BVH遍历单元,能在每秒钟处理数十亿次光线-三角形求交。
2.2 材质与BSDF:光如何与表面交互
光线碰到表面后,如何反射?这由**BSDF(Bidirectional Scattering Distribution Function)**决定。
- 漫反射(Diffuse):光线向各个方向均匀散射,如混凝土、纸张
- 镜面反射(Specular):入射角等于反射角,如镜子、抛光金属
- 折射(Refraction):光线穿过透明介质发生偏折,遵循斯涅尔定律,如玻璃、水
- 次表面散射(SSS):光线进入材质内部,经过多次散射后穿出,如皮肤、蜡、牛奶
闫令琪在博士期间开创的微观结构精细渲染,能模拟真实材质的微表面模型(如迪士尼原则的BRDF),让虚拟物体的”质感”无限接近真实。
2.3 蒙特卡洛积分:用随机对抗维度诅咒
渲染方程是一个高维积分(对入射方向、波长、时间等积分)。维度越高,确定性数值积分越困难。
蒙特卡洛方法的威力在于:无论维度多高,随机采样的收敛速度都是O(1/√N)。虽然慢,但稳定可靠。
方差缩减技术用于加速收敛:
- 重要性采样:根据BRDF和光源分布采样,让”重要”的方向被更多采样
- 双向路径追踪(BDPT):同时从相机和光源发射路径,在中间连接
- 梅特波利斯光照传输(MLT):用马尔可夫链在路径空间随机游走,擅长处理复杂光照
2.4 有限元变形仿真:让虚拟物体”动起来”
光线追踪解决”看起来真”的问题,有限元变形仿真解决”动起来真”的问题。
在电影特效中,物体的变形(如布料飘动、肌肉伸缩、流体飞溅)需要物理准确的仿真。**有限元方法(FEM)**将连续物体离散为网格,求解弹性力学方程:
Mü + Ců + Ku = F
其中M是质量矩阵,C是阻尼矩阵,K是刚度矩阵,u是位移,F是外力。
对于大变形(如橡皮泥被捏扁),需要非线性有限元;对于实时应用(如游戏),需要简化模型或数据驱动方法(如用神经网络近似物理仿真)。
清华软件学院陈莉副教授的研究团队,长期致力于有限元网格剖分和CAE软件研发,其工作服务于城市结构工程地震灾害评估等国家级项目。
三、行业痛点:当渲染撞上物理极限
3.1 算力黑洞:渲染农场的”电表狂转”
痛点1:离线渲染的时间成本
皮克斯的《玩具总动员4》,单帧平均渲染耗时29小时。一部90分钟的电影,14万帧,即使动用数千台服务器组成的渲染农场,也需要数月时间。
痛点2:实时光追的”噪点困境”
游戏场景每帧只有16毫秒(60fps),只能发射少量光线(每像素1-4条)。结果是画面布满噪点,必须靠AI去噪。但去噪会丢失高频细节,产生”涂抹感”。
痛点3:内存墙
电影级场景的BVH加速结构可能占用数十GB显存。加上纹理、几何数据、帧缓冲,单卡24GB显存经常捉襟见肘。必须采用核外渲染(Out-of-Core),把数据分块加载。
3.2 内容创作的”最后一公里”
痛点4:材质制作的”手艺活”
真实的BSDF需要测量真实材质,或由美术师手工调节参数。一个复杂材质(如生锈金属、脏玻璃)可能需要数天调试。
痛点5:动画与仿真的耦合
变形物体的光照预计算失效。布料飘动时,阴影和高光必须动态更新,计算量剧增。
痛点6:跨平台一致性
电影特效公司使用RenderMan、Arnold等离线渲染器,游戏使用Unreal、Unity的实时引擎,两者视觉效果差异巨大。同一资产需要在两套流程中分别制作。
3.3 人才培养的”断层”
痛点7:图形学人才稀缺
光线追踪涉及线性代数、微积分、概率论、计算机体系结构等多学科知识。能同时理解”渲染方程的数学推导”和”GPU warp调度”的人才凤毛麟角。
闫令琪的GAMES101课程在B站有300万+播放量,侧面反映优质图形学教育的稀缺。
四、四级工作站配置方案:从学习到生产
方案一:教学演示级(本科生/爱好者)
适用场景:
- 学习光线追踪原理(手写CPU版本)
- 小规模路径追踪实验(<1000三角形)
- 材质与光照学习
核心配置:
- CPU:AMD Ryzen 9 9950X(16核32线程)
- 内存:64GB DDR5-5600(双通道)
- GPU:NVIDIA RTX 4070 Ti Super(16GB GDDR6X)
- 存储:1TB NVMe SSD
- 软件:Blender(Cycles渲染器)、Unity(URP/HDRP)、OptiX SDK
性能预期:
- 可渲染简单场景(单房间级别),离线路径追踪,数分钟至数十分钟一帧
- 实时光追游戏1080p中画质流畅运行
方案二:进阶级(独立创作者/小型工作室)
适用场景:
- 建筑可视化(ArchViz)
- 产品渲染(电商、工业设计)
- 动画短片制作
- 游戏开发(独立游戏)
核心配置:
- CPU:AMD Threadripper 7970X(32核64线程)
- 内存:256GB DDR5-4800 ECC(四通道)
- GPU:NVIDIA RTX 4090(24GB)×2,NVLink Bridge互联
- 存储:2TB NVMe Gen4 SSD + 8TB SATA SSD
- 网络:10GbE
性能预期:
- Blender Cycles渲染中等复杂度场景,单帧10-30分钟
- 支持Subsurface Scattering、Volume Rendering等高级效果
- 双卡NVLink可提供48GB统一显存,处理大型场景
关键考量:
- 显存容量:24GB是入门电影级制作的底线
- ECC内存:长时间渲染的数据完整性保障
方案三:专家级(影视特效/中大型工作室)
适用场景:
- 影视级特效镜头(VFX)
- 广告片渲染
- 虚拟现实(VR)内容制作
- 建筑可视化大型项目
核心配置:
- CPU:双路 AMD EPYC 9965(384核768线程)
- 内存:1TB DDR5-4800 ECC
- GPU:NVIDIA RTX 6000 Ada(48GB)×4,NVLink全互联
- 存储:4TB NVMe Gen5 SSD + 20TB可用容量(RAID6,原始容量约27TB)
- 网络:100Gb/s InfiniBand
性能预期:
- 支持RenderMan、Arnold、V-Ray等专业渲染器
- 可处理数百万多边形、数十GB纹理的电影级场景
- 支持GPU加速的有限元仿真(如NVIDIA Flex、FEMFX)
软件栈扩展:
- 渲染器:RenderMan、Arnold、V-Ray、Redshift
- DCC软件:Maya、Houdini、Blender、Cinema 4D
- 仿真:Houdini(PyroFX、Vellum)、RealFlow
方案四:集群级(渲染农场/大型视效公司)
适用场景:
- 好莱坞级电影特效
- 大型动画长片
- 云端渲染服务(Render-as-a-Service)
- 国家级超算中心
核心配置(单节点):
- CPU:双路 AMD EPYC 9965(384核768线程)×多节点
- 内存:每节点2TB DDR5-4800 ECC
- GPU:每节点NVIDIA RTX 6000 Ada(48GB)×8,NVLink全互联
- 存储:并行文件系统(Lustre/GPFS),PB级容量
- 网络:400Gb/s InfiniBand NDR
架构特点:
- 分布式渲染:管理数千个渲染节点,任务动态调度
- 云原生:支持Kubernetes编排,弹性扩缩容
- 混合渲染:CPU路径追踪 + GPU光栅化协同
参考基准:
工业光魔(ILM)、维塔数码(Weta Digital)的渲染农场拥有数万台服务器,单部电影渲染消耗上亿CPU核心小时。
五、避坑指南:渲染硬件选型八宗罪
坑1:忽视显存对复杂场景的制约
症状:场景加载到一半报错”CUDA out of memory”。
原因:电影级场景的纹理、几何、BVH可能超过24GB。RTX 4090的24GB在复杂场景面前捉襟见肘。
对策:
- 专业工作优先选择48GB显存的RTX 6000 Ada
- 使用核外渲染(Out-of-Core),但性能会下降
- 优化场景:压缩纹理、实例化重复物体、LOD分层
坑2:低估CPU在预处理中的角色
症状:GPU渲染时利用率低,发现是BVH构建太慢。
原因:场景导入时需要CPU构建加速结构(BVH/八叉树)。大型场景的BVH构建可能需要数分钟。
对策:
- 选择高主频、多核心CPU(如Threadripper/EPYC)
- 使用支持GPU加速BVH构建的渲染器(如OptiX)
坑3:混淆”实时预览”和”最终渲染”
症状:客户看了实时预览觉得效果好,最终渲染出来”感觉不一样”。
原因:实时预览为了速度,往往使用简化的光照模型和较低采样率。最终渲染需要数千采样,收敛后的图像更”干净”但也更”平”。
对策:
- 预览时使用”过度曝光”或”高对比度”设置,接近最终效果
- 与客户明确约定”参考品质”和”交付品质”的差异
坑4:忽视色彩管理
症状:显示器上看着正常的图,打印出来偏色;或者在另一台显示器上完全不同。
原因:没有统一的色彩空间(sRGB、Rec.709、ACES、线性工作流)。
对策:
- 建立完整的色彩管理流程(OCIO配置文件)
- 显示器定期校色(使用校色仪)
- 明确交付的色彩空间标准
坑5:存储I/O成为渲染瓶颈
症状:渲染农场大量节点空闲,等待从存储加载纹理。
原因:数百个渲染节点同时读取数TB的纹理数据,传统NAS带宽不足。
对策:
- 使用并行文件系统(Lustre、GPFS)
- 纹理本地化:渲染前将所需纹理拷贝到节点本地SSD
- 使用纹理缓存(如Mari、Substance的缓存机制)
坑6:忽视软件授权成本
症状:工作站配了50万,发现渲染软件授权一年30万。
常见软件费用参考:
- RenderMan:~1000美元/年/节点
- Arnold:~600美元/年/节点
- V-Ray:~800美元/年/节点
- Houdini FX:~7000美元/年
对策:
- 评估开源替代(Blender、LuxCoreRender)
- 利用渲染农场的”按需授权”(如AWS Thinkbox Deadline的Usage-based Licensing)
- 批量采购获取折扣
坑7:网络延迟影响分布式渲染
症状:多节点集群,加速比只有线性的一半。
原因:分布式渲染需要频繁同步光照缓存、光子图等数据。高延迟网络导致节点互相等待。
对策:
- 使用高速网络(100Gb/s InfiniBand)
- 优化任务粒度:减少节点间通信,增大每节点任务量
坑8:忽视散热和噪音
症状:8卡工作站满载,风扇噪音像飞机起飞,放在办公室无法忍受。
原因:RTX 4090满载功耗450W,8卡就是3600W,散热压力巨大。
对策:
- 专业机房:隔音机柜、精密空调
- 水冷方案:定制水冷降低噪音
- 远程工作:工作站放机房,通过远程桌面操作
六、前沿展望:光线追踪的下一站
6.1 神经渲染:AI重构渲染管线
**神经辐射场(NeRF)**用神经网络隐式表示三维场景,只需几张照片就能重建可渲染的3D模型。虽然当前质量还不如传统建模,但进展迅速。
闫令琪2022年带领学生获得SIGGRAPH最佳论文奖提名的工作,正是将神经网络与物理渲染结合,用AI预测复杂光照效果,加速蒙特卡洛收敛。
6.2 实时光追的”平民化”
随着AMD RDNA架构和Intel Arc显卡加入光追支持,以及主机平台(PS5、Xbox Series X)的普及,实时光线追踪正从高端PC走向主流设备。
Unreal Engine 5的Lumen全局光照系统,在主流硬件上实现了接近路径追踪的质量,预示着实时光追的”民主化”。
6.3 物理仿真的”数据驱动”
传统有限元仿真计算量大,难以实时。神经物理引擎(如NVIDIA的Physics-ML)用神经网络学习物理规律,在毫秒级时间内预测物体变形、流体流动。
清华智能产业研究院赵昊团队开发的MARS仿真器,结合神经渲染和物理仿真,为自动驾驶和机器人训练提供真实感环境。
6.4 云渲染与”元宇宙”
随着5G和云游戏发展,云端光线追踪成为可能。计算在云端完成,画面通过视频流推送到终端。这意味着手机也能”跑”电影级渲染。
但”元宇宙”的愿景——数百万用户同时在线的共享虚拟世界——对渲染和仿真提出了前所未有的挑战。这需要算法、硬件、网络基础设施的协同突破。
结语:算力是视觉艺术的”画笔”
从清华园到好莱坞,从SIGGRAPH论文到奥斯卡提名,闫令琪的轨迹证明了:在计算机图形学领域,算法创新可以定义工业标准。
光线追踪的演进,本质上是一场”用计算换真实感”的旅程。每一代GPU架构的进步,每一篇关于重要性采样的论文,每一次材质建模的突破,都在拓宽虚拟与现实的边界。
对于正在规划图形学工作站的研究者或创作者,建议遵循”渐进式投资”:
- 起步:利用Blender等免费工具,在RTX 4070级别硬件上验证创意
- 扩张:根据项目规模升级至RTX 4090或RTX 6000 Ada,支持更复杂的场景
- 规模化:当项目达到影视级,考虑渲染农场或云端渲染服务
毕竟,在这场视觉革命中,算得出的人,才能看见未来的样子。
免责声明:本文采用技术分析视角,文中提及的研究成果均来自公开学术文献和新闻报道。清华大学及相关院系与本文内容无商业关联,文中硬件配置建议仅供参考。












