
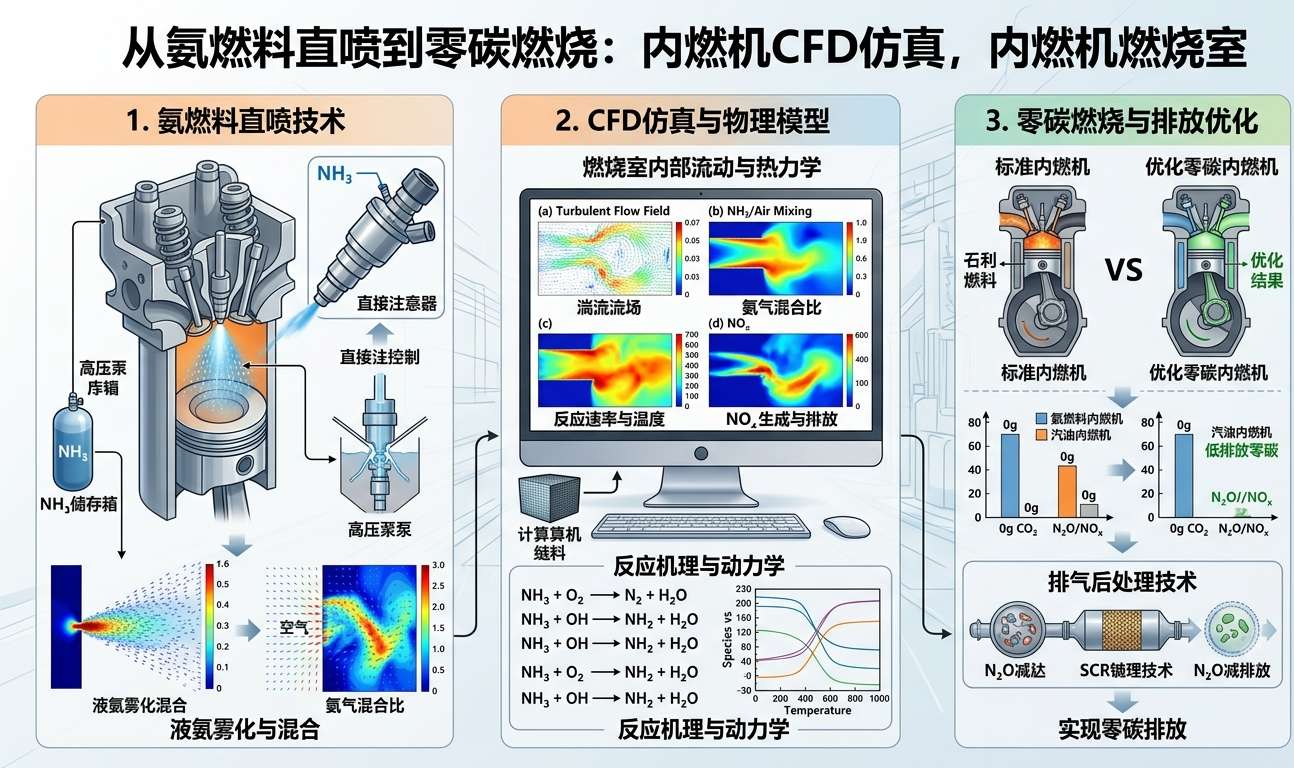
一、缸内燃烧的数字化副本
北京理工大学”动力工程及工程热物理”学科始建于1952年,是国家重点学科、国防特色学科,也是我国地面机动武器动力系统高层次人才的摇篮。这所学校的机械与车辆学院建有”高效低排放内燃机技术工信部重点实验室”等6个部级科研平台,科研教学设备总资产超过3亿元。近五年,该学科的总研究经费超过4亿元。
何旭教授带领的团队长期深耕内燃机燃烧与排放领域(北京理工大学机械与车辆学院,https://me.bit.edu.cn/szdw/jsml/rnydlgcx/fdjyjs/index.htm)。2026年,团队在《北京理工大学学报》(DOI:10.15918/j.tbit1001-0645.2025.147)发表了一项基于CONVERGE软件的氨/柴油双直喷发动机CFD仿真研究,系统探索了氨能量分数(0~40%)和柴油喷射正时对燃烧与排放的影响规律。研究发现,当氨能量分数在20%~30%区间时,发动机综合性能最优,燃烧持续期最短,同时未燃氨及温室气体排放量最低。这项研究的背后,是一个规模可观的数值计算工程——1/8燃烧室三维模型、多组分详细化学反应机理、喷雾贯穿距离标定、多工况参数扫描。
另一个方向来自罗庆贺副研究员的团队(北京理工大学机械与车辆学院),专注于氢内燃机性能、燃烧与排放研究,以及储供氢一体化系统。氢气作为零碳燃料,缸内直喷可以有效抑制回火和早燃等异常燃烧,提高充量系数,是当前内燃机零碳化转型的热点路径。这些研究无一例外依赖CFD仿真作为核心工具。
这些研究方向映射了一个更广泛的行业趋势:传统内燃机正在被重新设计。氨、氢、甲醇、生物柴油等零碳或低碳燃料被注入气缸,但燃烧过程比汽油或柴油复杂得多。多组分燃料混合、化学反应路径交错、污染物排放耦合——这些现象无法通过台架试验完全捕获,因为光学测试只能看到燃烧室的窗口区域,而温度、压力、组分浓度在缸内每一立方毫米都在剧烈变化。
CFD(计算流体动力学)成为唯一手段。它可以在计算机里复刻一个完整的内燃机循环:从进气门开启、喷雾贯穿、液滴破碎、蒸发混合,到火焰传播、NOx生成、碳烟成核,再到排气门打开。一场发生在0.02秒内的物理化学风暴,被离散成数百万个网格点上的偏微分方程组,逐时间步求解。这不是”模拟”,这是缸内过程的数字化副本。
但构建这个副本的代价,是一套极其苛刻的算力需求。
二、内燃机CFD仿真为什么比传统CFD更难
内燃机CFD的复杂度远超管道流动或外气动计算。核心难点来自三个耦合:运动边界、多尺度化学反应、湍流燃烧交互。每一个耦合都是独立的研究领域,而内燃机CFD需要把它们同时求解。
运动几何:活塞、气门、喷雾的共舞
内燃机的边界不是静止的。活塞以每秒十几米的速度往复运动,进气门和排气门在毫秒级时间尺度内开启和关闭,喷油器喷出的液束在高压下破碎成无数液滴。这些运动部件要求网格在每一时间步重新生成或变形。传统CFD软件如Fluent、OpenFOAM处理静止或简单运动几何游刃有余,但面对内燃机这种”活塞+气门+喷油器”多体运动,前处理网格划分成为噩梦。
CONVERGE软件之所以成为内燃机CFD的行业标准,就是因为它内置了自动笛卡尔切割网格技术,无需人工划分网格,软件根据运动几何自动切割网格单元。这节省了大量前处理时间,但也意味着计算过程中网格生成本身就在消耗算力。何旭团队的仿真中,燃烧室模型包含缸盖、活塞和缸套,喷孔直径0.217mm(柴油)和0.16mm(液氨),这样的几何尺度要求网格分辨率足够精细,网格数量自然攀升到百万级别。
详细化学反应机理:几百种组分的刚性方程组
汽油燃烧的简化骨架机理可能包含50-100种组分、300-500个基元反应。但氨/柴油双燃料燃烧、氢气直喷、生物燃料氧化等新型燃烧模式,需要更详细的机理描述。例如氨氧化的机理涉及NH₃、NH₂、NH、N₂H、NO、N₂O、HNO等数十种氮相关中间产物,反应网络覆盖低温氧化、高温燃烧、NOx再还原、热NO和 prompt NO 生成等多条路径。这些组分在网格点上随时间变化的速率方程极其刚性(stiff),特征时间尺度从纳秒到毫秒跨越五个数量级,时间步长被刚性方程限制在微秒甚至纳秒级别。
CONVERGE内置的SAGE燃烧模型采用详细化学反应机理,实时求解各组分的化学反应速率。这意味着每个网格点、每个时间步都要积分一次完整的化学动力学方程组。网格数量乘以时间步数,再乘以组分数,计算量呈指数级增长。何旭团队的氨/柴双直喷仿真采用了1/8燃烧室模型(利用对称性减少计算域),但即便如此,单次工况的计算也需要在数十核工作站上运行数十小时。如果要做全循环(720度曲轴转角,即四冲程的两转)而不是只模拟燃烧阶段,计算时间还要再翻倍。
湍流燃烧交互:RANS还是LES?
湍流燃烧的建模是内燃机CFD的第三个硬核挑战。雷诺平均Navier-Stokes(RANS)方法计算效率高,但无法捕捉缸内循环变动和局部火焰结构的细节。大涡模拟(LES)可以分辨大尺度湍流涡结构,对燃烧不稳定性和局部熄火/再燃的预测更精确,但网格数量和时间步长要求比RANS高一个数量级。对于汽油机的爆震预测、柴油机的燃烧噪声分析,LES几乎是必需的。但一个LES内燃机仿真的网格数可能达到500万-1000万,计算时间从”小时”变成”天”,甚至”周”。
排放预测:化学与物理的双重不确定性
NOx生成依赖高温富氧区域和滞留时间,碳烟生成依赖燃料裂解和局部当量比。这些排放物的预测精度不仅取决于流场和温度场的准确性,还取决于化学机理本身的可靠性。CFD模拟可以先预测缸内压力和温度曲线,再通过后处理提取排放指标。但若要真正做到”排放优化”,通常需要参数化扫描(DOE):改变喷射压力、喷射正时、EGR率、当量比等参数,运行几十组甚至上百组仿真,然后构建响应面模型寻找最优参数组合。这种参数化研究对算力的需求是单点仿真的数十倍。
何旭团队的研究中,仅氨能量分数和柴油喷射正时两个变量就构成了一个二维参数空间,每个参数点都需要一次完整的CFD仿真。如果再加上EGR率、喷油压力、当量比等变量,参数组合轻松过百。没有足够算力的支撑,这种系统性的排放优化研究根本无法开展。
三、软件生态与计算特征
内燃机CFD仿真领域形成了特定的软件生态。CONVERGE是商业软件中最主流的选择,尤其在直喷发动机领域几乎成为行业标准。它集成了自动网格生成、详细化学动力学求解器、喷雾破碎模型(如KH-RT模型)、湍流燃烧模型(SAGE、G方程等)和排放后处理工具。AVL FIRE、ANSYS Fluent(配合内燃机专用模块)、OpenFOAM(配合LibICE等内燃机扩展库)也是常用选项。国内一些高校和研究所也在基于OpenFOAM开发自主知识产权的内燃机CFD求解器,如四川大学燃烧动力学平台植入的FGM模型。
从计算特征看,这些软件对硬件的需求呈现出鲜明的”CPU+内存”双密集型特点:
CPU需求:内燃机CFD的并行效率主要来自空间域分解。每个计算核心负责一部分网格区域的求解。详细化学反应机理的求解在CONVERGE中目前仍以CPU为主,每个网格点的化学ODE积分串行进行。因此,核心数越多,并行分区越细,整体计算速度越快。但超过一定核心数后,MPI通信开销会抵消并行收益。对于中等规模内燃机仿真(百万级网格),32-64核通常是最优区间。如果运行多工况并行,核心数可以线性扩展——每个工况分配一组核心,互不影响。
内存需求:详细化学机理的内存占用与组分数和网格数成正比。一个包含100种组分、300个反应的机理,在100万个网格点上存储瞬时浓度、温度、压力等变量,内存需求可能达到几十GB。加上网格数据、湍流变量、喷雾统计量,单工况仿真占用128-256GB内存是常态。如果同时进行多工况参数化研究,内存需求还会成倍增加。做LES仿真时,需要存储亚格子尺度模型变量和更细的时间分辨率,内存需求进一步攀升。
存储需求:内燃机CFD的后处理数据量巨大。每个时间步输出一次全场数据,一个完整循环(720度曲轴转角)可能包含数千个时间步,每个数据文件几百MB到数GB。一次完整仿真可能产生几十GB到上百GB的原始数据。NVMe高速存储不仅能缩短读写时间,还能减少I/O等待对计算效率的影响。当进行多工况DOE时,存储容量需求会累积到TB级别。
GPU的作用:在CONVERGE等主流软件中,GPU目前主要用于加速某些特定的子模型(如喷雾统计、后处理可视化),核心CFD求解和化学动力学仍以CPU为主。但OpenFOAM的GPU版本和正在发展的异构计算框架,预示着GPU在未来内燃机LES(大涡模拟)中的角色会越来越重要。如果研究方向涉及LES+详细化学机理,GPU显存和带宽将成为关键瓶颈。对于目前以RANS+详细机理为主的内燃机燃烧仿真,投资优先级仍然是CPU核心数和内存容量。
四、为什么现在要聊配置
内燃机CFD仿真的计算需求已经和普通办公PC彻底分道扬镳。一个使用详细化学机理的百万网格内燃机仿真,在普通台式机上可能需要运行一周甚至更久。当研究进入多工况参数化优化阶段,计算需求从”单个任务”变成”批处理任务队列”,传统单机的算力瓶颈变得不可接受。
更关键的是,零碳燃料的燃烧仿真正在把计算需求推向新的高度。氨燃料、氢燃料、甲醇燃料的化学反应机理比传统碳氢燃料更复杂,涉及更多中间产物和反应路径。氨燃料的NOx生成和再还原机制、氢燃料的异常燃烧预测、生物燃料的多组分蒸发模型——这些都需要更详细的机理和更精细的网格。这意味着,即使研究规模不变,单机算力的需求也在逐年增长。
工作站的配置选择不是攀比参数,而是匹配计算特征。内燃机CFD的瓶颈在CPU核心数、内存容量和存储带宽,而不是GPU算力。因此,配置方案应该围绕”多核CPU+大内存+高速存储”来设计,GPU作为辅助。下面的四级方案按照这个思路展开。
五、工作站配置推荐
内燃机CFD仿真的算力需求随研究规模呈阶梯式增长。以下按从入门到集群四级方案推荐。
方案A:入门验证型
适用场景:单工况简化机理验证、小型网格燃烧室仿真、学位论文前期探索、机理标定与模型验证
推荐机型:A350 156128-MCA
- CPU:Intel Core Ultra 9 285K(24核,8P核5.6GHz)+水冷
- GPU:Quadro T400
- 内存:128GB DDR5
- 存储:4TB NVMe(14GB/s)
推荐理由:24核高频CPU适合单工况内燃机仿真,5.6GHz的单核性能在化学ODE积分时具有优势。128GB内存可以容纳百万级网格和50-80种组分的骨架机理。4TB NVMe高速存储满足后处理数据读写需求。适合研究生起步阶段的机理标定和燃烧室基础仿真,或课题组内作为专用前处理/后处理工作站。
方案B:进阶研究型
适用场景:中等规模全循环内燃机仿真、多工况DOE初步探索、详细化学动力学研究、氨/氢新型燃料燃烧特性分析
推荐机型:GR450P 148192-MCC
- CPU:AMD锐龙线程撕裂者7980X,64核4.8GHz,水冷
- GPU:RTX 4000 Ada 20GB
- 内存:192GB DDR5
- 存储:4TB NVMe SSD
- CPU性能:约4.9Tflops
推荐理由:64核处理器可以同时运行2-3个中等规模内燃机仿真工况,或在单个工况中以32-48核并行计算加速收敛。192GB内存支持百万级网格结合100+组分的详细化学机理。水冷散热保证64核在全负载下的频率稳定。RTX 4000 Ada的20GB显存可用于后处理可视化和数据渲染。适合需要多工况并行扫描的研究团队,或作为课题组的主力计算工作站。
方案C:专家仿真型
适用场景:大规模内燃机全循环仿真、多缸整机模型、详细机理+多工况DOE优化、LES大涡模拟探索
推荐机型:EX660 227384-MCB
- CPU:2×Intel Xeon金牌6554s,72核2.7GHz,水冷
- GPU:RTX A2000
- 内存:384GB DDR5
- 存储:4TB NVMe Gen5
- CPU性能:约2.76Tflops
推荐理由:双路Xeon平台提供72核和超大内存带宽,适合大规模内燃机网格的空间域分解。384GB DDR5内存可以容纳多缸模型或详细化学机理(200+组分)的仿真需求。NVMe Gen5存储在读取大规模后处理数据时减少I/O瓶颈。该机型在基准报价表中明确标注适用”流体、碰撞、爆炸仿真计算,时域算法仿真计算”,与内燃机CFD的计算特征高度匹配。适合承担国家级科研项目或企业合作研发中的大规模内燃机仿真任务。
方案D:集群优化型
适用场景:全参数空间DOE优化、LES大涡模拟、多燃料多工况并行研究、氢/氨新型燃料大规模验证、企业级燃烧系统开发
推荐机型:EA660 245512-MDB
- CPU:2×AMD霄龙9475F,96核3.65~4.8GHz
- GPU:RTX A2000 6GB
- 内存:512GB DDR5
- 存储:8TB NVMe Gen5
- CPU性能:约6.9Tflops
- 结构:塔式
推荐理由:96核高频处理器的浮点性能达到6.9Tflops,适合大规模参数化DOE研究。512GB内存可以同时驻留多个内燃机仿真工况的数据,避免频繁换入换出。8TB存储容量支持长期积累的仿真数据库管理。在基准报价表中,该机型明确适用”有限元分析(碰撞、爆炸、冲击仿真)完美增强型”,其高核心数+大内存的组合同样适用于内燃机多工况并行CFD优化。对于需要同时开展氨燃料、氢燃料、生物柴油等多种零碳燃料燃烧机理研究的团队,这一配置提供了充足的并行计算能力和内存空间。多个研究成员可以同时在同一台机器上提交计算任务,互不干扰。
六、结语
内燃机CFD仿真正在经历从”定性分析”到”定量优化”的范式转变。过去,一次成功的仿真只需要复现出台架试验的压力曲线趋势。现在,排放预测精度需要达到可指导工程设计的水平,参数化优化需要覆盖足够大的设计空间。这种转变的代价是计算需求的几何级增长。
零碳燃料的引入没有让内燃机变得简单,反而让燃烧过程变得更复杂。氨燃料的NOx双重生成机制、氢燃料的异常燃烧风险、生物柴油的多组分蒸发特性——这些都需要更详细的机理、更精细的网格、更多的计算资源。在这个背景下,工作站不再是加快计算速度的工具,而是让研究成为可能的基础设施。
从1952年学科建立到今天,北京理工大学的内燃机研究走过了从经验估算到数字化设计的漫长道路。CFD仿真让研究人员可以在点火之前就”看到”缸内发生的每一件事。这种能力的边界,取决于你面前的算力工作站能撑起多大的计算规模。
微信号:maxftxwx












