
2025年,西安交通大学经济与金融学院博士生马雨菡与导师张飞鹏教授、香港浸会大学Heng Peng教授合作完成的研究成果,被计量经济学与统计学国际权威期刊《Journal of Business & Economic Statistics》正式接收。这项研究聚焦在线性预测回归框架下,提出了一种新的条件期望在险价值(Conditional Expectile-based Value-at-Risk,简称EVaR)的最小二乘残差估计量。论文的核心贡献在于,通过结合最小二乘线性预测与残差EVaR,建立了一套在混合时间序列情形下具有严格渐近理论性质的统计推断框架,并证明该估计量相比现有方法在渐近意义上更有效。大量数值模拟与风险管理实例表明,新方法不仅计算效率更高,而且在有限样本下表现更优。
这篇论文发表在一个并不算高的学术位置上,但它的技术内涵对金融工程领域的硬件需求极具代表性。EVaR的计算本质上涉及两个层面的数值密集型任务:一是对高维时间序列进行线性预测回归,需要反复估计和更新协方差矩阵;二是在预测残差的基础上,通过蒙特卡洛模拟生成大量情景路径来估计极端分位数。当样本量达到百万级别、资产维度扩展到数百只时,这两个环节叠加起来的计算量,足以让一台普通办公电脑在数小时内陷入停滞。西安交大团队的论文能够处理真实市场数据并获得稳定的有限样本表现,背后必然依赖足够强劲的计算基础设施。对于从事类似研究的课题组或金融机构而言,搞清楚这类工作到底吃什么样的硬件配置,比搞清楚论文的数学推导更紧迫。
为什么风险度量离不开蒙特卡洛
金融风险度量领域有一个基本矛盾:理论上我们希望得到精确的风险数字,但现实中市场的随机性使得解析解几乎不存在。Value-at-Risk(VaR)和Conditional Value-at-Risk(CVaR)是业界最常用的两个风险指标,但它们的计算都面临同一个难题——资产收益率的联合分布通常不是正态的,而且包含大量非线性依赖关系。即便是最简单的多元t分布,当维度超过五时,分位数的解析表达式就已经写不出来了。
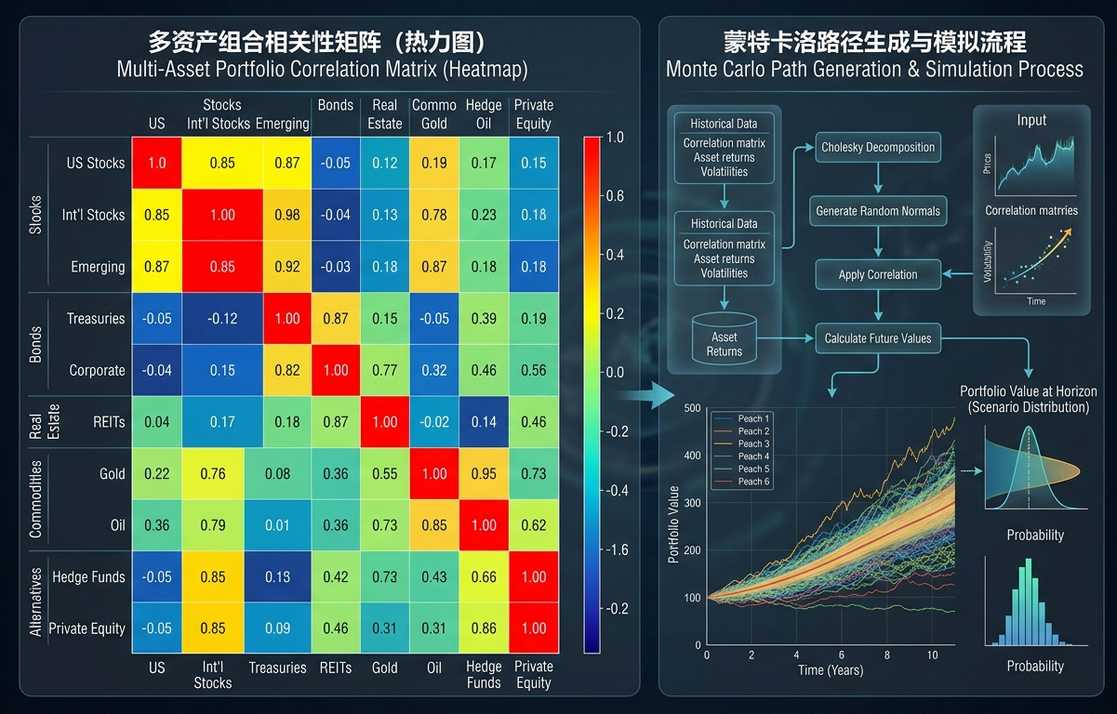
蒙特卡洛模拟是绕过这个障碍的通用方法。它的思路很直接:既然真实分布太复杂,那就用计算机随机生成成千上万条可能的市场路径,然后在每条路径上计算 portfolio 的盈亏,最后从盈亏分布中读出对应分位数。理论上,只要模拟次数足够多,大数定律保证估计结果会收敛到真实值。问题就出在这个”足够多”上。对于99%置信水平的VaR,要达到两位有效数字的精度,通常需要至少十万次模拟。如果 portfolio 包含100只资产,每只资产的收益率需要建模为包含GARCH效应的随机波动过程,每条路径还需要模拟252个交易日(一年的数据),那么总计算量就是十万乘以100乘以252,也就是25亿次随机数生成和路径演化运算。
这还只是单次风险度量的计算量。在实际的金融机构中,风险团队每天需要在开盘前、盘中和收盘后多次更新风险报告。如果一次完整计算需要6小时,那么风险 desk 在上午10点看到的风险数字,实际上反映的是前一天收盘时的市场状态。当市场波动剧烈时,这种延迟意味着交易员正在用一个已经过时的风险图景做决策。IEEE的一篇技术报告指出,在衍生品定价和风险度量场景下,传统蒙特卡洛方法的计算速度与精度之间存在根本性权衡:模拟次数少则快但不准,多则准但慢。风险 desk 通常一天只能更新一次组合风险估计,这在市场剧变时构成了严重的敞口暴露。
西安交大张飞鹏团队的研究正是在这个背景下展开。他们提出的条件EVaR估计量,相比传统方法虽然统计效率更高,但计算流程中仍然嵌入了大量蒙特卡洛模拟来验证渐近性质和有限样本表现。论文中的数值实验部分明确提到,使用了”大量数值模拟”来比较新估计量与现有方法的性能。对于审稿人和读者而言,这些模拟结果是证明方法有效性的核心证据;但对于执行模拟的研究人员来说,它们是真正的计算负担。
大规模情景分析的技术难点
蒙特卡洛模拟在金融风险度量中的应用,远比教科书上的例子复杂。当规模上升到”大规模情景分析”的层面时,计算系统会遭遇四个相互关联的瓶颈。
第一个瓶颈是维度灾难。在单资产期权定价中,蒙特卡洛只需要模拟一个随机过程。但在组合风险度量中,需要同时模拟多个资产价格的联合演化。资产之间的相关性矩阵通常需要估计,而估计误差会随着维度增加而放大。100只资产的协方差矩阵有5050个独立元素,从三年日频数据估计时,每个元素只有约750个观测点。如果还要考虑时变波动率和非线性相关结构(如copula模型),参数空间会进一步膨胀。每个参数都需要在模拟中反复调用,参数越多,单次模拟的CPU开销越大。
第二个瓶颈是路径生成的时间步长。对于风险度量而言,我们通常关心的是一周或一个月内的极端损失。但资产价格的随机过程需要以日频甚至更高频率进行离散化,才能准确捕捉波动率聚集和跳跃行为。一条模拟路径可能需要250个时间步,十万条路径就是2500万个时间步。每个时间步都需要生成随机数、更新价格、检查约束条件。如果使用的是更复杂的过程(如Heston随机波动模型或带跳跃的Levy过程),每个时间步的运算量还会成倍增加。
第三个瓶颈是内存占用。大规模情景分析不是一次性生成所有路径然后分析,而是需要分批进行。因为十万条路径、每条路径250步、每步记录100只资产的价格,光是原始数据就需要存储25亿个浮点数。如果每个浮点数占8字节,那就是20GB内存。如果还要存储中间变量(如波动率、相关性、 Greeks 等),内存需求会轻松突破50GB。当计算涉及更复杂的产品结构(如含路径依赖特性的奇异衍生品)时,内存需求可能达到数百GB。这已经不是普通桌面工作站能承载的规模了。
第四个瓶颈是I/O和存储。金融机构的历史情景分析通常需要回溯检验:用过去十年的数据,每天滚动计算一次风险度量,然后比较预测值与实际损失的吻合度。这意味着需要重复计算约2500次,每次十万条路径。总计算量达到250亿次路径模拟。中间结果需要写入磁盘,最终报告需要汇总和可视化。存储系统的写入带宽和容量都会成为瓶颈。如果使用的是机械硬盘,频繁的随机写入会让计算速度下降一个数量级。
这四个瓶颈叠加起来,决定了大规模情景分析对硬件的要求是全方位的:CPU需要足够多核心来并行生成路径,内存需要足够大来容纳中间数据,存储需要足够快来读写大规模结果,网络带宽在多机并行时也不能成为短板。而且,由于蒙特卡洛模拟的 embarrassingly parallel 特性——每条路径可以独立生成——多核并行是最直接的加速手段。但并行化本身也有开销:随机数生成器的同步、路径结果的汇总、分位数估计的分布式计算,都需要仔细设计。如果并行框架设计不好,16核CPU的实际加速比可能只有8倍。
硬件需求的逐层拆解
基于上述技术难点,我们可以把金融风险度量蒙特卡洛模拟的硬件需求拆解为几个具体层面。
CPU层面,核心需求是高频多核。蒙特卡洛路径生成是计算密集型任务,每个时间步都需要执行浮点运算和随机数调用。虽然算法本身可以并行,但单核性能决定了每条路径的生成速度。在Xeon或Ryzen平台上,单核频率越高,单条路径的耗时越短。同时,总路径数巨大,核心数越多,可以同时生成的路径越多。对于”十万级情景”这个规模,32核以上的CPU是必要的起点。如果涉及到更复杂的模型(如多资产随机波动+相关结构),64核甚至128核才能满足日常回测的时间窗口要求。此外,CPU的缓存大小也很重要,因为相关性矩阵和参数向量需要在模拟中反复访问,如果这些数据能常驻在L3缓存中,可以避免频繁的内存访问延迟。
内存层面,需求是容量和带宽的双重提升。如前所述,大规模情景分析的中间数据可以轻松达到数十GB。如果还要进行历史回测或 stress testing,内存需求会进一步上升。DDR5内存相比DDR4在带宽上有显著提升,对于需要频繁读写大规模数组的蒙特卡洛模拟来说,内存带宽直接决定了数据吞吐效率。在实际配置中,256GB DDR5是一个合理的起步点,对于需要处理多资产组合、复杂衍生品结构、或者进行大规模回溯检验的机构,512GB甚至1TB内存并不罕见。
存储层面,NVMe SSD是刚需。蒙特卡洛模拟的结果需要频繁写入临时文件,然后读取进行统计分析。如果存储介质的写入速度只有几百MB/s,I/O等待会吃掉大量计算时间。现代NVMe SSD的连续读写带宽可以达到数GB/s,而且随机读写性能远超机械硬盘。对于每天需要生成和销毁数百GB临时数据的场景,NVMe SSD不仅加速计算,还能延长存储介质的使用寿命。容量方面,4TB起步是合理的,如果需要保存长期的历史模拟结果和回溯检验报告,8TB或更多也不为过。
GPU层面的需求相对复杂。传统的蒙特卡洛模拟主要依赖CPU,因为路径生成涉及大量条件判断和随机数调用,这些任务在GPU上的效率不一定比在CPU上高。但近年来,随着GPU通用计算(GPGPU)的发展,以及CUDA、OpenCL等框架的成熟,越来越多的金融工程团队开始将蒙特卡洛模拟 offload 到GPU上。特别是当模拟涉及大量同质路径生成时,GPU的数千个轻量级核心可以同时执行,加速比可以达到数十倍甚至上百倍。对于需要实时定价和实时风险更新的交易 desk,配备高端GPU可以显著缩短计算延迟。但GPU方案也有成本:需要重写代码、处理CPU-GPU数据传输开销、以及调试并行随机数生成器的复杂性。因此,GPU在金融风险度量领域目前仍属于”加速选项”而非”必需选项”,但对于追求极致效率的团队来说,它已经不再是可有可无的配件。
网络层面,在多机并行场景中很重要。如果单机的CPU和内存不足以在合理时间内完成任务,就需要将路径生成分布到多台机器上。此时,网络带宽决定了数据在节点间的传输速度,而网络延迟则影响同步频率。在InfiniBand或高速以太网环境下,多机并行可以近乎线性地扩展计算能力。但对于大多数高校课题组和中小型金融机构而言,单机配置足够强大,可以避免多机并行的复杂性和额外成本。
工作站配置选型
有了上述技术需求分析,我们可以进入具体的配置推荐环节。以下方案基于UltraLAB 2026年产品目录和基准报价表,按照不同规模和预算梯度进行匹配。所有型号均可在产品目录中查到,配置参数严格对应官方规格。
方案A:入门探索型
适用场景:单资产或少量资产(不超过10只)的VaR/CVaR计算,路径数在1万以下,主要用于教学演示和小规模学术研究。
- CPU:Intel Core Ultra 7 265K,20核(8P全核5.3GHz/12E全核3.8GHz)——高主频保证单条路径生成速度,20核对小规模并行已足够
- GPU:RTX 5060Ti 16GB——提供基础CUDA加速能力,16GB显存可承载中等规模的GPU并行计算
- 内存:64GB DDR5——满足万级路径、十只资产、一年日频数据的内存需求
- 存储:2TB NVMe SSD(产品目录标称14GB/s读取带宽)——快速读写临时模拟结果
- 机型:A350 15064-MBX
方案B:课题主力型
适用场景:中型组合(20-50只资产)的风险度量,路径数达到5-10万,需要定期进行历史回测,适用于金融学硕士/博士课题研究和中小型金融机构的风险管理。
- CPU:Intel Core Ultra 7 265K,24核(8P全核5.5GHz/16E全核3.8GHz)——更多核心和更高主频,应对十万级路径生成
- GPU:RTX 5090 v2 24GB——水冷散热保证持续高负载下的频率稳定,24GB显存可支持较大规模的GPU并行蒙特卡洛
- 内存:128GB DDR5——容纳十万条路径、50只资产、一年日频数据的中间结果,留有余量用于复杂衍生品结构
- 存储:4TB NVMe SSD(产品目录标称14GB/s读取带宽)——存储历史数据、模拟结果和回溯检验报告
- 机型:A350 153128-MCT
方案C:科研攻坚型
适用场景:大规模组合(50-100只资产)的精细化风险度量,路径数达到10万以上,涉及多因子模型、随机波动率和复杂衍生品结构,适用于金融学前沿课题和高标准学位论文。
- CPU:AMD锐龙9950X3D,16核(4.3~5.7GHz)+ 水冷——3D V-Cache对频繁访问相关性矩阵和参数数组的场景有显著加速,单核性能强劲
- GPU:RTX 4090 48GB + 水冷——48GB显存可以加载完整的组合相关矩阵和参数空间,在GPU上实现大规模并行蒙特卡洛
- 内存:192GB DDR5——支撑十万级路径、百只资产、多年数据的高维场景,满足大型回溯检验的内存需求
- 存储:4TB NVMe SSD(产品目录标称14GB/s读取带宽)——高速存储大规模模拟结果和长期历史数据
- 机型:AR350 148192-MCT
方案D:机构级计算型
适用场景:超大规模组合(100只以上资产)的全机构风险度量,路径数达到百万级,需要日频实时更新和全历史回溯检验,适用于大型金融机构的风险管理部、量化对冲基金和跨校区联合研究平台。
- CPU:2×Xeon金牌6530,64核(2.7~4GHz)+ 水冷——双路平台提供64核128线程,同时处理多组合、多模型的并行计算需求
- GPU:2×RTX 6000D 84GB——双卡84GB显存可分割为多个计算流,各自处理不同资产组合或不同风险模型,总显存168GB可加载超大维度参数空间
- 内存:256GB DDR5——容纳百万级路径、百只以上资产、多年日频数据,以及多模型同时运行的内存需求
- 存储:8TB NVMe SSD(产品目录标称14GB/s读取带宽)+ 扩展HDD——NVMe负责活跃计算数据的快速读写,大容量HDD用于长期归档历史回测结果
- 机型:GX660M 227512-MD4E
方案E:极致并行型
适用场景:需要探索GPU极限加速的尖端研究,如将蒙特卡洛模拟与深度神经网络结合进行端到端风险预测,或者开发新型方差缩减技术需要海量基准对比实验。
- CPU:2×Xeon金牌6530,64核(2.7~4GHz)+ 水冷——保证CPU端的数据预处理、模型训练和结果汇总效率
- GPU:4×RTX 5090D 32GB + 水冷——四卡并联,总显存128GB,可同时在四组不同参数配置下运行蒙特卡洛,或在单组任务中利用四卡聚合带宽加速数据搬运
- 内存:256GB DDR5——支撑多GPU任务调度和大规模数据传输的缓冲需求
- 存储:8TB NVMe SSD(产品目录标称14GB/s读取带宽)+ 扩展HDD——匹配四卡GPU的算力产出,避免存储成为瓶颈
- 机型:GX660M 227256-MD4T
方案F:旗舰数据中心型
适用场景:全机构级风险基础设施,需要同时服务多个交易 desk、风险团队和研究部门,支持全天候实时风险计算和百万级情景 stress testing。
- CPU:2×AMD霄龙9755,256核(4.1GHz)——超高核心数应对多租户并发请求,大吞吐量处理批量风险报告
- GPU:4×H200 141GB——单卡141GB显存、4TB/s显存带宽,四卡总显存564GB,可加载整个机构的全部资产组合和全球市场的联合分布模型
- 内存:768GB DDR5——支撑多用户、多任务、大规模数据集同时驻留内存
- 存储:8TB NVMe SSD(产品目录标称14GB/s读取带宽)+ 并行存储扩展——满足多节点同时高速读写
- 机型:GX660M 241768-PD4H
以上六档配置从入门级到旗舰级,覆盖了金融风险度量蒙特卡洛模拟的完整算力谱系。选型时,核心判断依据是三个维度:资产组合规模(决定内存需求)、路径数量(决定CPU核心数和计算时间)、模型复杂度(决定GPU显存和计算能力)。对于西安交大经济与金融学院这样的课题组,从课题主力型(方案B)起步,随着研究深入逐步升级到科研攻坚型(方案C),是最务实的路径。而对于已经承担实际风险管理职能的金融机构,机构级计算型(方案D)通常是起步配置,因为百万级路径和实时更新是监管合规的基本要求。
蒙特卡洛模拟本质上是一个用算力换精度的过程。在金融风险度量领域,这个交易永远成立:你多花一倍的计算时间,估计误差大约缩小到原来的1/√2。但市场不会等你慢慢算。当张飞鹏团队在西安交大实验室里调试新估计量的渐近性质时,他们和华尔街的风险分析师面对的是同一个算力约束。区别在于,后者可能因为一次计算超时而承担数百万美元的交易损失。所以,对于任何认真对待风险度量的人来说,工作站的配置不是采购问题,而是风险管理的基础设施问题。
微信号:maxftxwx












