
本文采用技术分析视角,以清华大学计算化学研究为参照系探讨行业趋势。文中提及的学术成果均来自公开文献,不代表任何官方立场。硬件配置建议仅供参考。
一、写在前面:当AI开始”抢”DFT的饭碗
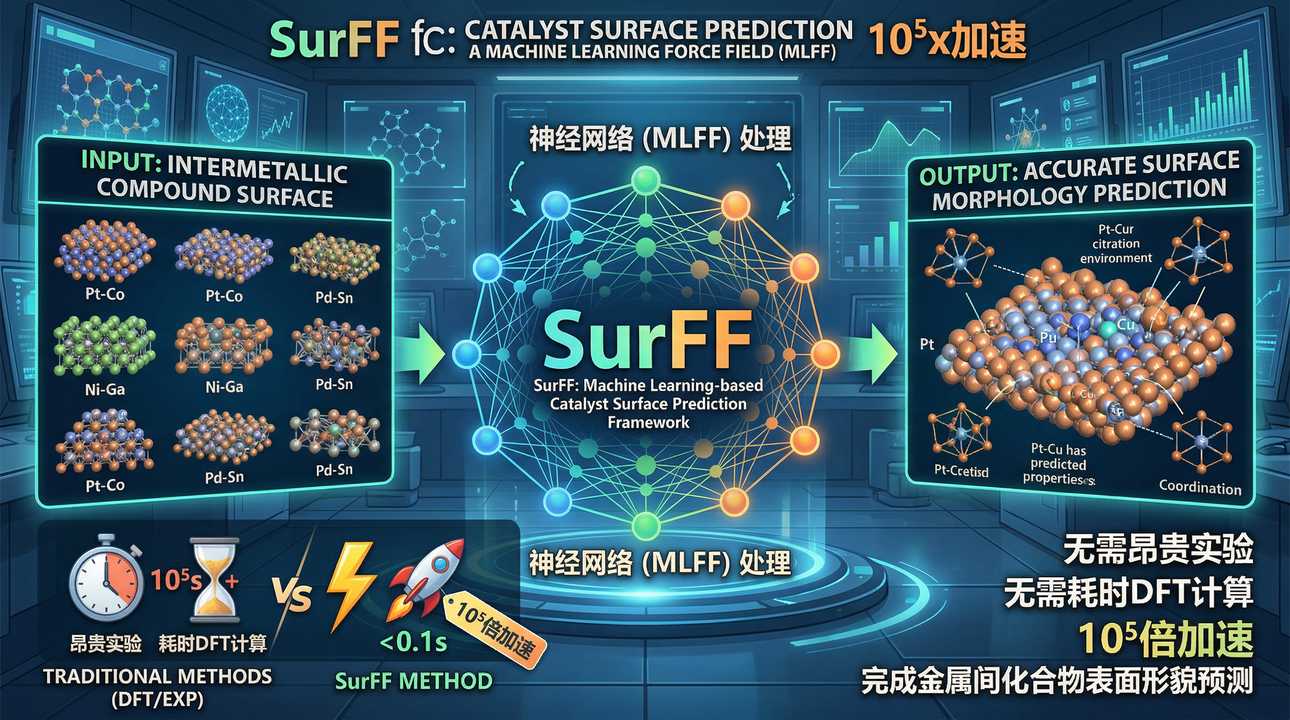
2025年10月,清华大学化工系王笑楠团队在Nature Computational Science发表了一篇让计算化学圈震动的研究——SurFF模型。这套基于机器学习力场(MLFF)的催化剂表面预测框架,无需昂贵实验或耗时DFT计算,就能以10⁵倍的加速比完成金属间化合物表面形貌预测。
10万倍是什么概念?
原本需要算一周的结构弛豫,现在几分钟搞定。原本只能算几十个晶面的项目,现在可以横扫上千种合金。更狠的是,SurFF对实验观测晶面的预测成功率高达73.1%——这已经逼近DFT本身的精度天花板。
当AI开始以这种速度重构催化剂设计的底层逻辑,一个问题浮出水面:我们这些做计算化学的,还需要砸钱买工作站吗?
答案可能有点反直觉:更需要了,但要买对方向。
本文就从算法本质、前沿技术、行业痛点三个维度,聊聊AI时代的计算化学工作站该怎么配。
二、算法本质:DFT、CCSD(T)和MLIP,到底在吃什么硬件?
做催化剂设计的,离不开这三板斧:
1. DFT(密度泛函理论):并行性好,但正在被AI”降维打击”
DFT的核心是求解Kohn-Sham方程,迭代优化电子密度。计算复杂度约O(N³),N是体系电子数。
硬件需求特点:
- 并行性:DFT的k点并行、能带并行做得很好,64核甚至128核都能吃到线性加速
- 内存:不算太夸张,一般每核2-4GB够用
- GPU:VASP从6.2.0起支持NVIDIA GPU(OpenACC端口),6.6.0起实验性支持AMD/Intel GPU;Quantum ESPRESSO 6.5+、ABINIT(2024年4月起)支持GPU加速,但加速比有限(通常2-5倍),且吃显存
行业现状:DFT仍是催化剂筛选的”黄金标准”,但高通量筛选的瓶颈已经从”算不动”变成了”算太慢”。SurFF这类MLIP的出现,让DFT的角色从”主力攻城”变成了”抽样质检”——用DFT生成训练集,用MLIP做大规模推理。
2. CCSD(T)(耦合簇理论):精度之王,硬件黑洞
CCSD(T)被称为量子化学的”金标准”,能精准描述电子相关效应。但代价是**O(N⁶)**的计算复杂度——体系增大一倍,计算量暴增64倍。
硬件需求特点:
- 单核性能:CCSD(T)的并行效率很差,通常只能用到8-16核,再多就是”一核有难,全核围观”
- 内存怪兽:Gaussian官方给出的内存估算公式是 9 × O² × V² words(O=占据轨道数,V=虚轨道数)。一个100原子的小分子用cc-pVTZ基组,可能轻松吃掉256GB内存
- 硬盘杀手:ORCA做DLPNO-CCSD(T)大体系,临时文件能塞满TB级SSD
- GPU:Gaussian 16支持K80/V100/P100做DFT,但Post-SCF计算(MP2/CCSD)效率不高
行业现状:CCSD(T)仍是小体系精确计算的终极武器,但对于催化剂这种表面体系(几百上千原子),算一次等于烧掉一台iPhone。
3. MLIP/MD(机器学习势/分子动力学):GPU的新战场
MLIP(Machine Learning Interatomic Potential)通过学习DFT的势能面,把第一性原理精度塞进经典力场的效率里。DeepMD、SchNet、MACE、NequIP这些框架,能把分子动力学模拟加速4个数量级。
硬件需求特点:
- GPU刚需:MLIP的神经网络推理是CUDA的甜点场景,RTX 4090都能吊打CPU集群
- 显存决定体系规模:显存越大,能模拟的体系越大。96GB显存的H100可以玩转十万原子级别的MD
- CPU内存:MD轨迹文件是存储黑洞,一天模拟能产生TB级数据
行业现状:MLIP正在快速成熟。VASP 6.6已经内置实时机器学习力场(ML_MODE=train),DeePMD-kit、TorchANI等开源工具也越来越易用。
三、前沿技术:2025年催化剂设计的三大武器
武器1:主动学习(Active Learning)——用最少的DFT办最多的事
SurFF的核心秘诀不是神经网络有多fancy,而是主动学习策略。
传统MLIP需要海量DFT数据做训练集。主动学习则通过”不确定性+多样性”采样,只挑最有信息量的构型算DFT,用15万CPU小时就构建出34万数据点的表面能数据库。
对硬件的启示:
- 不需要”一台超算算到死”,而是需要弹性算力——平时用GPU跑MLIP推理,关键时刻调用云端或集群资源算DFT补数据
- 存储成为新瓶颈:主动学习产生的大量中间数据需要高速SSD+大容量HDD的分层存储
武器2:等变神经网络(E(3)-Equivariant Networks)——物理约束下的AI
SchNet、EquiformerV2、MACE、NequIP这些2020年后涌现的MLIP架构,核心创新是引入E(3)等变性约束——模型输出(能量、力)对输入(原子坐标)的旋转、平移、反射保持不变。
这不仅是数学优雅,更是数据效率的飞跃。等变模型用更少的数据就能学到正确的物理规律。
对硬件的启示:
- 等变网络的计算量比传统MLP大,需要更强劲的GPU(推荐RTX Pro 6000 Blackwell或H100)
- 训练这些模型需要大显存+高内存带宽,Threadripper Pro或EPYC是更好的选择
武器3:高通量DFT筛选——从” artisan craftsmanship “到”工业化流水线”
Materials Project、AFLOW、NOMAD这些数据库已经把DFT计算变成了流水线作业。清华大学2024年建成的**”开拓1000″智算系统**,服务46个院系312个课题组,支撑发表SCI论文1231篇。
对硬件的启示:
- 单机工作站再强,也干不过百卡集群的通量
- 但工作站仍是”试错”和”方法开发”的刚需——总不能在超算上调试脚本吧?
四、行业痛点:AI时代计算化学的四大焦虑
痛点1:算力通胀——精度每提升一级,成本指数级爆炸
RDFT < DFT < hybrid DFT < MP2 < CCSD < CCSD(T)
这个精度天梯,每往上爬一级,硬件需求就翻几倍。SurFF的10⁵倍加速,本质上是用AI把CCSD(T)级别的精度下放到DFT的成本区间。
痛点2:软件授权——VASP和Gaussian的”金钱游戏”
- VASP:学术授权按核收费,大规模并行=烧钱
- Gaussian:商业软件,GPU支持还局限于较老的K80/V100/P100,且Post-SCF计算GPU效率不高
- ORCA:免费开源,但DLPNO-CCSD(T)的内存和硬盘需求惊人
避坑建议:
- 做DFT为主:优先VASP(性能好)或Quantum ESPRESSO(开源免费)
- 做高精度计算:ORCA的DLPNO-CCSD(T)是性价比之选
- 做MLIP:DeePMD-kit、TorchANI、SchNetPack都是开源的,省下的钱买显卡
痛点3:数据管理——MD轨迹文件的”存储灾难”
一个10万原子的MD模拟,跑100万步,轨迹文件轻松突破TB级。如果做主动学习,中间产生的构型、能量、力场数据更是爆炸式增长。
痛点4:人才断层——懂催化的不懂AI,懂AI的不懂催化
SurFF这类模型的出现,要求研究者同时具备:
- 催化剂设计的化学直觉
- DFT计算的经验
- 深度学习框架的实操能力
- 高性能计算的调优技巧
这种人,比H100还稀缺。
五、硬件配置分级:从入门到集群的四级跃迁
基于以上分析,以下是针对AI+催化剂设计的四级配置方案。注意:不写出具体价格,因为硬件价格波动大,且学术折扣差异显著。
Level 1:入门型——本科生/研一教学用
定位:跑小体系DFT(<50原子)、学习MLIP基础、做简单后处理
核心配置:
| 配件 | 推荐规格 | 说明 |
|---|---|---|
| CPU | AMD Ryzen 9 9950X (16核32线程) 或 Intel i9-14900K | 单核性能优先,GCC编译VASP/Gaussian效率高 |
| 内存 | 128GB DDR5-5600 ECC | 每核4GB是底线,128GB能应付大部分教学任务 |
| 显卡 | RTX 4070 Ti SUPER 16GB | 16GB显存能跑中小型MLIP推理,CUDA生态成熟 |
| 存储 | 2TB NVMe SSD (PCIe 4.0) + 4TB HDD | SSD装系统+软件,HDD存轨迹文件 |
| 主板 | B650E/B760E 工作站级 | 注意供电和散热,别买丐板 |
避坑提示:
- 别买消费级非ECC内存,MD跑一周出现bit翻转就哭了
- 别指望这配置跑CCSD(T)大体系,老老实实做DFT
Level 2:进阶级——博士生主力工作站
定位:中等体系DFT(100-300原子)、MLIP训练、常规MD模拟
核心配置:
| 配件 | 推荐规格 | 说明 |
|---|---|---|
| CPU | AMD Threadripper 7970X (32核64线程) 或 TR Pro 7995WX | 四通道/八通道DDR5,内存带宽是瓶颈 |
| 内存 | 256GB DDR5-4800 ECC REG | 大体系DFT+MLIP训练刚需 |
| 显卡 | RTX Pro 6000 Blackwell 96GB | 96GB显存能训大模型,GDDR7 ECC稳定性好 |
| 存储 | 4TB NVMe SSD (PCIe 5.0) + 16TB HDD RAID | SSD用企业级,HDD做RAID防数据丢失 |
| 网络 | 10GbE 网卡 | 连接服务器或超算传数据用 |
避坑提示:
- Threadripper非Pro版是四通道,Pro版是八通道,内存带宽差一倍
- RTX Pro 6000 Blackwell的96GB显存是MLIP训练的甜点区,别用RTX 4090 24GB硬撑
Level 3:专家级——组内共享服务器
定位:高通量DFT筛选、大规模MLIP训练、多用户并发
核心配置:
| 配件 | 推荐规格 | 说明 |
|---|---|---|
| CPU | 双路 AMD EPYC 9965 (2×192核384线程) | Zen 5c架构(紧凑型核心),极致多核并行 |
| 内存 | 1TB DDR5-4800 ECC REG (24×48GB) | 双路EPYC 12通道×2,必须插满24条 |
| 显卡 | 2× RTX Pro 6000 Blackwell NVLink Bridge | 双卡NVLink互联,显存池化192GB |
| 存储 | 8TB NVMe SSD (U.2/U.3 企业级) + 40TB HDD | SSD做热数据缓存,HDD做冷存储 |
| 网络 | 100GbE InfiniBand 或 25GbE 以太网 | 连接超算或分布式训练 |
避坑提示:
- EPYC 9654/9754是Zen 4,9965是Zen 5c(紧凑型核心),9755是Zen 5(全性能核心),别混为一谈。对于CCSD(T)这类依赖单核性能的计算,Zen 5架构的9755可能比Zen 5c架构的9965更合适
- 双路EPYC必须插满24条内存才能跑满内存带宽,别省这个钱
- VASP的GPU加速对显存带宽敏感,RTX Pro 6000 Blackwell的GDDR7有优势
Level 4:集群级——高通量筛选与千卡训练
定位:十万级催化剂筛选、通用势能模型训练、服务整个课题组
核心配置:
| 节点类型 | 配置要点 |
|---|---|
| 计算节点 | 双路 EPYC 9965 + 4× H100 80GB NVLink全互联 |
| 存储节点 | 100TB+ Lustre/GPFS 并行文件系统 |
| 登录节点 | 单路 EPYC + 大内存,用于作业提交和轻量后处理 |
| 网络 | 200GbE InfiniBand NDR 全 fat-tree 拓扑 |
软件栈:
- 作业调度:Slurm
- 容器化:Singularity/Apptainer(封装VASP、DeePMD-kit环境)
- 分布式训练:PyTorch DDP + DeepSpeed(训大模型用)
六、避坑指南:AI时代计算化学的硬件陷阱
陷阱1:盲目堆CPU核数,忽视单核性能
CCSD(T)这种计算,64核和128核可能没啥区别——它根本跑不满。买EPYC 9654(96核)不如买EPYC 9575F(64核但频率高),后者单核性能更强,对CCSD(T)更友好。
陷阱2:GPU只看CUDA核心数,忽视显存和带宽
MLIP训练不是打游戏,显存容量和带宽比CUDA核心数更重要。RTX 4090的24GB显存训练大体系MLIP会OOM,而RTX Pro 6000 Blackwell的96GB显存能一次塞进整个batch。
陷阱3:忽视存储性能,轨迹文件拖垮SSD
MD轨迹是顺序写大文件,消费级QLC SSD的缓外写入速度可能跌到100MB/s,跑一天MD就卡死。必须用企业级TLC SSD,或者上Intel Optane(如果还能买到)。
陷阱4:软件授权没算清,买完硬件买不起license
VASP的授权按核收费,买双路192核服务器,授权费可能比硬件还贵。先算授权账,再定配置。
陷阱5:网络带宽瓶颈,分布式训练变”分布式等数据”
做多卡MLIP训练,PCIe交换机和InfiniBand是刚需。别指望万兆以太网能喂饱4张H100。
七、写在最后:算法在变,但物理不会变
SurFF的10⁵倍加速很诱人,但它解决的是**”算得慢”的问题,不是“算得准”**的问题。
催化剂设计的终极挑战——反应机理的精确描述、过渡态的准确定位、溶剂效应的真实模拟——仍然需要DFT乃至CCSD(T)的精度。MLIP是加速器,不是替代品。
硬件投资的原则:
- 算法决定硬件:做DFT堆核,做CCSD(T)堆内存,做MLIP堆GPU
- 分层配置:别指望一台机器干所有活,工作站+超算的组合更务实
- 预留升级:催化剂设计的数据量每年翻倍,存储和内存要留足余量
最后,引用王笑楠团队SurFF论文里的一句话:
“机器学习不是为了让计算化学家失业,而是为了让他们把注意力放在真正重要的问题上——比如,设计更好的催化剂。”
工具只是手段,科学发现才是目的。
文章关键词:催化剂设计、DFT计算、机器学习势、SurFF模型、VASP、Gaussian、CCSD(T)、DeePMD、分子动力学、计算化学工作站、GPU加速、主动学习
相关阅读推荐:
- 王笑楠等, Nature Computational Science, 2025, SurFF模型
- DeepMD-kit官方文档:https://github.com/deepmodeling/deepmd-kit
- VASP 6.6 GPU加速指南:https://www.vasp.at/wiki












