
本文采用技术分析视角,以清华大学计算化学研究为参照系探讨行业趋势。文中提及的学术成果均来自公开文献,不代表任何官方立场。硬件配置建议仅供参考。
一、写在前面:溶剂效应——计算化学的永恒难题
2025年7月8日,清华大学朱永法教授和香港大学汤初阳教授团队(第一作者郭燕)在Nature Communications发表了一项引人注目的研究:通过设计电荷互补的π电子位点,他们开发的卟啉基光催化剂实现了1.85%的光-化学转换效率(SCC),在纯水和氧气输入条件下,每天可光合成生产80 L/m²的过氧化氢溶液。
这项工作的核心突破之一,是精确调控了催化剂与氧气分子之间的静电相互作用——而这种相互作用,强烈依赖于溶剂环境的建模。
在计算化学领域,溶剂效应的准确描述是一个老大难问题。显式溶剂模型精度高但计算量爆炸,隐式溶剂模型速度快但精度有限,QM/MM方法试图在两者之间找平衡,但分层策略的选择又带来新的困惑。
本文就从算法本质、前沿技术、行业痛点三个维度,聊聊分子性质预测中的多尺度方法如何与硬件配置相匹配。
二、算法本质:三种溶剂模型的精度-成本权衡
1. 隐式溶剂模型:高通量筛选的”快餐方案”
核心思想:把溶剂视为连续介质,通过介电常数和反应场近似溶剂效应。溶质分子被放置在一个空腔中,溶剂化自由能由静电贡献(ΔG_elec)、空腔形成能(ΔG_cav)和色散贡献(ΔG_disp)组成:
常见模型:
- PCM/CPCM(极化连续介质模型):求解泊松方程或广义玻恩方程
- SMD(基于溶剂化模型密度):Truhlar课题组开发,参数化程度高
- COSMO-RS(真实溶剂的导体类筛选模型):适合预测分配系数和溶解度
- GBSA(广义Born+表面积模型):分子动力学中常用
计算复杂度:O(N),与体系大小成线性关系
硬件需求特点:
- CPU:隐式溶剂DFT可以很好地并行化,64-128核都能吃到线性加速
- 内存:相对友好,每核2-4GB通常够用
- 存储:单点计算不产生大文件,但高通量筛选的日志文件需要归档
适用场景:
- 构象搜索和初步筛选
- 大体系(蛋白质-配体相互作用)的粗略评估
- 溶剂化自由能的高通量预测
精度天花板:隐式模型是溶剂的”平均场”近似,无法捕捉具体的氢键网络、局部溶剂密度波动等微观细节。
2. 显式溶剂MD:精度与成本的”豪华套餐”
核心思想:把溶剂分子一个一个建出来,用分子动力学模拟采样溶质-溶剂相互作用的时间平均。
常用软件:
- GROMACS:开源免费,GPU加速成熟,适合蛋白质体系
- AMBER:力场参数丰富,生物分子模拟的首选
- NAMD:基于Charm++并行框架,超大规模体系(百万原子)效率高
计算复杂度:O(N log N)(由于PME长程静电处理),但还需要乘以模拟步数(纳秒级需要百万步)
硬件需求特点:
- GPU是刚需:现代MD计算90%以上的工作量由GPU完成
- GROMACS 2024:单张RTX 4090可达100+ ns/天(小蛋白体系)
- AMBER 24:支持多GPU并行,4卡A100可线性扩展
- NAMD 3.0:Charm++调度框架,适合多节点集群
- 显存决定体系规模:
- 24GB显存:适合50万原子以内
- 40-80GB显存:百万原子级体系
- 存储是黑洞:单次100ns模拟可产生50GB+轨迹文件,需要企业级SSD+大容量HDD分层存储
适用场景:
- 溶剂化结构的精确描述
- 动力学性质(扩散系数、粘度)预测
- 蛋白构象变化研究
痛点:采样不足。溶剂黏度导致构象变化慢,微秒级事件可能需要毫秒级模拟才能充分采样。
3. QM/MM:精度与效率的”平衡术”
核心思想:把体系分成两部分——
- QM区域(化学活性位点):用高精度量子化学方法(DFT、MP2、CCSD(T))
- MM区域(环境):用经典力场描述
能量表达式:
分层策略:
- ONIOM(Gaussian内置):机械嵌入方案,QM/MM区域间无直接电子相互作用
- 公式:Etotal=EI+IIMM−EIMM+EIQM
- 优点:可扩展至多层级(ONIOM3: High:Medium:Low)
- 缺点:层间相互作用描述粗糙,需要处理连接原子(link atoms)
- 电子嵌入(Electronic Embedding):MM原子的电荷极化QM电子密度
- 优点:静电相互作用更精确,适合激发态计算
- 缺点:计算量更大,SCF收敛可能更慢
计算复杂度:QM区域决定成本,O(N_QM³) + O(N_MM)
硬件需求特点:
- 单核性能优先:QM计算的SCF迭代是串行瓶颈,高主频CPU更有利
- 内存需求中等:取决于QM区域大小,通常64-256GB够用
- GPU支持有限:
- Gaussian 16:支持K80/V100/P100做DFT,但Post-SCF计算GPU效率不高
- Q-Chem:GPU加速逐步完善
- GROMACS+CP2K:支持QM/MM GPU加速(通过PLUMED接口)
适用场景:
- 酶催化反应机理
- 溶剂化效应的精确计算(小体系)
- 过渡态搜索(需要QM精度描述键断裂/形成)
关键决策:QM区域划多大?太大则算不动,太小则遗漏关键相互作用。
三、前沿技术:2025年溶剂效应计算的三大突破
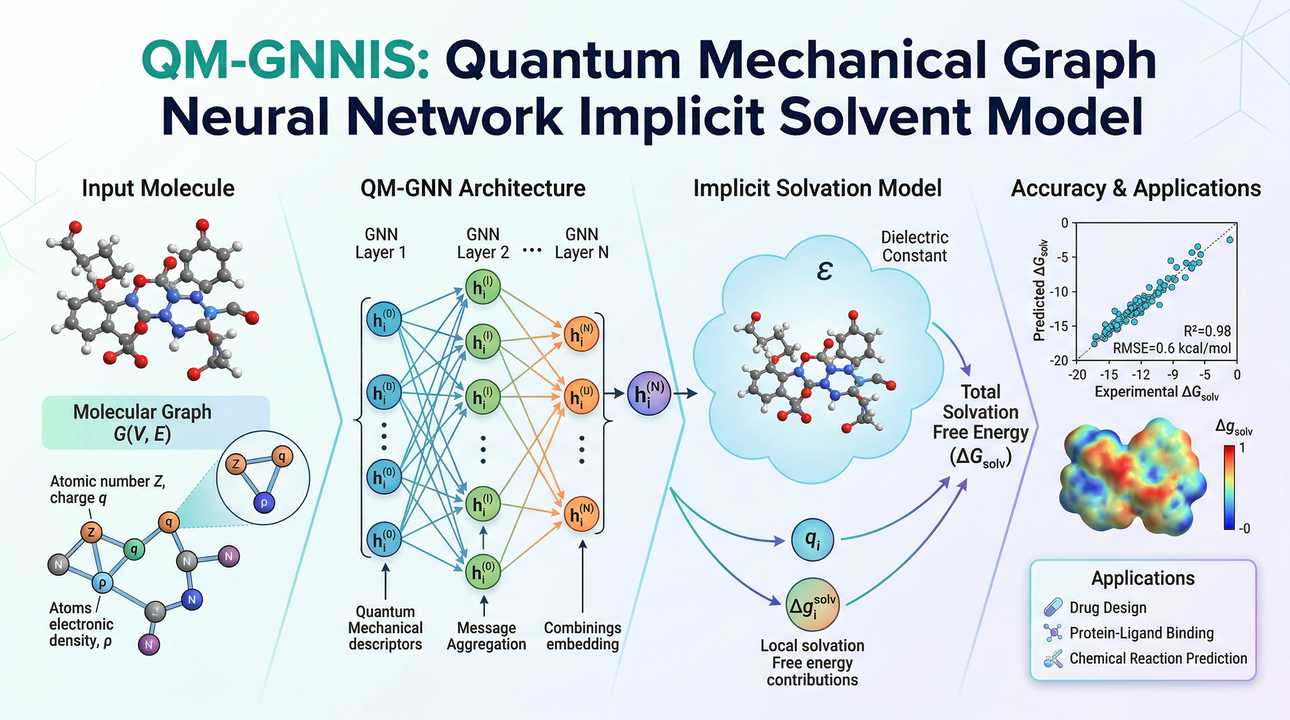
突破1:QM-GNNIS模型——AI重构隐式溶剂预测
2025年,研究人员提出了QM-GNNIS(Quantum Mechanical Graph Neural Network Implicit Solvent)模型——一种基于图神经网络的通用隐式溶剂模型。
核心创新:
- 通过知识迁移将经典分子动力学中学习的显式溶剂效应,叠加到QM隐式模型上
- 无需QM/MM参考数据或实验数据进行训练
- 与任意泛函和基组兼容,覆盖39种溶剂
性能表现:
- 在构象自由能预测上,显著优于SMD和openCOSMO-RS
- 在NMR和IR光谱的溶剂效应预测中,能捕捉其他模型难以还原的实验趋势
对硬件的启示:
- AI模型推理是GPU的甜点场景
- 但模型训练需要大量显存(推荐RTX Pro 6000 Blackwell 96GB或H100)
突破2:Δ-Learning——用气相数据预测溶剂化性质
核心思想:与其直接在溶剂化性质上训练ML模型,不如学习气相与溶剂化性质的差异(Δ-learning)。
优势:
- 气相QM数据丰富且计算成本低
- Δ值通常比绝对值更容易学习(变化范围小)
- 可利用气相的高精度计算结果
对硬件的启示:
- 需要同时支持高精度QM计算(CPU)和ML推理(GPU)的混合架构
突破3:主动学习+QM/MM——用最少的DFT办最多的事
结合主动学习策略,只挑最有信息量的构型做QM/MM计算,构建势能面数据库。
工作流程:
- 用经典力场做初步MD采样
- 用不确定性量化筛选”难搞”的构型
- 只对筛选出的构型做QM/MM计算
- 用新数据更新ML势,迭代优化
对硬件的启示:
- 需要弹性算力:平时用GPU跑ML推理,关键时刻调用CPU资源做QM/MM
四、行业痛点:多尺度计算的四大焦虑
痛点1:精度与成本的永恒博弈
| 方法 | 精度 | 成本 | 适用场景 |
|---|---|---|---|
| 隐式溶剂DFT | ★★☆ | O(N) | 高通量筛选 |
| QM/MM | ★★★ | O(N_QM³) | 反应机理 |
| 显式MD | ★★★ | O(N log N) × 步数 | 动力学性质 |
| 显式QM/MM-MD | ★★★★ | 天价 | 文献报道 |
没有银弹,选择方法时必须权衡精度需求和计算预算。
痛点2:QM区域划分的”玄学”
- 划小了:遗漏关键残基或溶剂分子,结果定性错误
- 划大了:算不动,SCF不收敛
- 化学键截断:ONIOM需要引入连接原子(link atoms),引入额外近似
经验法则:
- 酶催化:活性位点+直接配位的残基(通常50-100原子)
- 溶剂化:第一溶剂化壳层+部分第二壳层
- 蛋白质-配体:配体+关键相互作用残基(如氢键供体/受体)
痛点3:力场参数的”坑”
MM区域的精度取决于力场参数的质量:
- 标准氨基酸:AMBER、CHARMM、OPLS-AA都很成熟
- 非天然底物:需要自己拟合参数(电荷、Lennard-Jones参数)
- 金属离子:极化效应难以描述,需要可极化力场(AMOEBA)或特定参数
痛点4:软件生态的碎片化
| 任务 | 推荐软件 | 痛点 |
|---|---|---|
| 隐式溶剂DFT | Gaussian, ORCA | 商业软件贵,开源软件功能有限 |
| QM/MM | Gaussian, Q-Chem, AMBER | 各家用法不一,学习成本高 |
| 显式MD | GROMACS, AMBER, NAMD | GPU加速支持差异大 |
| ML溶剂模型 | 自研框架 | 缺乏标准化工具 |
五、硬件配置分级:从入门到集群的四级跃迁
Level 1:入门型——隐式溶剂计算与教学
定位:小体系隐式溶剂DFT(<100原子)、学习QM/MM基础
核心配置:
| 配件 | 推荐规格 | 说明 |
|---|---|---|
| CPU | AMD Ryzen 9 9950X (16核32线程) | 单核性能强,Gaussian效率高 |
| 内存 | 128GB DDR5-5600 ECC | 足以应对大多数隐式溶剂计算 |
| 显卡 | RTX 4070 Ti SUPER 16GB | GROMACS小体系MD够用 |
| 存储 | 2TB NVMe SSD + 4TB HDD | SSD装系统,HDD存数据 |
避坑提示:
- 别买非ECC内存,长时间计算容易bit翻转
- Gaussian是商业软件,学术授权按核收费,别买太多核
Level 2:进阶级——QM/MM与小规模MD
定位:中等体系QM/MM(QM区域50-200原子)、常规MD模拟
核心配置:
| 配件 | 推荐规格 | 说明 |
|---|---|---|
| CPU | AMD Threadripper 7970X (32核64线程) | 四通道DDR5(Pro版7975WX为八通道),内存带宽高 |
| 内存 | 256GB DDR5-4800 ECC REG | QM/MM+MD双重需求 |
| 显卡 | RTX Pro 6000 Blackwell 96GB | 96GB显存能跑百万原子MD |
| 存储 | 4TB NVMe SSD (企业级) + 16TB HDD | 轨迹文件存储刚需 |
避坑提示:
- QM/MM的QM区域计算是串行瓶颈,别盲目堆核,优先高主频
- RTX Pro 6000 Blackwell的GDDR7带宽对MD性能提升明显
Level 3:专家级——组内共享与高通量筛选
定位:多用户并发、大规模QM/MM、显式MD模拟
核心配置:
| 配件 | 推荐规格 | 说明 |
|---|---|---|
| CPU | 双路 AMD EPYC 9575F (2×64核128线程) | 高主频版,适合QM计算 |
| 内存 | 1TB DDR5-4800 ECC REG (24×48GB) | 双路EPYC必须插满24条 |
| 显卡 | 2× RTX Pro 6000 Blackwell NVLink | 双卡192GB显存池化 |
| 存储 | 8TB NVMe SSD (U.2企业级) + 40TB HDD | RAID阵列防数据丢失 |
| 网络 | 25GbE 以太网 | 连接超算传输数据 |
避坑提示:
- EPYC 9575F是64核高主频版(4.5GHz+),比9654更适合QM计算
- NVLink桥接器必须买原厂,第三方兼容性问题多
Level 4:集群级——显式MD与AI溶剂模型训练
定位:微秒级MD采样、ML势训练、服务整个课题组
核心配置:
| 节点类型 | 配置要点 | |
|---|---|---|
| MD计算节点 | 双路 EPYC 9575F (2×64核128线程) + 4× H100 80GB NVLink全互联 | 高主频Zen 5架构(3.3-5.0GHz),适合GPU加速MD |
| QM/MM登录节点 | 单路 EPYC 9575F + 大内存,用于作业提交 | |
| 存储节点 | 100TB+ Lustre并行文件系统 | |
| 网络 | 200GbE InfiniBand NDR |
软件栈:
- 作业调度:Slurm
- 容器化:Singularity(封装GROMACS、AMBER、CP2K环境)
- ML框架:PyTorch DDP + DeepSpeed
六、避坑指南:多尺度计算的五大陷阱
陷阱1:用ONIOM做”小基组大基组”分层
错误做法:ONIOM(B3LYP/6-31G*:B3LYP/3-21G),试图用小基组省时间
问题:
- ONIOM分层引入层间相互作用近似,精度损失可能超过基组差异
- 不如直接用混合基组(6-31G*+3-21G)省钱又省心
正确做法:ONIOM用于QM:MM分层,而不是不同基组的分层。
陷阱2:QM区域划得过大或过小
划太大:SCF不收敛,计算时间爆炸
划太小:遗漏关键相互作用,定性错误
建议:
- 先做簇模型计算(cluster model),确定最小必要区域
- 逐步扩大QM区域,观察能量/结构是否收敛
- 对于酶催化,包含第一配位层+直接氢键供体/受体通常够用
陷阱3:忽视力场参数质量
问题:
- 非标准残基、非天然底物缺乏现成参数
- 金属离子参数质量参差不齐
建议:
- 用Antechamber(AMBER)或SwissParam生成近似参数
- 对于金属酶,考虑用QM/MM全QM描述配位环境
- 可极化力场(AMOEBA)对金属体系更准确,但计算成本更高
陷阱4:MD采样不足就下结论
问题:
- 溶剂黏度导致构象变化慢,短模拟(<10ns)可能困在局部极小
- 蛋白-配体结合/解离事件可能需要微秒级模拟才能观察到
建议:
- 用增强采样方法(伞形采样、metadynamics、副本交换MD)
- 多轨迹并行,统计平均比单条长轨迹更可靠
- 结合实验数据验证模拟时间尺度是否足够
陷阱5:软件版本不匹配导致结果不可复现
问题:
- GROMACS 2024 vs 2023:力场参数可能有微调
- AMBER 24 vs 22:GPU加速算法改进,数值结果可能有微小差异
建议:
- 论文中明确记录软件版本号和力场参数文件版本
- 关键结果用多个软件交叉验证
- 用容器(Singularity/Docker)固化计算环境
七、写在最后:方法选择比硬件更重要
在多尺度计算化学领域,方法选择的智慧往往比硬件配置更能决定研究成败。
- 做高通量药物筛选?隐式溶剂+ML模型是性价比之选
- 研究酶催化机理?QM/MM是必要工具,但QM区域划分需要化学直觉
- 预测动力学性质?显式MD是唯一选择,但采样时间需要仔细评估
正如清华大学朱永法教授团队在光催化研究中展示的:准确的溶剂效应建模,往往是突破性能瓶颈的关键。
硬件投资的原则:
- 方法决定硬件:隐式DFT堆核,QM/MM看单核+内存,显式MD靠GPU
- 分层配置:工作站用于方法开发和初步测试,超算用于生产级计算
- 软件先行:先确定要用的软件(Gaussian授权费用、GROMACS/AMBER的GPU支持),再定硬件
最后,引用Schrödinger公司的一句话:
“计算化学不是关于算得更快,而是关于算得更聪明。”
选择合适的方法,比盲目升级硬件更能提升研究效率。
文章关键词:溶剂效应、隐式溶剂模型、显式溶剂MD、QM/MM、ONIOM、分子动力学、GROMACS、AMBER、NAMD、Gaussian、分子性质预测、多尺度计算
相关阅读推荐:
- 朱永法等, Nature Communications, 2025, 光催化过氧化氢合成
- Katzberger et al., J. Chem. Theory Comput., 2025, QM-GNNIS模型
- GROMACS 2024 GPU加速指南:https://manual.gromacs.org












