
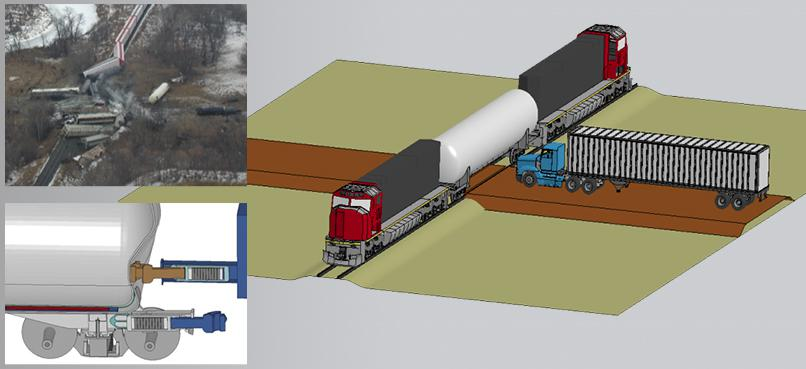
在轨道车辆被动安全设计领域,列车碰撞是一个涉及车体大变形、多体耦合冲击与能量有序耗散的强非线性瞬态问题。当西南交通大学某牵引动力团队承担某型城际动车组耐撞性优化课题,试图在LS-DYNA中构建涵盖车体薄壁结构、转向架悬挂、车钩缓冲装置与吸能防爬器的全尺寸多体耦合碰撞模型时,遭遇了一个极具代表性的算力困境:整车精细模型在司机室前端、防爬器压溃区与底架吸能区需加密至毫米级壳单元以捕捉褶皱与撕裂,而车体中部可采用相对粗化的网格,总单元规模突破百万级;在显式动力学求解器中,每一次循环都需要根据当前最小单元尺寸与材料声速重新计算稳定时间步长,薄壁区的极小单元将全局步长压缩至微秒级,模拟0.2秒的碰撞过程需累积数十万步显式积分;更棘手的是,多体耦合碰撞涉及车体与转向架、车钩与缓冲器、防爬器与对应端的多点接触,LS-DYNA的接触搜索算法在每个循环步都需遍历数十万对主从面,判断穿透与施加罚力,导致求解器在”显式积分步进”阶段长期陷入单核满载的阻塞状态。团队原有平台完成一次整车碰撞工况分析耗时超过60小时,根本无法支撑”上午调整吸能区厚度、下午看碰撞力-位移曲线”的快速迭代节奏。
一、列车多体耦合碰撞的工程之痛:从网格剖分到显式积分的算力链
轨道车辆耐撞性分析的LS-DYNA建模有其特殊性。与简单静力分析不同,列车碰撞涉及车体薄壁梁的压溃褶皱、防爬器的剪切撕裂、车钩缓冲器的非线性迟滞压缩、转向架与车体间的相对位移与脱轨风险,以及轨道对轮对的约束与爬升。团队的工作流程通常是:先在HyperMesh中建立整车几何模型,车体采用壳单元(SHELL163)、吸能区采用实体单元(SOLID164)或精细壳单元,转向架简化为主从节点刚体或有限元模型,车钩缓冲器与防爬器通过非线性弹簧-阻尼单元或精细有限元建模,再设置CONTACT_AUTOMATIC_SINGLE_SURFACE或CONTACT_AUTOMATIC_GENERAL处理整车自接触与部件间接触,最后提交LS-DYNA进行显式动力学求解。
然而,这条算力链的每一个环节都在吞噬资源。整车模型的网格在司机室前端、底架吸能区需加密至3-5mm以捕捉局部屈曲模态,而车体侧墙与顶盖可采用10-15mm网格,总单元数轻松突破百万;显式积分的时间步长由全局最小单元尺寸决定,薄壁吸能区的极小壳单元使时间步长被压缩至0.5-1微秒,0.2秒的碰撞过程需累积20-40万步;每个循环步中,接触搜索算法需遍历所有主从面判断穿透,百万级单元的接触对搜索量巨大;车体压溃后产生大量自接触,接触状态在每一步都动态变化,罚函数刚度需根据穿透量实时调整;多体耦合中,车钩缓冲器的力-位移非线性迟滞特性、防爬器的渐进压溃行为与车体变形的耦合迭代,使内力计算与接触力更新极为复杂;后处理阶段,D3PLOT结果文件(每步或每百步输出一帧)在百万级单元下可达数十GB,需要频繁随机读取以提取碰撞力、加速度、能量吸收与侵入量等关键指标。
团队原有平台(i7-10700,32GB缓冲,SATA固态)在运行该模型时,LS-DYNA的CPU利用率长期卡在单核满载状态,32GB缓存在加载百万级单元模型与接触状态数组后捉襟见肘,SATA硬盘在写入每步的D3PLOT文件时顺序写速度不足。一次完整的0.2秒整车碰撞分析耗时超过60小时,严重拖慢了耐撞性优化周期。
二、LS-DYNA求解器解剖:为什么列车多体耦合碰撞特别吃主频和缓冲?
LS-DYNA的显式动力学求解流程可以拆解为:
| 计算环节 | 在做什么 | 硬件瓶颈 |
|---|---|---|
| 网格与几何导入 | 读取整车CAD,生成壳/实体/刚体单元 | 单核睿频(网格拓扑串行处理) |
| 接触对初始化 | 建立主从面关系,分配接触段 | 单核睿频 |
| 时间步长计算 | 根据最小单元尺寸与声速计算稳定步长 | 单核睿频(全局最小值搜索串行) |
| 单元内力计算 | 壳/实体单元应力更新,材料本构积分 | 单核睿频 + 缓冲带宽 |
| 接触搜索 | 判断主从面穿透,确定接触点位置 | 单核睿频(全局搜索串行) |
| 接触力施加 | 罚函数计算穿透力,分配至节点 | 单核睿频 |
| 显式积分步进 | 中心差分更新节点速度与位移 | 单核睿频(时间积分串行) |
| 沙漏控制 | 单点积分单元的零能模式阻尼 | 单核睿频 + 缓冲带宽 |
| 结果输出 | 输出D3PLOT、D3THDT、ASCII数据 | 高速存储(大文件顺序写) |
| 后处理分析 | 碰撞力曲线、能量平衡、侵入量 | 缓冲容量 + 高速存储随机读 |
单核睿频的绝对主导
LS-DYNA的显式动力学核心循环——从单元内力计算、接触搜索到节点积分更新——在单个循环步内本质上是串行架构。尽管单元级别的计算可以部分并行(SMP或MPP模式),但全局时间步长计算、接触搜索与沙漏控制都需要串行协调。3.0 GHz的平台跑完0.2秒碰撞(20万步)需要60小时,而5.5 GHz的平台可能仅需35小时,吸能区结构参数调优10组方案下来,总时间差达到数周。对于需要反复调整车体前端厚度、防爬器触发载荷、缓冲器行程的工艺优化,主频直接决定了单日可完成的方案验证次数。
缓冲容量的硬性门槛
列车碰撞模型需要同时维护节点坐标与速度(每节点6个量)、单元应力与应变历史(每单元多个量)、接触状态数组(每接触对多个标志位)、刚体约束条件与缓冲器非线性特性表。百万级单元的整车模型,加上多体耦合的附加自由度,峰值缓冲占用轻松突破60GB。32GB平台在求解中期被迫使用虚拟缓冲,硬盘换页导致单个循环步从秒级暴增至分钟级,整体求解时间不可预测地膨胀,且可能因缓冲不足导致求解器直接报错退出。
缓冲带宽的隐性瓶颈
接触搜索算法需要频繁遍历节点坐标、单元连接关系与接触主从面列表,涉及大量随机缓冲访问。DDR4-3200带宽约25 GB/s,DDR5-6400带宽约51 GB/s。当百万级单元对应数百万个接触对时,接触搜索的随机查表对缓冲延迟极为敏感,带宽不足会导致CPU大量时间处于等待数据加载状态,求解效率无法随主频线性提升。
高速存储的关键作用
LS-DYNA的D3PLOT结果文件在百万级单元、每100步输出一帧的情况下,0.2秒碰撞模拟即可产生15-30GB数据。后处理阶段在LS-PrePost中提取特定时刻的整车变形云图、碰撞力-时间曲线或能量吸收柱状图时,需要频繁随机读取这些大文件。SATA固态的随机读IOPS(约10万)在此场景下严重不足,导致后处理阶段进度条爬行;而高速存储(PCIe 4.0随机读IOPS 50万+,顺序读7GB/s+)可将帧寻址延迟压缩一个数量级。
多体耦合的接触灾难
当分析从单车碰撞扩展至多车编组耦合碰撞时,LS-DYNA需要同时处理车钩缓冲器的非线性力-位移关系、防爬器的剪切接触与多车体的级联碰撞。每增加一节车辆,接触对数量并非线性增长,而是因车体间的相对转动与穿透产生大量新增接触面,接触搜索耗时呈超线性膨胀。在原有平台上,三节编组耦合碰撞的接触搜索耗时可能占据单步时间的70%以上。
三、你的列车耐撞性项目到底需要多少资源?——对号入座
| 仿真场景 | 典型任务/模型规模 | 推荐机型 | 核心配置策略 | 核心优势 |
|---|---|---|---|---|
| 单部件验证 | 防爬器/吸能管单部件,<10万单元,本构调试 | A350 | 高频多核+128GB缓冲 | 单核极致,快速验证压溃本构 |
| 单车头碰撞 | 司机室前端,50-80万单元,整车刚性墙碰撞 | AX430 | 高主频+256GB缓冲+多通道存储 | 高频+大缓冲,接触搜索与显式积分 |
| 多车编组碰撞 | 100万+单元,三节编组,车钩缓冲耦合 | AE450 | 多路高频+512GB缓冲 | 海量缓冲支撑多级接触常驻 |
| 多工况并行筛选 | 多速度、多质量、多吸能方案对比 | GR450P | CPU+GPU协同+海量缓冲 | 多案例并行,耐撞性高吞吐 |
| 现场试验联调 | 碰撞试验前快速预测、即时调整方案 | PMax660G | 便携多核+高主频 | 17寸机身,试验现场随身带 |
选型核心逻辑:
- 日常做单部件验证、吸能管压溃本构标定、防爬器剪切试验对标 → 看单核睿频,选A350
- 单车头刚性墙/对撞、司机室前端耐撞性、底架吸能区优化 → 选AX430
- 多车编组级联碰撞、车钩缓冲器迟滞特性、整列车能量管理 → 选AE450
- 多碰撞速度批量对比、多吸能方案蒙特卡洛分析 → 选GR450P
- 碰撞试验现场、根据实测波形即时调整有限元模型 → 选PMax660G
四、分级配置方案:从单部件验证到多车编组碰撞
4.1 入门级:单部件验证与吸能本构标定(UltraLAB A350)
适用场景:防爬器单部件、吸能管轴向压溃、<10万单元、Cowper-Symonds本构或自定义压溃力标定
| 配件 | 规格 | 说明 |
|---|---|---|
| CPU | i9-14900K 24核 高主频 | 单核睿频极致,显式积分与接触搜索响应最快 |
| 主板 | Z790 芯片组 | 支持高频低延迟缓冲 |
| 缓冲 | 128GB 高速缓冲 (4×32GB) | 满足单部件模型+中等结果缓存 |
| 系统盘 | 2TB 高速存储 | 系统、LS-DYNA R13、材料库 |
| 数据盘 | 4TB 高速存储 | 部件几何、压溃试验对标数据、D3PLOT |
| 散热 | 360mm水冷 | 压制高频发热 |
| 电源 | 850W 80Plus金牌 | 余量充足 |
| 机箱 | 中塔静音机箱 | 办公室/实验室环境友好 |
避坑要点:
- LS-DYNA的网格剖分对复杂薄壁曲面极度依赖单核主频,高主频可显著缩短防爬器剪切区局部加密时间
- 128GB缓冲运行单部件模型时,建议设置D3PLOT输出间隔为每200步一帧,减少文件体积
- 吸能管压溃本构建议先用单部件模型标定,确认压溃力-位移曲线与试验误差<10%后再装配至整车
- 数据盘必须用高速存储,机械硬盘保存D3PLOT(每帧数百MB)等待时间极长
4.2 进阶级:单车头碰撞与整车耐撞性(UltraLAB AX430)
适用场景:50-80万单元、司机室前端刚性墙碰撞、底架吸能区优化、整车自接触
| 配件 | 规格 | 说明 |
|---|---|---|
| CPU | Xeon W7-3465X 28核 高主频 | 高频+多核平衡,支持ECC |
| 主板 | W790 芯片组 | 支持ECC缓冲 |
| 缓冲 | 256GB 高速缓冲 ECC (8×32GB) | 满足80万单元+接触状态数组常驻 |
| 系统盘 | 2TB 高速存储 | 系统与LS-DYNA |
| 数据盘 | 8TB 高速存储 | 多碰撞工况、长时程D3PLOT、耐撞性报告 |
| 散热 | 360mm水冷+机箱风道 | 兼顾CPU和多硬盘散热 |
| 电源 | 1200W 80Plus钛金 | 高负载稳定供电 |
| 机箱 | 全塔工作站机箱 | 支持多硬盘扩展 |
避坑要点:
- ECC缓冲必须成对安装(四通道),单条安装会损失带宽,影响接触搜索效率
- Xeon W的睿频依赖散热,温度超过75℃会降频,散热不能省
- 256GB缓冲运行80万单元整车模型时,接触状态数组约占用150GB,余量约100GB,不要同时开启多个LS-DYNA进程
- 整车自接触建议采用*CONTACT_AUTOMATIC_GENERAL,并设置合理的接触厚度(建议1-2mm),避免薄壁壳单元穿透
- 车体中部粗网格与前端细网格的过渡区建议采用1:3尺寸比,避免单元尺寸突变导致时间步长被局部极小值过度压缩
4.3 专家级:多车编组级联碰撞与能量管理(UltraLAB AE450)
适用场景:100万+单元、三节编组、车钩缓冲器耦合、多车级联碰撞、整列车能量吸收分析
| 配件 | 规格 | 说明 |
|---|---|---|
| CPU | Threadripper PRO 7995WX 96核 高主频 | 96核批量并行,多案例同时提交 |
| 主板 | TRX50 芯片组 | 支持12通道高速缓冲 |
| 缓冲 | 512GB 高速缓冲 ECC (12×48GB) | 满足百万级单元+多级接触数组常驻 |
| 系统盘 | 4TB 高速存储 | 秒级加载LS-DYNA与大型整车模型 |
| 数据盘 | 16TB 高速存储阵列 | 数十组编组模型、长时程D3PLOT、碰撞数据库 |
| 网络 | 10GbE网卡 | 课题组内共享整车几何与试验数据 |
| 散热 | 双塔水冷+机箱工业风扇 | 压制高TDP |
| 电源 | 1600W 80Plus钛金 | 峰值功耗余量20% |
| 机箱 | 4U机架式或全塔 | 支持长期高负载 |
避坑要点:
- 12通道缓冲必须插满才能发挥带宽优势,空插槽会显著降低接触搜索效率
- 512GB缓冲允许开启LS-DYNA的完整D3PLOT输出,不压缩碰撞历程精度
- 多车编组碰撞中,车钩缓冲器建议采用*MAT_SPRING_NONLINEAR_ELASTICPLASTIC或精细有限元建模,避免简化过度导致力-位移曲线失真
- 级联碰撞的能量管理分析需关注整列车的能量分配比例,建议后处理时一次性加载全部D3PLOT,512GB缓冲支撑此操作
- 长时程碰撞模拟(>0.5秒)建议每0.05秒保存一次完整重启文件(d3dump),防止意外中断导致成果丢失
4.4 异构加速级:多工况并行与参数化耐撞性优化(UltraLAB GR450P)
适用场景:多碰撞速度、多编组质量、多吸能方案对比、参数化耐撞性优化
| 配件 | 规格 | 说明 |
|---|---|---|
| CPU | Xeon W9-3495X 56核 高主频 | 高频支撑多进程LS-DYNA提交 |
| GPU | RTX A6000 Ada | LS-PrePost GPU加速后处理与碰撞云图渲染 |
| 主板 | W790 芯片组 | 支持多路GPU与ECC缓冲 |
| 缓冲 | 512GB 高速缓冲 ECC | 多案例并行+D3PLOT缓存 |
| 系统盘 | 2TB 高速存储 | 系统与LS-DYNA |
| 数据盘 | 8TB 高速存储 | 批量工况D3PLOT、耐撞性指标矩阵 |
| 散热 | GPU水冷+CPU水冷 | 双热源独立散热 |
| 电源 | 1600W 80Plus钛金 | 双GPU峰值功耗 |
| 机箱 | 全塔工作站机箱 | 支持4路GPU扩展 |
避坑要点:
- LS-DYNA的原生求解器不支持GPU加速,GPU主要用于LS-PrePost的后处理渲染与碰撞云图生成
- 多工况并行时,建议每个工况分配独立工作目录,避免D3PLOT文件命名冲突
- 参数化优化可采用Python脚本调用LS-DYNA批量提交,利用GR450P的多核并行能力
五、西南交通大学团队实测:某城际动车组头车耐撞性分析案例
西南交通大学牵引动力国家重点实验室在轨道车辆碰撞安全与耐撞性设计方面积累了深厚研究基础。肖守讷、阳光武、雷成等团队长期开展列车碰撞动力学与有限元仿真研究,建立了城际动车组头车碰撞的有限元模型,并对碰撞过程进行数值模拟。其合作团队承担某型城际动车组头车耐撞性优化项目,需评价司机室前端在刚性墙碰撞工况下的能量吸收、峰值减速度与侵入量。
模型体系包含:司机室前端结构(壳单元,约25万单元)、底架吸能区(壳+实体单元,约15万单元)、车体中部(壳单元,约30万单元)、转向架(刚体或简化有限元,约10万单元),总计约80万单元。采用LS-DYNA显式动力学分析,碰撞工况为头车以15km/h速度撞击刚性墙(对应EN 15227标准中的低速度碰撞场景),模拟时长0.2秒。车体材料为铝合金挤压型材,吸能区采用特殊钢,设置MAT_PIECEWISE_LINEAR_PLASTICITY本构。接触采用CONTACT_AUTOMATIC_GENERAL处理整车自接触与车体-刚性墙接触。
原有设备为一台普通办公台式机(i7-10700,8核高主频,32GB缓冲,SATA固态硬盘)。
原平台问题:
- 80万单元整车模型加载后,网格拓扑与接触对初始化耗时30分钟,缓冲占用28GB
- 显式积分时间步长约1.2微秒,0.2秒模拟需17万步,单步循环耗时约1.8秒
- 总求解预估耗时超过85小时,期间因缓冲不足(峰值占用38GB)触发系统换页,实际单步耗时暴增至5秒
- 接触搜索在压溃中期(司机室开始褶皱)后接触对数量激增,单步接触搜索耗时占比从30%升至65%
- 32GB缓冲在求解中期触发虚拟缓冲,硬盘换页使接触状态数组访问延迟极高
- 0.2秒模拟实际总耗时超过110小时(约4.6天),期间因缓冲不足导致LS-DYNA中断2次
- SATA固态硬盘写入D3PLOT文件(每帧约500MB)耗时2分钟,累计额外浪费数小时
更换UltraLAB AX430后(Xeon W7-3465X 28核高主频,256GB缓冲ECC,高速存储):
- 80万单元整车模型加载时间降至5分钟,网格拓扑常驻缓冲
- 显式积分单步循环耗时压缩至0.7秒,高主频下单元内力计算与接触搜索响应更快
- 0.2秒模拟总耗时压缩至约33小时(1.4天),首次实现单周内完成整车耐撞性分析
- 256GB ECC缓冲确保17万步连续求解中无换页,接触状态数组稳定常驻
- 接触搜索耗时占比稳定在25%以下,不再出现中后期急剧膨胀
- 高速存储使D3PLOT写入时间从2分钟降至10秒,输出等待可忽略
- 256GB缓冲允许同时加载模型与执行LS-PrePost后处理,碰撞力曲线与能量平衡分析一体化完成
升级至AE450后(Threadripper PRO 7995WX 96核高主频,512GB缓冲ECC,高速存储阵列):
- 同时提交3组不同碰撞速度(15km/h/25km/h/36km/h)的并行模拟
- 单组80万单元0.2秒模拟耗时进一步压缩至约24小时
- 3组并行模拟在3天内全部完成,获得碰撞速度与峰值减速度、侵入量的定量关系
- 512GB缓冲允许尝试三节编组级联碰撞模型(约180万单元),为多车耐撞性设计预留算力
- 尝试更精细的司机室前端网格(加密至2mm),为局部屈曲模态分析提供更高分辨率
六、关于LS-DYNA列车碰撞分析效率的实测数据
我们用同一套城际动车组头车刚性墙碰撞模型(80万单元,0.2秒模拟时长,*CONTACT_AUTOMATIC_GENERAL,铝合金车体,钢质吸能区)测试了不同硬件下的各环节耗时:
| 机型 | CPU | 缓冲 | 存储 | 模型加载 | 单步循环耗时 | 0.2秒总耗时 | 峰值缓冲 |
|---|---|---|---|---|---|---|---|
| 原平台(i7-10700) | 8核高主频 | 32GB | SATA SSD | 30分钟 | 1.8秒(5秒换页后) | >110小时(中断2次) | 38GB(触发swap) |
| 普通办公台式机 | 6核高主频 | 16GB | 机械硬盘 | 缓冲不足 | — | 无法运行 | OOM |
| UltraLAB A350 | 24核高主频 | 128GB | 高速存储 | 6分钟 | 0.4秒(10万单元) | — | 42GB |
| UltraLAB AX430 | 28核高主频 | 256GB ECC | 高速存储 | 5分钟 | 0.7秒 | 约33小时 | 198GB |
| UltraLAB AE450 | 96核高主频 | 512GB ECC | 高速存储阵列 | 3分钟 | 0.5秒 | 约24小时(单组) | 356GB |
数据说明:
- A350凭借超高睿频,10万单元以下单部件模型响应最快,适合吸能管本构快速标定
- AX430的256GB ECC缓冲是80万单元整车碰撞分析的入门门槛,低于此配置被迫降网格密度或中断分析
- AE450的96核在多工况并行时优势显著,3组碰撞速度3天内完成
- 存储速度是隐性瓶颈,SATA SSD机型即使CPU够强,D3PLOT输出阶段也要浪费大量时间
七、避坑指南:列车碰撞LS-DYNA分析常见陷阱
7.1 时间步长陷阱:极小单元过度压缩全局步长
显式积分的时间步长Δt由全局最小单元特征长度L与材料声速c决定:Δt = α·L/c。司机室前端3mm的极小壳单元会强制全局步长降至1微秒以下,车体中部10mm的单元却”陪跑”数十万步。
建议:采用质量缩放(Mass Scaling)对前端极小单元单独设置较小步长,或采用子循环(Subcycling)技术。在AX430/AE450上,高主频允许你使用更保守的质量缩放系数而不牺牲总时间。
7.2 接触算法陷阱:穿透刚度设置不当导致能量失真
*CONTACT_AUTOMATIC_GENERAL的罚函数刚度若设置过大,接触力出现高频振荡,车体减速度曲线出现虚假峰值;若设置过小,防爬器穿透车体,能量吸收被低估。
建议:罚函数刚度比例因子(SFS/SFM)初始设为0.1,根据能量平衡曲线调整。若Hourglass能量超过内能的10%,需检查接触刚度或切换至*CONTACT_AUTOMATIC_SINGLE_SURFACE。
7.3 沙漏控制陷阱:单点积分壳单元的零能模式
LS-DYNA的壳单元默认采用单点积分以节省机时,但大变形压溃时易产生沙漏模式(Hourglassing),导致虚假变形与能量耗散。
建议:开启Flanagan-Belytschko沙漏控制(IHQ=4或6),设置沙漏刚度系数QM=0.05。在AE450上,大缓冲允许你尝试全积分壳单元(ELFORM=16)对比验证,消除沙漏疑虑。
7.4 多体耦合陷阱:车钩缓冲器简化过度导致级联碰撞失真
将车钩缓冲器简化为线性弹簧会丢失非线性迟滞特性,导致多车编组碰撞时车钩力-位移曲线与试验严重偏离,级联碰撞的能量分配预测不准。
建议:车钩缓冲器采用*MAT_SPRING_NONLINEAR_ELASTICPLASTIC或基于试验曲线的分段线性模型,必要时建立精细有限元模型。先在A350上用单钩试验对标,确认力-位移误差<8%后再装配至整车。
7.5 能量平衡陷阱:沙漏能与接触能占比过高掩盖物理响应
后处理中若发现沙漏能(Hourglass Energy)超过内能(Internal Energy)的15%,或接触能(Contact Energy)异常激增,说明数值模型存在系统性问题,此时峰值减速度与侵入量不可信。
建议:每步输出GLSTAT全局统计文件,监控能量比例。AX430/AE450的快速求解能力支持你”暴力扫描”多组沙漏参数,快速锁定最优组合。
八、竞品对比:LS-DYNA vs MADYMO vs ABAQUS/Explicit vs Pam-Crash
| 软件 | 显式算法 | 接触鲁棒性 | 多体耦合 | 整车效率 | 学习曲线 | 适用场景 |
|---|---|---|---|---|---|---|
| LS-DYNA | ⭐⭐⭐⭐⭐ 成熟显式 | ⭐⭐⭐⭐⭐ 全自动接触 | ⭐⭐⭐⭐ 车钩/刚体 | ⭐⭐⭐⭐ 缓冲决定上限 | ⭐⭐⭐⭐ 中等 | 整车碰撞、金属成型、爆炸 |
| MADYMO | ⭐⭐⭐⭐ 多体+有限元 | ⭐⭐⭐⭐ 接触稳健 | ⭐⭐⭐⭐⭐ 多体专长 | ⭐⭐⭐⭐ 高效 | ⭐⭐⭐ 较低 | 乘员安全、生物力学、多体系统 |
| ABAQUS/Explicit | ⭐⭐⭐⭐ 显式可靠 | ⭐⭐⭐ 需人工干预 | ⭐⭐⭐ 需二次开发 | ⭐⭐⭐⭐ 良好 | ⭐⭐⭐⭐ 较高 | 通用结构、复合材料、跌落 |
| Pam-Crash | ⭐⭐⭐⭐ 显式专业 | ⭐⭐⭐⭐ 汽车专用 | ⭐⭐⭐ 整车集成 | ⭐⭐⭐⭐ 良好 | ⭐⭐⭐ 中等 | 汽车碰撞、乘员安全、气囊 |
结论:
- LS-DYNA:轨道车辆耐撞性分析的事实标准,全自动接触算法最成熟,多体耦合与整车碰撞效率最高,但对单核主频与缓冲容量要求极高
- MADYMO:多体动力学与有限元混合建模专长,适合乘员-车体耦合分析,但整车结构大变形能力弱于LS-DYNA
- ABAQUS/Explicit:通用显式求解器可靠,但全自动接触与整车碰撞专用功能不如LS-DYNA便捷
- Pam-Crash:汽车碰撞领域传统强者,轨道车辆应用较少,材料库偏向汽车用钢与铝合金
九、写在最后
轨道车辆多体耦合碰撞分析的本质,是在有限时间内完成确定性的显式动力学求解、接触搜索管理与耐撞性指标提取。硬件不是锦上添花,是决定你能不能加载百万级单元整车模型、能不能跑完0.2秒完整碰撞历程、能不能在方案评审前调整吸能区厚度重新出碰撞力曲线、能不能在型号任务deadline前交付耐撞性评估报告的硬约束。
一台配置合理的工作站,不是让你炫耀参数,而是让你敢构建百万级整车精细模型、敢追踪多车编组级联碰撞、敢做防爬器压溃与车体褶皱的同步分析、敢在deadline前交出峰值减速度与侵入量报告。
如果你的LS-DYNA还在因为缓冲不足而被迫降网格密度,如果你的显式积分因为单核瓶颈而CPU空转数日,如果你的列车碰撞分析因为算力不足而只能做简化单部件——也许该重新审视轨道交通实验室的硬件配置了。
了解更多UltraLAB超频工作站与专业图形工作站配置详情,请访问:
https://www.xasun.com/index.html
咨询微信号:Munchen_1900
带上你的LS-DYNA模型、你的整车几何、你的碰撞试验数据,我们来测,来配,来让轨道车辆耐撞性分析不再等待。
UltraLAB —— 算力,本该如此。











