专注高性能计算领域资讯
凌晨3点47分,那个作业还是没能活到天亮 凌晨3点47分,屏幕右下角弹出一行红字:Cannot allocate memory。 陈曦盯着终端愣了半分钟。他跑了六个小时的图计算作业,在加载邻接表的阶段就被系统杀掉了——这份数据是组里费了好大劲才拿到的真实社交关系图,200亿条边,导师安排第二天组会要看结果,开题报告也指着这份数据。此刻他大概想明白了问题出在哪:内存预算从第一行代码起就没打算放过这台 […]
从一则校园新闻说起 2025年12月,华中科技大学对外公布了一项进展:学校鲲鹏昇腾科教创新孵化中心基于完全国产化的昇腾算力平台,借助 vllm-ascend 推理框架,完成了华为盘古Pro MoE 72B 大模型的本地化部署,并面向校内师生开放应用服务。这则经中国教育报报道的消息,在高校圈里引起的讨论比想象中持久。 值得琢磨的是模型规模。72B 参数的 MoE 模型,权重文件超过 140 GB,放 […]
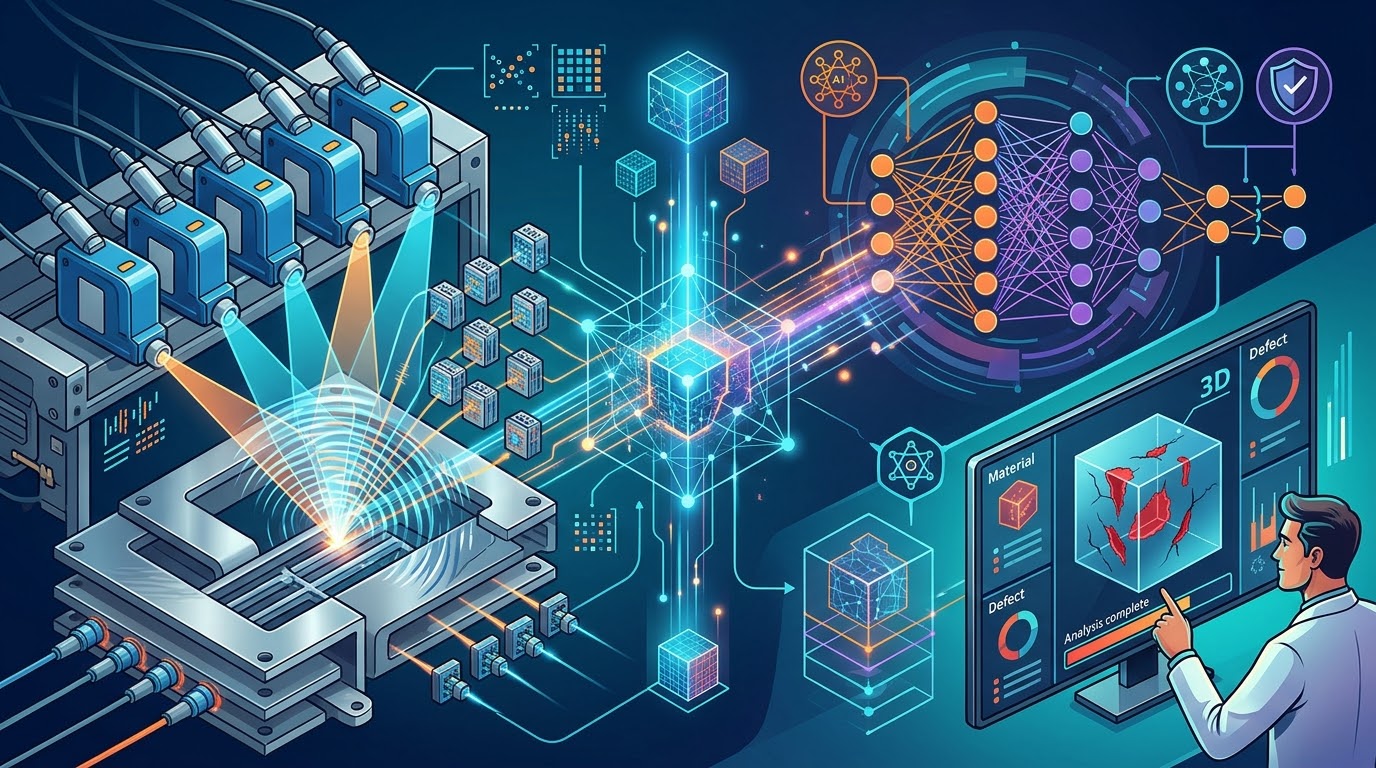
一、你懂的和你不懂的 测控技术与仪器专业的学生,对示波器、采集卡、传感器这些东西再熟悉不过。帮实验室焊过信号调理电路,用虚拟仪器软件写过采集程序,面对一台频谱分析仪也能很快上手。这是你们懂的。 但当你走进无损检测实验室,看到128阵元的相控阵超声探头扫查一块航空发动机构件,旁边那台机器的风扇狂转不止,那就是另一个世界了。这个世界里,评分体系完全不同:不看峰值跑分,看持续吞吐量;不看单帧速度,看连续 […]
AI代码生成号称”程序员的第二大脑”,函数补全、单元测试、脚本改写一行提示全搞定,GitHub Copilot云端一发,核心代码全泄露。CodeLlama本地部署成了涉密研发团队的刚需,可模型权重一加载,KV cache随上下文暴涨,生成速度掉到每秒几个token,程序员盯着光标干瞪眼。更头疼的是,业务源码、接口文档、算法实现全是企业的核心机密,数据涉密不敢传云端API,显 […]
引言:2017年6月12日,Google Brain团队的八位作者在arXiv上投递了一篇题为《Attention Is All You Need》的论文,全文仅11页,提出了一个名为Transformer的全新神经网络架构。论文的核心主张极具突破性:完全基于自注意力机制,不再依赖循环神经网络(RNN)或卷积神经网络(CNN)的序列处理方式。这一设计在当时并未立即引起广泛关注,因为它没有在标准基准 […]
说实话,看到AMD Zen 6架构的Venice EPYC处理器供不应求的消息,我倒不觉得意外。这事儿背后反映的其实是整个AI行业的一个尴尬现状——我们对算力的渴望,远远超过了半导体工厂的生产能力。 先说说让我印象深刻的几个数据。Zen 6 Venice处理器用的是台积电2nm工艺,单个CCD能塞下32个核心,8个CCD拼在一起就是256核的庞然大物。更夸张的是L3缓存能堆到1GB,能效还比上一代 […]
精选行业动态 + 全网热点,不遗漏关键信息