
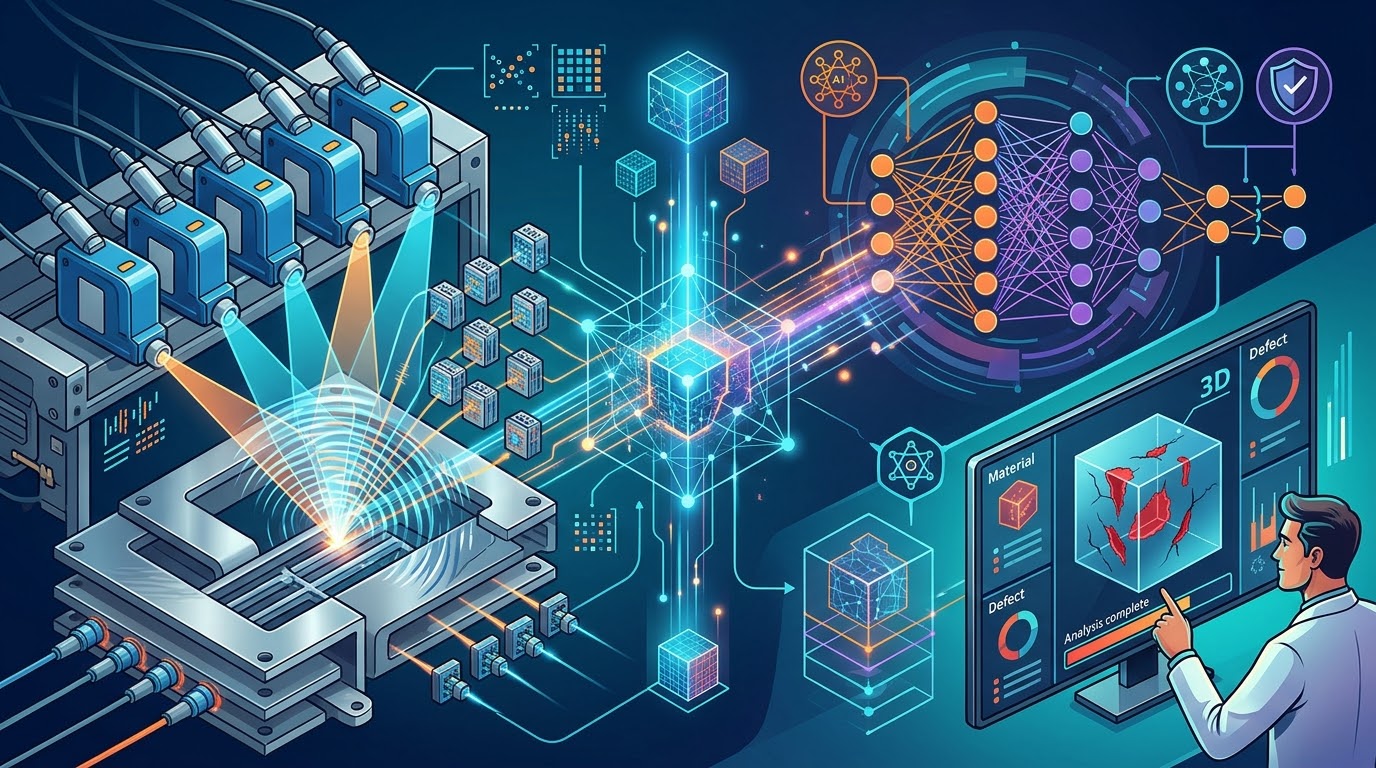
一、你懂的和你不懂的
测控技术与仪器专业的学生,对示波器、采集卡、传感器这些东西再熟悉不过。帮实验室焊过信号调理电路,用虚拟仪器软件写过采集程序,面对一台频谱分析仪也能很快上手。这是你们懂的。
但当你走进无损检测实验室,看到128阵元的相控阵超声探头扫查一块航空发动机构件,旁边那台机器的风扇狂转不止,那就是另一个世界了。这个世界里,评分体系完全不同:不看峰值跑分,看持续吞吐量;不看单帧速度,看连续满载几个小时稳不稳定;不看你最高能跑多大,看数据洪流涌过来的时候接不接得住。
这篇文章,就想用你熟悉的那些东西,把无损检测方向的算力需求讲明白。
二、先看几个有据可查的里程碑
无损检测这个方向,南京航空航天大学自动化学院测试工程系做了一辈子。说几件可以查证的事。
上世纪九十年代,孙雨施教授在远场涡流方向就有很好的研究和工业应用,拿过不少国家级和省部级项目。2005年前后,南航聘请英国纽卡斯尔大学讲席教授田贵云为特聘教授,牵头组建相控阵超声研究团队。经过多年积累,团队在2013年研制出相控阵超声原理样机,延时精度达到1纳秒,并参与制定了国家标准GB/T 32563-2016《无损检测 超声检测 相控阵超声检测方法》。实验室目前配备了三台相控阵超声仪器和128阵元多浦乐相控阵超声板卡,并部署了CIVA大型仿真软件用于相控阵仿真研究。
现任团队负责人王海涛教授,任工信部无损检测重点实验室副主任、江苏省仪器仪表学会无损检测仪器专委会主任,2010到2011年曾在中国商飞上海飞机设计研究院挂职,任飞行试验部副部长,主持C919试飞研制工作。2026年7月,江苏省仪器仪表学会无损检测仪器专委会学术年会暨中葡无损检测新技术国际会议在宝鸡举行,会议期间完成专委会换届,上半场由时任主任王海涛主持,下半场由新任主任朱永凯主持,南航在涡流阵列检测、光纤传感结构健康监测等方向的积累再次成为行业热点。
这些研究听着分散——超声、涡流、光纤传感——但底层是同一套事情:高频信号采集、海量波形存储、成像重建计算、缺陷特征提取。每一环都在吃算力。
三、类比一:游戏帧率与检测吞吐量
你可能帮人挑过显卡。游戏世界讲究帧率,跑分软件转一圈,数字越高越好。但跑分和真实游戏是两回事,和科研计算更两回事。
无损检测里的全聚焦成像(TFM),要把相控阵每个阵元轮流发射、其余阵元接收的全部信号拿来做相干叠加。128阵元的探头,一个扫查位置就产生128乘128等于16384条A扫波形;扫查一条焊缝,探头要移动几十上百个位置。波束合成对每个成像像素都要遍历全部收发组合,计算量随阵元数平方增长。
这样的负载有几个特点:单次计算不算大,但要连续跑几个小时;数据一直在来,机器不能中途歇口气;结果要实时显示给操作工看,卡住几秒,扫查节奏就被打乱。
消费级显卡的设计目标是短时爆发:瞬时加速频率冲得很高,跑完测试就回落。它的供电和散热按游戏场景的平均负载设计,真让它连续满载几小时,功耗墙和温度墙会让你见识什么叫性能衰减。科学计算要的是另一条路:频率不一定最高,但7乘24小时纹丝不动。
四、类比二:显存容量就是相机的RAW格式
玩摄影的都知道,RAW格式比JPG占地方得多。同一张照片,RAW的体积可能是JPG的十倍。为什么还要拍RAW?因为后期空间全在里面。
无损检测的全矩阵采集(FMC)是一个道理。传统电子扫描只存聚焦好的合成信号,数据量小;FMC把每个发射-接收对的原始波形全部保留下来。128阵元探头一个位置就是16384条波形,每条波形几千个采样点,单精度浮点存下来,一个位置就要上百MB原始数据。扫查完一条焊缝,几个GB很正常。
存RAW图的是事后灵活处理:换聚焦法则重新成像、换滤波参数重跑、对可疑区域做多角度复合。但这些自由的前提是数据和中间结果能放进内存和显存。TFM成像的中间数据立方体,显存放不下就得切块反复搬运,速度直接掉一个数量级。
所以显存不够被迫缩减数据规模,和像素不够被迫放弃裁图构图一样,都是妥协。无损检测的数据立方体,可比照片大多了。
五、类比三:散热系统是越野车的涉水喉
越野改装里最显眼的配件之一是涉水喉——发动机进气管延伸到车顶。不懂的觉得炫,懂的清楚这是保险:真过深水坑,进气口高一点,发动机就不熄火。
工作站的散热系统,就是科研版的涉水喉。
无损检测的现场环境不会给你恒温机房。夏天在机库里扫查航空构件,环境温度三十五度往上;采集和TFM成像同时满载,处理器和显卡的功耗拉满。风冷方案在空调房里压得住,到了现场,或者赶上实验室空调故障的盛夏,核心温度撞墙,系统开始降频。降频对游戏来说是帧数低点,对检测来说是灾难:采集时钟和计算不同步,数据丢帧,这一个扫查位置的数据作废,探头挪回去重扫。
水冷的价值就在这类时刻体现。它的意义很朴素:让你在恶劣工况下依然维持额定频率,把一整天的扫查任务稳稳做完。跑分高不高,它管不着。
六、类比四:品牌整机是原厂越野车
越野圈有个共识:第一台车别自己改,先买原厂。改装车可能更强,也可能半路上散架——差速锁装错了、半轴强度不够、电路私拉乱接。你的第一次无人区穿越,应该交给一辆出厂前就经过可靠性验证的车。
实验室第一台工作站,同理。
自攒机的麻烦在系统级兼容性没人兜底:采集卡驱动和主板芯片组冲不冲突,CUDA环境和采集软件抢不抢内存带宽,电源在多块满载显卡同时拉升功耗时扛不扛得住电压波动。单独看都是小概率,攒在一起就是实验室的日常。成熟的工作站平台,出厂前做过完整的兼容性验证和压力测试,出了问题一个电话有人上门。
对课题组更实际的一点是:设备要过采购验收和资产审计。品牌整机的完整质保、备件周期和合规手续,是自攒机给不了的。
七、AI大模型工作站部署:让标准和图谱开口说话
聊完检测本身,再说一件正在发生的事:大模型开始走进检测实验室。
无损检测是标准密集型行业,GB、GJB、ASTM标准每个几百页,工艺卡、验收级别、当量换算全靠人翻,研究生刚进组光熟悉标准就要几个月。检测做完之后的图谱判读和报告撰写,又严重依赖有经验的工程师。
本地部署开源大模型能同时解决这两件事,且数据不出内网。场景里有两类任务,正好对应两个模型。
第一类是标准问答与工艺卡生成。把单位积累的标准条文和检测规程接入检索增强问答,研究生问一句焊缝验收级别几级,模型直接给出条款出处和工艺参数建议。这类任务交给Qwen3-32B足够,32B规模对中文技术条款的理解已相当扎实。
第二类是缺陷图谱解读与报告初稿。R1-Distill-Llama-70B这类推理增强模型,可以对检测记录做更复杂的关联分析——结合历史数据、材料牌号、工艺窗口推断缺陷成因,生成报告初稿供工程师审核。
显存怎么算?公式很简单:所需显存约等于参数量(B)乘量化字节数再乘1.2,1.2是KV cache和系统开销的预留系数。FP16每个参数占2字节,Q8占1字节,Q4占0.5字节。Q4量化精度损失通常仅1~2个百分点,是消费级显存容量下的默认选择。两个算例:Qwen3-32B用Q4量化,32乘0.5乘1.2约等于19GB,留足长文档问答的上下文余量,24GB显存起步比较从容;R1-Distill-Llama-70B用Q4量化,70乘0.5乘1.2约等于42GB,单张消费级显卡装不下,48GB以上专业卡或双卡方案才能跑。
速度上要有心理预期:纯CPU推理受内存带宽限制,每秒只能出几个token,问一句等一分钟;单卡GPU推理每秒几十到上百token,体验才算可用。这就是这类部署需要工作站而不是普通办公电脑的原因。
最后说微调。要把模型适配到本单位专用的缺陷分类体系和报告格式,LoRA轻量化微调性价比最高。对32B模型做LoRA,显存增量约8到12GB,在推理所需显存基础上加这个余量即可;对70B模型做LoRA,增量约12到20GB。全参数微调远超推理——优化器状态、梯度和主权重副本都要占显存,通常是推理需求的数倍到十倍量级,70B级全参数微调奔着TB级去,超出单机能力范围。推理与微调的分水岭,直接决定配置档位能探到哪里。
八、软件生态:从采集到判读的流水线
硬件说完,软件也得捋一遍。
仿真端,CIVA是相控阵超声仿真领域的工业标准软件,南航实验室也在用,可以做探头设计、声场仿真和检测工艺验证。采集端,各相控阵设备厂商自带采集软件,数据格式各不相同,导出后通常要自己做格式转换。
处理端是算力主战场。波束合成和TFM成像有大量的并行计算实现;深度学习方面,用卷积神经网络对超声信号做自动缺陷分类,国内综述报道的铸件孔洞类缺陷分类精度已达94.5%;小波变换、经验模态分解、希尔伯特变换这些经典信号处理方法,则承担特征提取的脏活累活。加上成熟的GPU加速生态,从原始波形到缺陷判定的全流程基本都能覆盖。
大模型部署这块,开源推理框架对上述两个模型的支持都很完善,量化到Q4之后,问答和报告生成的响应速度都在可用范围。
九、配置推荐
技术原理、类比、部署方案都过了一遍,最后还是要回答那个最实际的问题:一台跑无损检测计算的工作站,到底该长什么样、花多少钱?前面聊过的数据立方体、TFM并行计算、持续满载稳定性,落到采购上就是不同档位之间的取舍。下面按任务规模分四档,每档给出适用场景、推荐机型和完整配置,对照自己的课题体量入座就是。
方案A:城市SUV,教学与常规检测信号处理
适用场景:本科教学实验、课程设计、常规单通道超声信号处理与小试件检测,不涉及全矩阵大数据量。
价格区间:4~7万
推荐机型:A350 15364-MBT
- CPU:Intel Core Ultra 7 265K 20核(8性能核全核5.3GHz/12能效核全核3.8GHz)(5.3GHz为全核超频实测优化频率)
- GPU:RTX 5090D v2 24G 水冷
- 内存:64GB DDR5
- 存储:2TB NVMe
- 显存带宽:1.34 TB/s
方案B:硬派越野,相控阵采集与实时成像
适用场景:研究生课题级的相控阵FMC采集与TFM成像、CIVA仿真建模、中等规模深度学习缺陷分类训练。
价格区间:10~18万
推荐机型:AE450 145128-MC2T
- CPU:AMD锐龙Pro 7970X 32核4.5G(4.5GHz为全核超频实测优化频率)
- GPU:双RTX 4090 48G 水冷(48GB为第三方定制版,非NVIDIA官方规格)
- 内存:128GB DDR5
- 存储:4TB NVMe
- 显存带宽:2×1.01 TB/s
方案C:专业拉力赛车,大数据量与缺陷智能判读
适用场景:多阵元全矩阵大数据量处理、深度学习缺陷识别模型训练、Qwen3-32B级别大模型本地部署与LoRA微调。
价格区间:20~40万
推荐机型:AX430 127384-MC2E
- CPU:Xeon金牌6530 32核2.7-4G(2.7~4GHz为全核超频实测优化频率)
- GPU:2×RTX 6000D 84G
- 内存:384GB DDR5
- 存储:4TB NVMe
- 显存带宽:2×1.57 TB/s
方案D:车队保障车,全流程智能化检测平台
适用场景:多通道并行在线检测、结构健康监测长周期数据分析、R1-Distill-Llama-70B级别推理模型本地运行、课题组公共算力平台。
价格区间:50~80万
推荐机型:GX660M 227640-MD4E
- CPU:2×Xeon金牌6530 64核2.7-4G(2.7~4GHz为全核超频实测优化频率)
- GPU:4×RTX Pro 6000 96G
- 内存:640GB DDR5
- 存储:8TB NVMe
- 显存带宽:4×1.79 TB/s
十、常见问题
本科生做无损检测方向,需要工作站吗?
课程阶段用实验室公用机器即可。但如果要参加无损检测相关的学科竞赛,或者进课题组做大学生创新项目,有一台入门级机器会方便很多:在自己的机器上调通算法再去实验室排队采数据,效率完全不同。
FMC数据到底比传统采集大多少?
传统电子扫描只存聚焦后的合成波形;FMC保留全部发射-接收对的原始信号。128阵元探头一个扫查位置就是16384条波形,是传统方式数据量的约128倍。一条普通焊缝扫查下来,原始数据几个GB起步。
大模型部署对检测研究有什么实际帮助?
最实在的三个用途:标准条文问答,省掉翻几百页标准的时间;检测工艺卡初稿生成;缺陷图谱解读报告初稿。模型只是辅助,最终判定仍由持证工程师完成,但能显著缩短报告准备时间。
笔记本加实验室服务器行不行?
行,但不是最优解。采集端的预处理在笔记本上经常卡壳,全矩阵数据笔记本的内存和显存放不下;服务器端大家排队,毕业季尤其紧张。一台工位级的塔式工作站,采、算、看一体,是很多课题组的务实解。
预算有限,先买哪一档?
看数据规模。只做常规超声信号处理和教学实验,方案A够用到硕士毕业;课题涉及相控阵全矩阵采集和深度学习,至少方案B;要把大模型部署和模型训练都搬到本地,方案C起步。
无损检测方向,CPU和GPU谁更重要?
分任务。采集控制和信号预处理吃处理器单核性能与内存带宽;TFM成像和深度学习训练吃显卡显存与算力;大模型推理两个都吃——显卡决定速度,内存容量决定能不能把标准库和数据立方体整个放进来。均衡搭配比堆单一项更划算。
结语
无损检测的世界正在变。相控阵全矩阵采集让数据量爆炸,深度学习让缺陷判读走向自动化,大模型让标准和经验变成可以问答的知识库。这三件事,全都指向同一个基础设施:一台能持续满载、接得住数据洪流的工作站。
从示波器到工作站,这笔账要算的是课题组未来几年能跑多快。
工作站配置选型欢迎咨询~
微信号:maxftxwx
fuyiqin@xasun.com












