
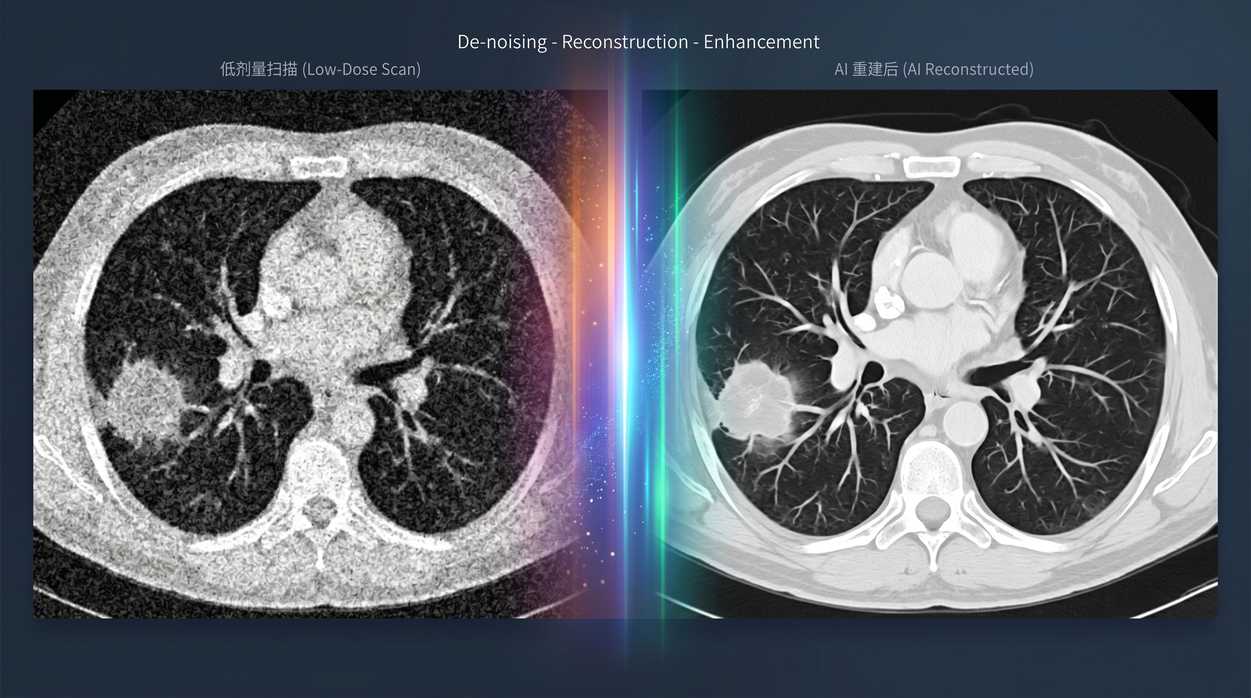
一、医学影像AI:从低剂量恢复到多模态融合的算力需求
2024年5月,北航医学科学与工程学院田捷教授团队在《Nature Reviews Clinical Oncology》上发表了一篇综述。这不是什么晦涩的理论——他们总结了近红外二区荧光成像技术从实验室到手术台的临床转化路径,让外科医生在术中直接”看见”肿瘤边界,把肝癌的检出率和手术精度往上提了一档。
田捷是谁?国家杰出青年基金获得者、教育部长江学者,在光学多模分子影像和影像组学领域做了二十多年。2007年Segal等人在Nature Biotechnology发表的开创性研究表明,基于CT影像的28个特征可重建78%肝癌的全基因变化图谱。田捷教授团队在此基础上进一步推进了影像组学在肝癌诊疗中的临床转化应用。换句话说,一张影像片子里藏着的生物学信息,远比肉眼看到的灰度阴影多得多。
把时间往后拨到2025年12月。北航生物与医学工程学院的另一支团队——杨智文、张嘉驹、易阳等人——在arXiv上挂出了一篇预印本。他们做了一个叫TAT(Task-Adaptive Transformer)的系统,用一个模型同时处理三件事:把低剂量PET恢复到正常剂量质量、给四分之一剂量的CT去噪、把4倍下采样的MRI超分辨率重建。三个任务,一套权重,性能不打折。这在医学影像AI里很罕见——通常一个任务一个专用模型,医院机房里的GPU集群被各种孤立模型占得满满当当。
北航生物医学工程学科在教育部第四轮学科评估里拿了A-,全国并列第四。学科从早期的医疗器械研究起步,到今天医学影像AI、手术机器人、可穿戴设备全覆盖。学生在本科阶段就开始接触DICOM(Digital Imaging and Communications in Medicine,医学数字成像和通信)数据处理、深度学习模型训练和临床验证——这些环节的算力需求,比传统工科更吃GPU。
二、医学影像AI到底在算什么
医学影像AI不是”让AI看片子”那么简单。它的核心是把三维像素矩阵里的微弱信号放大、把跨模态的信息对齐、把海量病例里的统计规律提炼成可迁移的模型参数。
低剂量影像恢复的本质是用算法换辐射剂量。患者怕辐射,医院想降低CT/PET的扫描剂量,但低剂量意味着信噪比暴跌,图像糊成一片。北航TAT系统的PET合成任务,输入是剂量减少12倍的低质量图像,输出要逼近标准剂量的清晰度。这背后是编码器-解码器结构的生成模型,在像素级做回归,损失函数要同时保真(不篡改解剖结构)和保锐(恢复边缘细节)。
多模态影像对齐的挑战在于,CT的骨窗和MRI的软组织不是一回事。同一个病灶在CT上显示为高密度影,在MRI T2加权上可能是高信号,在PET上则是代谢热点。多模态融合模型需要先把不同分辨率、不同对比度、不同扫描层厚的三维体积配准到同一坐标系,再做特征层面的交叉注意力。配准一步错位,后续融合全是噪音。
影像组学试图从灰度直方图里筛生物标志物。田捷团队做的肝癌基因预测,本质上是放射组学(Radiomics)——从影像中提取数百到数千个定量特征(纹理、形状、强度、小波系数),再和基因表达数据做关联分析。特征数量远高于样本量,过拟合是常态,需要严格的交叉验证和特征选择。
三维医学影像的数据规模不容小觑。一个标准CT序列大约512×512×数百层,16位灰度,单病例原始数据就几百MB。MRI的多序列(T1、T2、FLAIR、DWI)叠加,一个患者轻松上GB。训练一个3D U-Net或nnU-Net分割模型,百例级别数据集的训练集大小就几十GB。加上数据增强、多尺度输入和五折交叉验证,显存和存储的压力是组合爆炸。
三、这个方向的行业前景
AI辅助诊断从科研走向收费目录。2024年11月,国家卫健委等四部门印发《卫生健康行业人工智能应用场景参考指引》,明确推进AI辅助诊断、AI影像质控和AI手术规划的临床应用。部分地区已经把AI辅助肺结节筛查纳入医保收费试点。这意味着医学影像AI不再只是论文里的漂亮曲线,而是医院信息科要采购、要部署、要算运维成本的正经系统。
低剂量成像成为设备厂商的竞争焦点。CT和PET厂商(GE、西门子、飞利浦、联影)的新品发布会,”低剂量高清”几乎是固定话术。硬件端降低剂量的空间已经不大,算法端的图像恢复成为差异化关键。能和设备深度集成的AI恢复算法,是下一代医学影像设备的核心卖点。
多中心数据合规的算力需求同样突出。医学影像AI的模型要进临床,需要多中心验证。但患者数据不能出医院,联邦学习成为主流方案——各医院在本地训练,只上传梯度或模型更新,不共享原始DICOM。这意味着每一家参与医院都需要本地部署一台具备足够算力的训练节点,而不是把所有数据集中到一台大型服务器。
四、硬件支持思路
医学影像AI研究的算力需求有几个鲜明特征:3D卷积网络吃显存、多模态数据并行加载吃内存、DICOM预处理吃存储带宽、交叉验证吃并行计算资源。
具体来说:3D U-Net的编码器-解码器结构在512×512×256的输入体积上,中间特征图的显存占用轻松超过20GB;多模态训练时需要同时加载CT、MRI和PET三个序列到内存做配准和裁切;DICOM文件是高度碎片化的(一个CT序列可能拆成数百个.dcm文件),随机读取对SSD性能敏感。
五、UltraLAB工作站推荐配置
下面按价格区间分三档,全部基于UltraLAB塔式工作站产品线,列表简洁呈现核心参数和选型理由。
第一档:本科/硕士课题级(5-10万)
适合跑2D医学影像分割(<512×512)、小样本影像组学分析、单模态CT/MRI去噪或分类、低剂量恢复模型调参、课程设计和硕士论文。
- 机型:UltraLAB A350 15696-MCE
- CPU:Intel Ultra 285K(24核,8性能核全核5.5GHz/16能效核全核3.8GHz)——高主频加速DICOM读取、图像预处理和Python数据管道;24核并行支撑五折交叉验证和多组消融实验
- GPU:RTX Pro 5000 48GB/1344GB/s——48GB显存跑2D/轻量3D U-Net和影像组学特征提取;医学影像的16位灰度数据对显存位宽有要求,Pro系列更稳
- 内存:96GB DDR5——加载中等规模3D影像体积+多模态配准缓存+数据增强中间结果+开发环境
- 存储:4TB NVMe SSD——本地DICOM数据库(百例级别)、模型checkpoint、影像组学特征表、训练日志
- 价格区间:5-10万
- 适合课题:2D影像分割、小样本影像组学、单模态去噪/分类、低剂量恢复调参、本科/硕士论文
这档配置的核心优势是高主频+大显存。医学影像AI有一个特点:大量时间在”等数据”——从数百个DICOM文件里读取、重采样、归一化、裁切patch,再送进模型。高主频CPU让数据管道的瓶颈最小化。48GB显存对3D U-Net很关键,一个256×256×128的patch batch=4就能吃掉近30GB。
第二档:博士研究/进阶课题级(10-30万)
适合跑全分辨率3D医学影像分割(nnU-Net级别)、多模态融合模型(CT+MRI+PET)、大规模影像组学队列分析、低剂量恢复模型全量训练、联邦学习本地节点。
- 机型:UltraLAB AX430 127384-MC2E
- CPU:单Xeon 金牌6530(32核,基础2.1GHz/全核2.7GHz/最高4.0GHz)——32核并行处理大规模数据预处理和五折交叉验证;4.0GHz睿频兼顾交互式3D Slicer可视化标注
- GPU:双RTX 6000D 84GB/1568GB/s——单卡84GB,双卡共168GB——全分辨率3D nnU-Net+多模态交叉注意力+模型集成(deep supervision+deep ensembling)
- 内存:384GB DDR5——全分辨率3D影像体积全内存驻留;多模态数据(CT+MRI+PET各一套)+配准变换矩阵+增强缓存不swap
- 存储:4TB NVMe SSD——海量DICOM原始数据、NIfTI预处理结果、模型checkpoint历史版本秒级读写
- 价格区间:10-30万
- 适合课题:全分辨率3D分割、多模态融合、大规模影像组学、低剂量恢复全量训练、联邦学习节点、发顶刊/博士论文标配
这档配置的核心升级点在GPU显存暴涨+内存翻倍。医学影像多模态融合有一个算力陷阱:你以为瓶颈在模型参数量,实际上当CT(512×512×300)、MRI(256×256×180多序列)和PET(128×128×300)三个模态同时加载到内存做配准和裁切时,内存占用会爆炸。384GB内存允许你在不压缩分辨率的情况下做完整的颅脑多模态配准。双6000D的168GB显存允许你在全分辨率3D体积上跑nnU-Net with deep supervision——这是医学影像分割的SOTA方案,对显存是硬约束。
第三档:课题组公用/临床验证平台级(30-100万+)
适合多人共用、同时推进多个医学AI子方向、搭建多中心联邦学习中枢、承接医院合作项目、训练大规模基础模型。
GX660M 227512-MD4E:
- CPU:双Xeon 金牌6530(64核128线程,单颗基础2.1GHz/全核2.7GHz/最高4.0GHz)——多用户同时提交训练和数据处理任务,交叉验证并行不排队
- GPU:4块RTX 6000D 84GB/1568GB/s——总计336GB显存,可同时跑4~6个独立3D训练任务或联邦学习多节点模拟
- 内存:512GB DDR5——真正的”内存自由”,最大规模多模态队列研究全缓存
- 存储:8TB NVMe SSD——多人共用长期项目,DICOM原始库+预处理数据集+模型动物园+临床验证报告
- 特点:双塔式(双2600W电源),水冷散热 | 持续满载不降频不宕机
- 适合课题:课题组医学AI平台、多模态大模型预训练、联邦学习中枢、医院合作临床验证
GX660M 227768-MD6E(顶配版):
- CPU:双Xeon 金牌6530(64核128线程,单颗基础2.1GHz/全核2.7GHz/最高4.0GHz)——同上
- GPU:6块RTX 6000D 84GB/1568GB/s——总计504GB显存,超大规模医学影像基础模型或多课题组共享
- 内存:768GB DDR5——超大内存,支持最复杂全队列多模态研究全缓存
- 存储:8TB NVMe SSD——同上
- 价格区间:60-100万+
- 适合课题:国家级医学AI平台、大规模基础模型、多课题组共享、跨院联邦学习
这档配置的定位是课题组的医学AI算力中枢。医学影像AI方向的课题组通常同时推进多个子方向:有人做分割、有人做配准、有人做低剂量恢复、有人做影像组学——每个方向都需要独立的GPU训练进程。GX660M的4到6块GPU允许不同课题独立训练3D模型,互不排队;512GB内存支撑最大规模的队列研究(数千例多模态数据)全内存分析;双电源设计意味着即使一个电源模块故障,已经跑了数天的nnU-Net五折交叉验证不会前功尽弃。
六、选工作站别踩这些坑
误区一:用消费级显卡跑医学影像模型。 医学影像的DICOM数据是16位灰度,模型训练和推理需要稳定的显存带宽和精度。消费级显卡在长时间高负载下的显存稳定性不如Pro系列,且驱动优化偏向消费场景而非CUDA计算。医学模型训练一次可能几十小时,中途OOM或驱动崩溃的成本极高。
误区二:忽视DICOM读取对存储的压榨。 一个CT病例可能拆成300个.dcm文件,预处理阶段需要随机读取不同层、不同序列。SATA SSD的4K随机读取性能在这种场景下会让数据加载成为瓶颈,GPU利用率忽高忽低。高速NVMe是医学影像数据管道的刚需。
误区三:内存逐步扩容的策略在医学影像场景下往往导致后期容量不足。 多模态配准是内存黑洞。CT(512×512×300,16位)≈150MB,MRI四序列≈200MB,PET≈30MB,配准过程中的浮动图像、变换矩阵、插值缓存加起来轻松超过1GB每例。百例队列加载到内存做批量处理,128GB都可能吃紧。384GB起步。
误区四:忽视数据隐私对本地算力的倒逼。 医院数据不能上公有云,联邦学习要求每家参与机构都有本地训练能力。这意味着即使你是小型课题组,也需要一台能在本地跑完整训练流程的工作站,而不是依赖远程服务器。
误区五:模型训练完了就万事大吉。 医学影像AI要进临床,需要持续的模型更新和增量学习。新病种、新设备、新扫描协议进来,模型要重新微调。这要求工作站不仅要能跑训练,还要能长期稳定运行推理服务(对DICOM路由器实时响应)。塔式静音设计适合放在实验室或医院机房,不像机架式那样需要单独机房。
结语
北航医学科学与工程学院在影像组学领域发表了Nature Reviews级的综述,生物与医学工程学院做出了同时处理PET/CT/MRI三种修复任务的TAT系统。学生在本科阶段就开始接触DICOM解析、3D U-Net训练和影像组学特征提取——这些环节的算力需求,普通笔记本撑不住。
从一台编译快、显存大、内存足、存储快的工作站开始,在本地把低剂量CT的噪点模型跑通、把多模态MRI的配准精度摸熟、把影像组学的特征库建好——再把验证好的模型部署到临床合作医院——这是医学影像AI研究的正常节奏。建议医学影像AI方向的师生优先选择显存大、内存足、存储快的塔式工作站,以支撑3D医学影像分割和多模态融合训练的需求。
微信号:maxftxwx












