专注高性能计算领域资讯
2025年4月,西安交通大学发布DeepEdu1.0教育智能体——”交晓智”平台(来源:西安交通大学新闻网,2025-04-01),综合利用开源与闭源国产大模型,以开源大模型为计算推理和生成基座,设计了闭源大模型API智能模块,集成丰富的人机交互功能,为高校教育场景打造了12个专业教育垂直大模型,覆盖79门专业核心课程。同月,学校将2025年定为”人工智能赋能年 […]
做大模型预训练的工程师都懂,PyTorch跑百亿参数模型最崩溃的不是loss不收敛,而是DeepSpeed ZeRO-3刚配好,训练到某一步优化器状态分片通信阶段直接OOM,或all-gather卡死导致GPU利用率跌到10%以下。去年夏天,一个做金融大模型基座预训练的团队找到我们,离模型交付只剩七天。他们的Llama-3架构模型(135B参数,PyTorch+DeepSpeed ZeRO-3,B […]
在百亿参数大模型成为NLP基座的今天,微调(Fine-tuning)早已不是改几层全连接层的轻量活。当清华NLP实验室某团队承接某垂直领域大模型适配项目,试图在PyTorch中对LLaMA-2 13B进行指令微调时,遭遇了一个极其普遍的工程困境:单张RTX 3090的24GB显存连BF16权重的全参数微调都容纳不下,转向LoRA低秩适配后,序列长度稍长即触发CUDA Out of Memory,而 […]
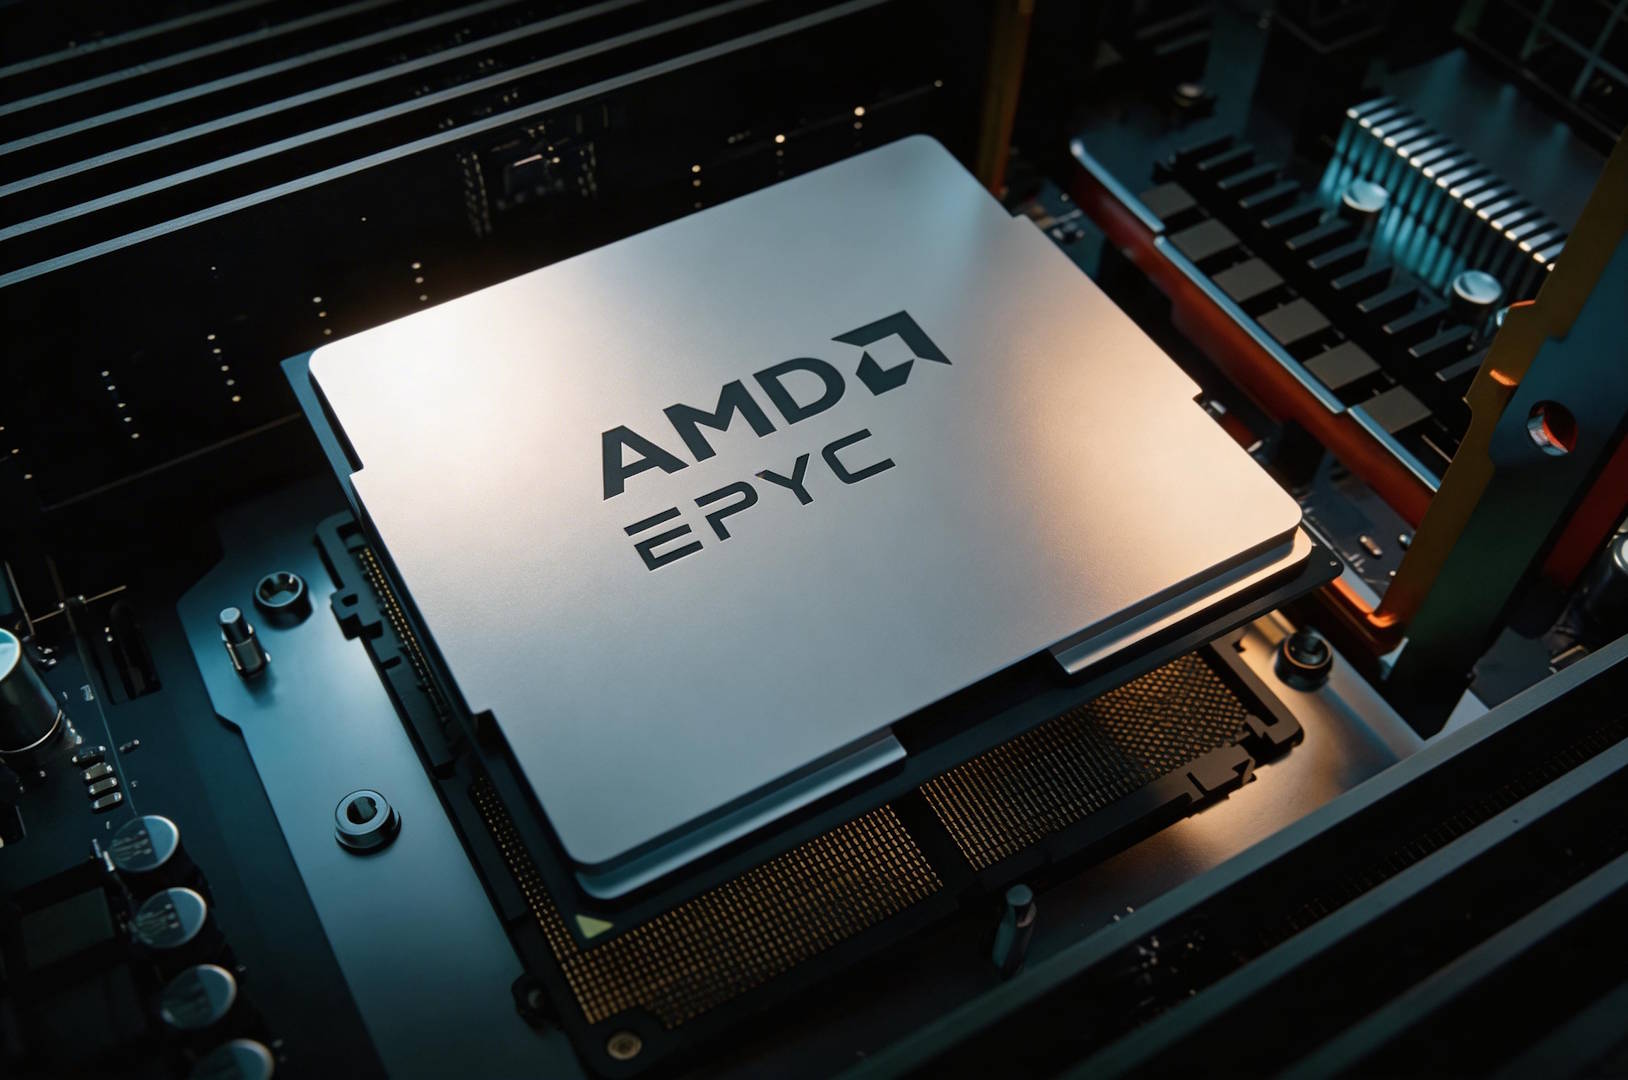
说实话,看到AMD Zen 6架构的Venice EPYC处理器供不应求的消息,我倒不觉得意外。这事儿背后反映的其实是整个AI行业的一个尴尬现状——我们对算力的渴望,远远超过了半导体工厂的生产能力。 先说说让我印象深刻的几个数据。Zen 6 Venice处理器用的是台积电2nm工艺,单个CCD能塞下32个核心,8个CCD拼在一起就是256核的庞然大物。更夸张的是L3缓存能堆到1GB,能效还比上一代 […]
精选行业动态 + 全网热点,不遗漏关键信息