
做大气污染模拟的课题组,这两年普遍遇到同一个尴尬:模式越搭越细,机器越跑越慢,最后发现卡在硬件上。这个趋势有迹可循。上海交通大学环境科学与工程学院设有大气污染控制与模拟研究所,研究方向里明确列着”空气质量模拟与仿真”。该所程真研究员主持的国家自然科学基金面上项目”基于Deepseek与数据驱动模式的大气污染应急管控策略”(项目批准号 42575196,2026 年 1 月启动,执行至 2029 年 12 月),把 DeepSeek 和大气污染应急管控写进了同一个题目;其团队 2026 年还在 Atmospheric Environment 上发表研究,将傅里叶神经算子(FNO)用于空气质量对排放扰动的响应模拟。模拟加人工智能,正在变成这个方向的标准动作。
标准动作的背后是非常具体的算力账单。这篇文章换个写法:不做面面俱到的科普,直接设一台中端机器,把网格规模一级一级往上加,看它在哪一级趴窝、每一级先耗尽的到底是哪个资源。看完你就知道,自己的工作站该把钱花在哪。
测试设计:同一套模式,四个加压等级
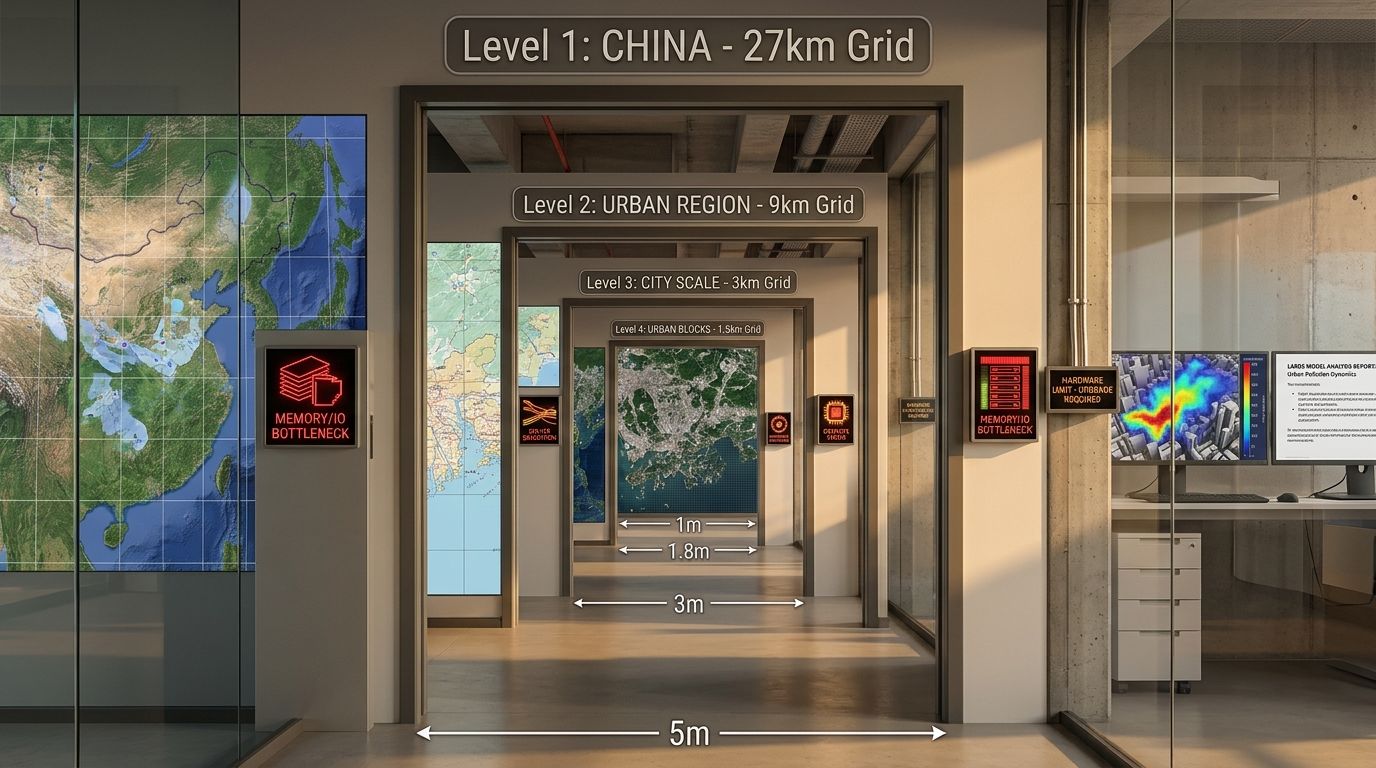
测试对象选区域空气质量模式的主流组合 WRF-CMAQ:WRF 提供气象场,CMAQ 算化学传输。化学机理开 CB6,气溶胶模块开全,垂直方向 34 层。水平分辨率设四个等级,覆盖从课程作业到课题结题的真实跨度:
| 等级 | 网格分辨率 | 覆盖范围 | 三维格点数(约) | 典型任务 |
|---|---|---|---|---|
| Level 1 | 27 km | 华东全域 | 140 万 | 课程算例、季节趋势 |
| Level 2 | 9 km | 华东全域 | 1200 万 | 论文基准算例 |
| Level 3 | 3 km | 长三角嵌套 | 7700 万 | 污染过程复盘 |
| Level 4 | 1.5 km | 长三角全域 | 3.1 亿 | 溯源解析、应急推演 |
格点数按水平格点乘层数粗算。CB6 全化学机理的物种数在 200 个以上,每个物种背后还挂着浓度、通量和求解器工作数组。按大气化学模拟社区的经验口径,全化学机理下每万三维格点要吃掉 0.1~0.3 GB 内存。这个数不是官方指标,但用来估数量级足够。
测试机设定为一台典型中端配置:24 核桌面处理器、128 GB 内存、单张 24 GB 显存的显卡。这个起点不高不低,正好代表多数课题组的真实处境。
Level 1:27 公里粗网格——瓶颈不在算,在 IO
第一级几乎没有悬念。140 万三维格点,全机理跑一天模拟,几个小时内出结果。这一级真正折磨人的是前期处理:气象再分析数据、地形土地利用数据、排放清单,动辄几十 GB 的原始文件要依次过一遍 WPS 和排放处理程序。这些预处理工具是串行的,核再多也只能用一个,瓶颈卡在单核性能和硬盘读写上。
很多新手在这里误判:机器风扇都不怎么转,就以为任务很轻。其实 IO 和预处理只是前菜,真正的账单在 Level 2 才寄到。
Level 2:9 公里网格——内存第一次报警
分辨率从 27 公里加密到 9 公里,水平格点数涨 9 倍,三维格点冲到 1200 万。按前面的经验口径,内存需求落在 120~360 GB 区间,具体取决于气溶胶模块和输出配置。
128 GB 的机器在这一级开始吃紧。能跑,但要砍掉部分输出变量、压低写盘频率,还要时刻盯着系统监控:物理内存占用长期在九成以上徘徊,一旦触发 swap,求解速度立刻掉一个数量级。第一个先耗尽的资源出现了:内存容量。CPU 核心数这次反而排在了后面。这也是大气模拟区别于很多负载的地方:核不够最多排队,内存不够直接出局。
Level 3:3 公里嵌套域——能跑,不等于能干活
3 公里是污染过程复盘的常用分辨率,也是课题组最容易硬上的等级。7700 万三维格点,按这个口径内存需求 770 GB 起步,满配冲到 2 TB 级。128 GB 的机器在这个阶段会进入一种危险状态:任务能提交、能启动、甚至能往前推进——靠的是操作系统疯狂读写 swap。看一眼监控,CPU 利用率只有百分之十几,硬盘灯常亮,一个时间步要拖上几分钟。这种状态下跑出来的结果,时间成本是正常情况的十倍,而且随时可能在第 N 天模拟处被系统杀掉。
“还能跑”是最危险的判断。对大气模拟来说,能启动和能干活之间,隔着一整条内存鸿沟。
Level 4:1.5 公里全域模拟——崩溃临界点
1.5 公里全域、气溶胶模块全开、再叠资料同化和多情景批量试验,三维格点超过 3 亿,内存需求冲过 TB 级。中端机在这一级没有任何挣扎余地:CMAQ 初始化分配数组时直接报错退出,或者系统在几分钟内把 swap 打满后杀掉进程。崩溃点在求解开始之前就到来——模式连第一小时都走不出去。
顺带说并行策略。CMAQ 用 MPI 做水平域分解,每个核分到一块 20×20 到 30×30 格点的子域。核数继续往上加,每块格点越来越少,通信开销占比越来越高,加速比最后被内存带宽锁死。所以 Level 4 的答案不在单机堆核,而在 TB 级内存平台或者多节点集群。
把四个 Level 的瓶颈翻译成硬件语言
回头看,四个等级对应四种完全不同的硬件侧重:
| 等级 | 最先耗尽的资源 | 硬件含义 |
|---|---|---|
| Level 1 | 单核性能、磁盘 IO | 高频 CPU、NVMe 固态 |
| Level 2 | 内存容量 | 256 GB 起步的内存池 |
| Level 3 | 内存容量+内存带宽 | 大容量加多通道平台 |
| Level 4 | 单机内存上限 | TB 级内存或分布式集群 |
这张表解释了大气模拟工作站反直觉的预算分配:CPU 核心数排第二位,内存容量和带宽才是第一位。显卡在纯模拟里几乎不参与计算,但接下来要聊的大模型私有化部署,会把它拉回清单里。
大模型私有化部署:模拟之外的新负载
做大气污染模拟的课题组,部署本地大模型的理由很具体。一是数据敏感:排放清单、政府委托的溯源分析、未发表的监测数据,都不适合传到公网 API。二是应急场景:污染过程不挑工作日,管控推演经常半夜临时调用,离线可用是刚需。三是领域定制:课题组手里攒着多年积累的 namelist、排错记录和报告模板,正好用来微调一个懂行的助手。
模型选型上,轻量任务用 Qwen3-8B——阿里巴巴 2025 年 4 月开源的 80 亿参数稠密模型,做模拟配置排错、排放清单整理脚本、日志摘要绰绰有余;需要深度推理的环节,比如解读溯源报告、梳理”排放—传输—化学转化”的因果链,用 DeepSeek-R1-Distill-Qwen-32B——从 DeepSeek-R1 蒸馏而来的 320 亿参数模型,长思维链正适合这类分析。
显存估算用一条公式:所需显存约等于参数量(B)乘量化字节数乘 1.2,1.2 是上下文缓存和系统开销的预留系数。FP16 每参数 2 字节,Q8 每参数 1 字节,Q4 每参数 0.5 字节。套到这两个模型上:
| 模型 | FP16 | Q8 | Q4(舒适档) |
|---|---|---|---|
| Qwen3-8B | 约 20 GB | 约 10 GB | 约 5 GB(8 GB 显存) |
| DeepSeek-R1-Distill-Qwen-32B | 约 77 GB | 约 38 GB | 约 19~22 GB(24 GB 显存) |
量化等级怎么选:FP16 无损但体积翻倍,Q8 精度几乎无感,Q4 有轻微损失,日常问答和脚本生成完全够用——这也是 Q4 成为本地部署默认档的原因。速度层面,纯 CPU 推理只有个位数 tokens/s,问一句等半分钟;单卡 GPU 能到几十到上百 tokens/s,体验差距一目了然。如果还要微调:LoRA 轻量化微调只增加几 GB 显存,8B 模型单卡即可;全参数微调则是推理需求的数倍,32B 全参数微调要几百 GB 显存——这一项直接决定配置档位能不能上探。
UltraLAB 配置怎么选
从算法原理到代码实现,中间隔的是编程能力;从代码实现到实际跑出结果,中间隔的往往就是硬件配置。上面四个 Level 已经把账算清楚了:大气模拟吃内存容量和内存带宽,大模型部署吃显存,预处理吃单核和硬盘 IO。按这个逻辑分档,下面给出四套参考方案,从轻度算例到集群级推演,按需对号入座。
方案A:入门级——城市尺度轻量模拟加 8B 模型推理
适用场景:27 公里至 9 公里网格的常规算例、课程与论文级模拟任务;本地运行 Qwen3-8B 做配置排错和报告初稿生成,DeepSeek-R1-Distill-Qwen-32B 按 Q4 量化也能压在显存上限内运行。
| 硬件类别 | 具体配置 | 说明 |
|---|---|---|
| CPU | Intel Ultra9 285K (24核, 8P核5.6GHz) +水冷 | 8P核5.6GHz高频直对WRF-CMAQ串行预处理瓶颈,24核覆盖Level 1~2算例 |
| GPU | RTX5090D v2 24GB+水冷 | 24GB显存把DeepSeek-R1-Distill-Qwen-32B的Q4舒适档压在显存上限内 |
| 内存 | 128GB DDR5 | 140万格点Level 1算例从容运行,1200万格点Level 2需精细控制输出 |
| 存储 | 4TB NVME + 8TB SATA | NVMe盘缓解预处理阶段几十GB原始数据的读写等待 |
| 显存 | 24 GB | 32B模型Q4量化的显存上限,8B模型则绰绰有余 |
| 显存带宽 | 1.34 TB/s | 决定模型问答响应速度,报告解读不用逐句等 |
推荐机型:A350 153128-MCT
硬件解析:入门档的定位很直白——128GB内存把Level 1算例跑从容,Level 2需要精打细算;24GB显存恰好咬住32B模型Q4量化的舒适线,是预算内同时办齐“城市尺度模拟+本地大模型”两件事的最低门槛。
方案B:进阶——9 公里区域长期模拟加 32B 模型从容推理
适用场景:华东区域 9 公里网格长期序列模拟,叠加资料同化;DeepSeek-R1-Distill-Qwen-32B 以 Q4 量化常驻运行,响应溯源报告解读和应急问答;内存余量支撑多情景批量试验。
| 硬件类别 | 具体配置 | 说明 |
|---|---|---|
| CPU | 2×Xeon铂金8570 (112核3.0GHz) +工业水冷 | 112核规模匹配9公里长期序列模拟与资料同化的持续算力需求 |
| GPU | RTX 5090 32G | 32GB显存让32B模型从“能跑”升级为常驻,并留LoRA微调余量 |
| 内存 | 512GB DDR5 | 512GB内存池把Level 2的内存报警变成历史,多情景批量试验有底气 |
| 存储 | 8TB NVME Gen5 | 8TB NVMe承接长期序列模拟的高频写盘 |
| 显存 | 32 GB | 32B模型常驻推理的显存容量,应急问答随叫随到 |
| 显存带宽 | 1.79 TB/s | 保障模型解码速度,溯源报告解读不再逐句等待 |
推荐机型:EX660 230512-MDT
硬件解析:512GB内存是这套配置的定盘星——Level 2的内存警报彻底解除,多情景批量试验有了底气;112核Xeon铂金把长期序列模拟的时间轴压短,RTX 5090让32B模型从“能跑”变成“常驻”,应急推演随叫随到。
方案C:专家级——3 公里嵌套模拟加神经网络模拟器训练
适用场景:3 公里嵌套域污染过程复盘、多情景集合模拟;训练 FNO 等神经算子替代模型加速化学求解;32B 模型以 FP16 或 Q8 精度运行,兼顾多模型并发与后续微调空间。
| 硬件类别 | 具体配置 | 说明 |
|---|---|---|
| CPU | 2×Xeon金牌6530 64核2.7-4G | 双路64核支撑3公里嵌套域复盘与多情景集合模拟的并行排产 |
| GPU | 6×RTX 6000D 84G | 六卡504GB显存池,FNO神经算子训练与32B模型FP16运行并行不悖 |
| 内存 | 768GB DDR5 | 768GB压住Level 3入门规模的下沿,精简输出配置可跑通标准复盘 |
| 存储 | 8TB NVMe | 8TB NVMe承接集合模拟的批量结果写入 |
| 显存 | 504G | 六卡聚合显存,兼顾多模型并发与后续微调空间 |
| 显存带宽 | 6×1.6TB/s | 每卡1.6TB/s独立带宽,训练与推理互不拖累 |
推荐机型:GX660M 227768-MD6E
硬件解析:六张RTX 6000D堆出504GB显存池,让32B模型以FP16无损档常驻、FNO神经算子从容训练两件事同时成立;768GB内存压住Level 3入门规模的下沿,满配算例上探1TB级内存或分流集群,双路64核负责切碎集合模拟的排队时间——这是“模拟+AI”双主线的专家级答案。
方案D:集群级——1.5 公里全域溯源与应急推演
适用场景:千米级全域模拟、资料同化循环、多节点 MPI 分解;支撑课题组多人共用和应急管控的时限要求,计算节点与存储节点分离,横向扩展不再受单机内存天花板约束。
| 硬件类别 | 具体配置 | 说明 |
|---|---|---|
| 计算节点CPU | 2颗AMD霄龙9575F(128核4.5GHz) / Ultra9 285K(8核 5.6GHz) | 128核霄龙节点主攻千米级全域模拟,高频节点专职串行预处理 |
| 计算节点GPU | RTX4090D / RTX A4000 | GPU节点承接神经算子训练与同化循环的加速环节 |
| 计算节点内存 | 768GB DDR5 / 64GB DDR5 | 768GB节点硬吃大算例,64GB节点灵活扩展 |
| 计算节点存储 | 2TB NVME / 2TB NVME | 每节点本地NVMe保障计算过程IO不拖后腿 |
| 计算节点显存 | 24 GB / 16 GB | 对应GPU档位的显存配置 |
| 计算节点显存带宽 | 1.01 TB/s / 448.0 GB/s | 对应显卡档位的带宽水平 |
| 存储管理节点CPU | 2颗Xeon银牌 4310(24核) | 存储调度核心,管理多人共用的并行文件系统 |
| 存储管理节点内存 | 192GB DDR4 | 存储节点的缓存与调度内存 |
| 存储管理节点存储 | 126TB存储 | 课题组共享数据池,同化循环的输入输出中枢 |
推荐机型:分布式集群方案 8.6(科学计算通用型)
硬件解析:8.6科学计算通用型的巧思在节点异构——128核霄龙节点专职Level 4全域模拟的MPI分解,高频节点跑串行预处理,存储管理节点统一126TB数据池;跨节点分解把单机的TB级内存天花板直接掀掉,这是1.5公里溯源与应急推演唯一现实的算力出路。
常见问题
CMAQ 报内存错误,加内存条能不能解决?
分情况。Level 2 阶段的报错,加内存立竿见影;但如果报错发生在 Level 4 量级,单机插槽已经插满,换平台比加条更实际。还要看报错时机:初始化阶段报错多半是数组分配超限,求解中途被杀多半是 swap 耗尽,两者对应的扩容策略不同。
租云服务器跑模拟是不是更划算?
跑一次两次可以,长期做课题不建议。区域模拟的输入数据动辄几十 GB,上传就要半天;长期序列加多情景试验累积下来,租金很快超过一台工作站的采购成本。云上适合弹性峰值,本地适合日常高频,这是课题组普遍的混合用法。
大气模拟本身用得上显卡吗?
纯 WRF-CMAQ 求解在 CPU 上跑,显卡几乎不参与。但两个新方向正在改变这件事:一是用神经网络模拟器替代化学求解器,训练需要显卡;二是大模型私有化部署,推理和微调都吃显存。所以模拟工作站要不要配好显卡,取决于做不做这两件事。
大模型推理和大气模拟能共用一台机器吗?
能,但要注意资源错峰。模拟任务满载时内存和内存带宽都会被占满,推理速度会明显下降;反过来,大模型长上下文推理也会挤占模拟的可用内存。内存 256 GB 以上的平台,把模拟和大模型分时段、分容器运行,是课题组性价比最高的共用方式。
结语
四个 Level 测下来,结论只有一句话:大气模拟的崩溃几乎都有预兆——它在 Level 2 的内存告警里、在 Level 3 的硬盘常亮里,已经预告过了。”还能跑”是最危险的判断,等它真的跑不动那天,课题节点也到了。提前把内存和内存带宽的账算清楚,再为大模型留好显存,这台机器才能陪你跑完整个课题周期。











