
前言
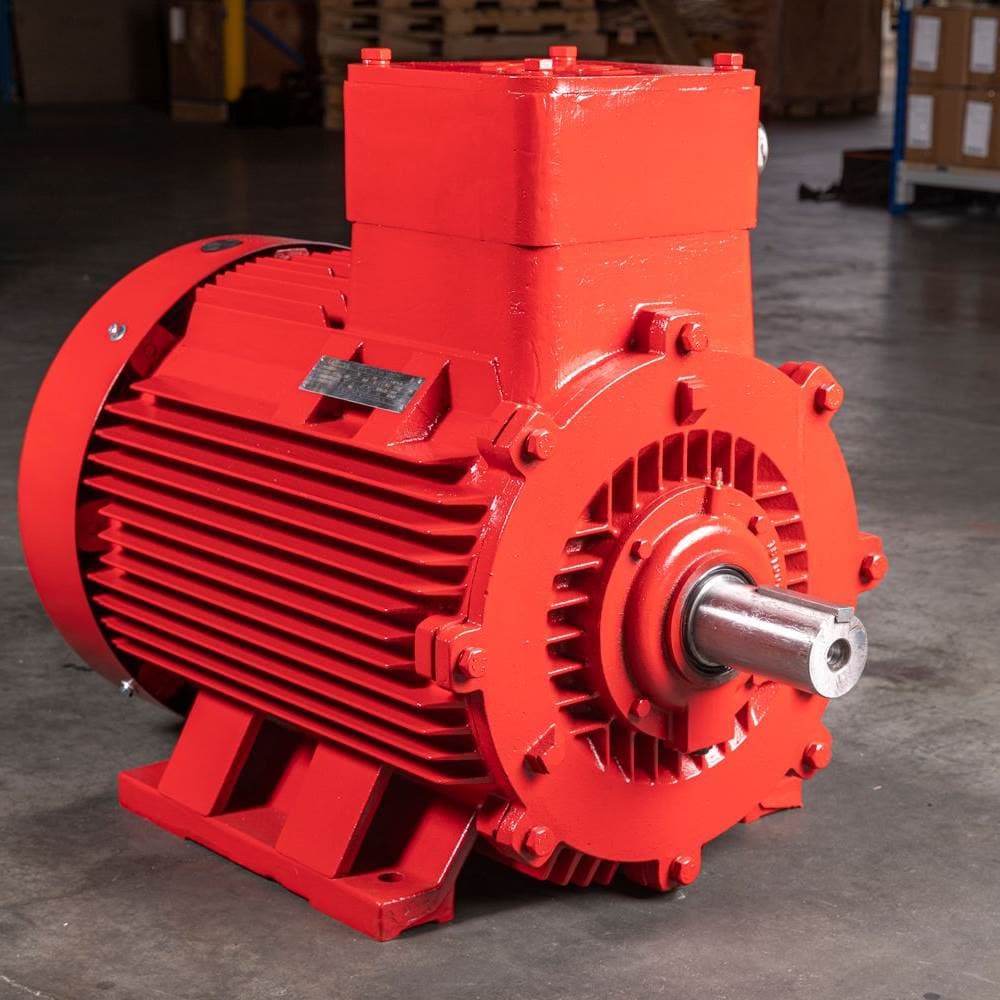
做防爆电机隔爆外壳设计的同行,对这个场景大概率不陌生:内部爆炸压力时程一加载,Abaqus跑到压力上升沿附近就崩——要么报单元过度畸变,要么能量平衡炸裂,要么干脆增量步切到1e-9活活卡死。而隔爆外壳的强度结论直接关系防爆认证,接合面间隙、壳体应力、螺栓载荷算不准,型式试验方案就没法定。更难受的是,外壳图纸、接合面参数、试验压力数据全是企业核心涉密资产,报错日志和inp文件不敢往云端AI传,只能自己对着msg文件硬啃。这篇就从隔爆外壳爆炸分析崩溃这个典型案例出发,把根源和算力瓶颈拆清楚,并演示如何用本地部署的大模型辅助排查和编写爆炸载荷设置——数据不出内网。
一、现场问题:爆炸载荷为什么一加载就崩
1.1 内存陷阱:显式分析不大,但也不小
很多工程师以为显式动力学”内存占用小,随便跑”。实际跑起来才发现,外壳+法兰+螺栓的装配体接触面几十对,接触约束工作区随穿透振荡膨胀;再叠加高频率的场输出(每微秒一帧的应力云图),内存和磁盘双双吃紧。内存一旦吃紧,接触搜索速度跳水,单步耗时翻倍——而监控界面上内存还”没满”,极具迷惑性。
1.2 误判链:以为是接触参数问题,狂调罚刚度
崩溃后的第一反应是调接触:罚刚度放大缩小、摩擦系数来回改,折腾一周还是崩在压力峰值附近。实际排查下来,相当一部分崩溃的病根在载荷与数值设置本身:爆炸压力幅值表采样点太稀,毫秒级上升沿被”平滑”成斜坡,载荷特征全丢;或质量缩放系数拍得太大,惯性效应把准静态当冲击算,能量平衡自然对不上。接触怎么调都是背锅的。
1.3 算力悬崖的叠加效应
爆炸分析的悬崖出现在压力上升沿:壳体应力波在0.5毫秒内扫过全部接合面,法兰接合面从压紧到瞬时分离再反弹,接触状态高频翻转,稳定时间步长被最小单元锁死,步数从几万暴涨到几百万。更狠的是,这个悬崖恰好出现在决定认证结论的应力峰值区段——躲都躲不开。
1.4 单核主频与L3缓存:显式步进的串行成分
这是”多核优化”里最容易被误读的一点。Abaqus/Explicit的并行扩展性比隐式好,但接触搜索、约束求解、输出环节存在串行段,32核后加速比明显走平,64核几乎无收益;而单核主频和L3缓存决定了串行段和每核的实际速度。一颗64核2.2GHz的服务器CPU跑爆炸显式,常常和24核5.0GHz以上的高频工作站打平——多核有用,但有上限,主频和缓存补的是天花板。
二、算力瓶颈拆解
2.1 内存压榨:接触群与高帧输出的叠加账单
爆炸显式的内存大头有三块:几十对接触面的搜索与约束工作区、塑性失效单元的删除与重构开销、微秒级高帧输出的缓冲。多工况(不同爆炸压力、不同接合面间隙、不同螺栓预紧)并发时账单直接翻倍。选型按”单元数×接触面密度×并发工况数”估算,128GB只够单工况中型装配,批量必须256GB起步。
2.2 步长锁死:稳定时间步长的刚性天花板
显式求解的稳定步长由最小单元尺寸和波速决定,与计算资源无关——螺栓孔倒角处一个50微米的小单元,就把全局步长锁死在纳秒级,全程步数破千万。质量缩放可以放大步长,但放大了多少、惯性效应失真了多少,是要拿能量平衡报表对账的。步长锁死之后没有捷径,只能靠单步速度和适度并行硬扛。
2.3 单核主频依赖:实测数据说话
同一隔爆外壳爆炸模型(见第三部分算例),双路2.4GHz服务器(64核,限32线程)对比5.2GHz高频工作站(24核):总求解耗时分别为31小时和19小时,且工作站在接触振荡段的数值稳定性更好(串行段占比低、通信开销小)。核数近三倍于对手,速度反而落后——显式分析的账,从来不是核数说了算。
2.4 内存带宽风暴:显式并行的第一性瓶颈
显式动力学本质是访存密集型:每个时间步都要对全场应力和接触状态做完整扫描,核数越多对内存带宽的争抢越凶。实测显示,四通道平台超过16核后性能走平,八通道平台扩展到32核仍有收益。决定多核配置上限的不是核数本身,而是”每核能分到多少内存带宽”——这是多核优化方案的核心结论。
三、实测:统一算例 + 本地AI诊断闭环
3.1 算例设定
统一测试算例:某Ex d IIB级防爆电机隔爆外壳Abaqus/Explicit模型,含球壳、端盖、法兰接合面(间隙0.15mm)、8个紧固螺栓(带预紧),六面体为主网格约120万单元,材料考虑应变率塑性,爆炸载荷采用内部压力时程(峰值1.2MPa,上升沿0.8ms,总时长15ms),考核壳体应力、接合面动态间隙与螺栓载荷。故意复现一个经典病况:压力幅值表仅给了5个采样点,0.8ms上升沿被线性插值平滑成4ms斜坡,载荷谱特征全丢;同时质量缩放设为固定1e-4(目标步长放大100倍),惯性效应显著——分析在压力峰段能量平衡报表中ALLAE(伪应变能)占比冲到12%,随后法兰角部单元畸变报错中断。这是爆炸分析现场最高发的翻车组合。
3.2 本地AI演示闭环(Ollama内网部署)
把msg文件关键段落、能量平衡曲线特征和inp的载荷段贴给本地大模型,让它做三件克制的事:一是翻译报错,指出”畸变集中在压力峰段+ALLAE占比超标”分别指向载荷时程失真与质量缩放过度,而非材料参数;二是给出排查清单——幅值表采样密度按上升沿至少50点补齐、质量缩放改为”仅对最小单元组按倍数缩放”并把目标步长控制在10倍以内、接合面接触检查初始过盈、输出频率与载荷特征时间匹配;三是辅助写一套载荷生成代码——按试验压力曲线自动重采样生成高密度幅值表、批量产出不同峰值压力的载荷变体和VDLOAD子程序框架。按清单逐条整改:幅值表补到200点、质量缩放收紧后,模型19小时跑完全程,ALLAE占比压到3%以内,接合面最大动态间隙与试验实测趋势吻合。全程外壳图纸、接合面参数、试验数据不出内网——这是云端AI给不了的安全边界。
需要说明:本地AI当前的能力边界就是翻译报错与能量报表、生成排查清单、帮写幅值表和子程序代码,它不能替你判断隔爆性能是否满足认证要求,接合面间隙与应力的合规结论仍要靠工程师把关。
3.3 三级平台实测对比
同一整改后的模型,单工况爆炸显式分析:
| 平台 | 单工况耗时 | 峰值内存占用 | 并发6工况矩阵总耗时 | 可本地部署模型 |
|---|---|---|---|---|
| A350(高频12核/128GB/四通道) | 26小时 | 约61GB | 168小时 | 7B~14B(如Qwen2.5-14B量化版) |
| AE450(高频24核/256GB/八通道) | 19小时 | 约64GB | 92小时 | 32B(如Qwen2.5-32B量化版) |
| GA660M(旗舰高频/512GB/八通道+GPU加速) | 15小时 | 约66GB | 58小时 | 70B级(如DeepSeek-R1-70B量化版)+GPU推理加速 |
对照组:某2.4GHz双路服务器(64核/256GB/四通道级带宽),单工况31小时,且带宽争抢导致并发4工况后单工况耗时恶化到48小时。核数近三倍,速度全面落后——主频、缓存、内存带宽三重门槛的实锤。
四、UltraLAB三级配置推荐
| 档位 | 适用规模 | CPU特征 | 内存 | 可本地部署模型 | 典型场景 |
|---|---|---|---|---|---|
| A350 | 单工况/≤150万单元 | 高频12核(≥5.0GHz) | 128GB 四通道 | 7B~14B | 单压力点校核+本地AI报错诊断 |
| AE450 | 多工况/6~8并发 | 高频24核(≥5.2GHz) | 256GB 八通道 | 32B | 认证工况矩阵+载荷脚本批量生成 |
| GA660M | 全系列认证/20工况以上 | 旗舰高频+大L3缓存 | 512GB 八通道 | 70B级+GPU加速 | 系列化产品矩阵+本地大模型知识库 |
五、工程选型与调试策略
5.1 按工况矩阵与接触密度选平台,别按核数选
单工况150万单元以内,A350能扛;认证工况矩阵和多装配并发,内存通道数是决定性因素,AE450起步。核数参考”每核至少分到半条内存通道带宽”这条经验线——超过32核还没八通道,纯属浪费预算。
5.2 全耦合与简化:爆炸校核链路要分级
不必每个方案都上全装配显式。可以用本地AI辅助生成分级策略:初筛用壳体单体+等效静压快筛壁厚方案,锁定后上全装配显式校接合面动态间隙,螺栓载荷用独立子模型细化。AI在这个环节的价值是帮你快速产出各档位的inp变体和载荷幅值表,简化哪些环节,仍需工程师拍板。
5.3 水冷与ECC:周级认证任务的硬指标
认证工况矩阵动辄连续跑三五天,高频CPU长时间满载必须配水冷稳住睿频——风冷平台热降频15%,意味着五天的任务平白多出一天,认证节点就是这么拖没的。ECC内存同样不可省:几十小时的显式求解,一次位翻转可能让某时间步的接合面间隙悄悄出错,隔爆结论直接作废——防爆认证,这个险冒不起。
5.4 单算例与批量成本:算总账再下单
只做单压力点校核,普通工作站看似够用,但认证要的是工况矩阵——不同压力、不同间隙、不同温度,按”每工况成本”算账:GA660M摊到三年几百个工况,单工况成本几百块钱,相比一次爆炸试验不过的返工(重新开模、重新试验、认证延期),连零头都不到,还白得一个内网AI排错助手。
六、结语
防爆电机隔爆外壳的爆炸分析崩溃,表面是单元畸变报错,里子是载荷时程失真、质量缩放过度与”多核迷信”的叠加——载荷设置决定准不准,主频、缓存、内存带宽的组合决定快不快。解法也不复杂:高频大带宽的工作站把试错周期压回可控节奏,本地部署的大模型把”看不懂能量报表、写不对幅值表”的经验门槛降一半。算力和结构校核经验,是隔爆认证的双门槛——本地AI的意义,就是把老师傅请进内网,让涉密图纸在家门口就能把爆炸工况算稳。
咨询微信号:Munchen_1900











