
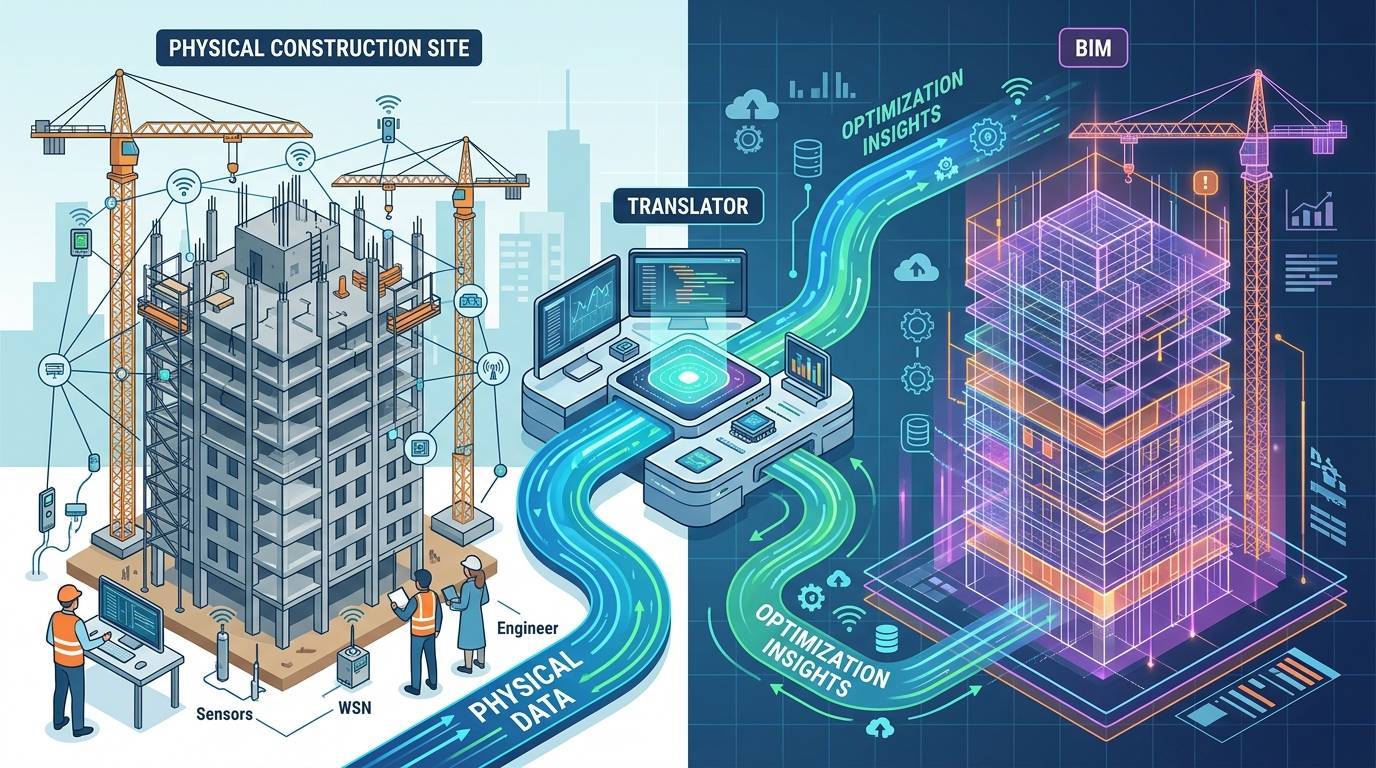
一场关于”要不要买新机器”的讨论会
九月底,某高校土木工程系智能建造课题组的小型会议室里,新学期第一次设备购置讨论会已经开了两个多小时。
主持讨论的是课题组组长周教授,做施工力学出身;对面坐着青年教师林老师,研究方向是数字孪生工地;博士生小程负责课题组大部分的仿真计算;受邀列席的还有常年给实验室做设备维护与选型的工程师老吴。
桌上摊着三份材料:一份是今年的设备预算申请表,一份是某在建超高层项目的施工监测合作协议,还有一份小程整理的”课题组算力缺口清单”。
“先把共识说清楚,”周教授开场,”我们组现在的方向–施工过程仿真、数字孪生工地、BIM与结构计算协同–哪一块都绕不开算力。今天要定的是:钱往哪儿花,花多少,买什么。”
智能建造到底在算什么
从试点城市到超级工程
林老师先摆背景:”2022年11月,住建部公布了24个智能建造试点城市,北京、天津、南京、苏州、深圳都在名单里,试点期三年。到现在,智能建造已经从政策词变成了招聘词–企业来要人,简历上要会的东西,第一条就是BIM加仿真。”
小程接着补了一个工程例子:”2024年6月通车的深中通道,全长24公里,集桥、岛、隧和水下互通于一体,是世界上综合建设难度最高的跨海集群工程之一。它的建设全程应用了BIM技术做数字化统筹–沉管预制用自主研发的智能浇筑设备,手机就能监控施工过程,一节沉管的浇筑工期从75天压缩到30天;建成后的海底隧道内布置了14台智能巡检机器人,交通管控也实现了智能化。”
“这两个例子说明一件事,”周教授总结,”智能建造的核心,是把建造过程变成一个可计算、可映射、可推演的过程。而’可计算’三个字,就是算力需求所在。”
三条技术主线,三类计算负载
老吴把话题往实处引:”我常年帮各个组配机器,听下来你们这个方向其实是三条线,每条线吃的硬件不一样。能不能一条条说?”
第一条线是施工过程仿真。小程解释:建筑施工是一个”结构不断出生”的过程–混凝土分层浇筑、爬模逐节上升、桥梁悬臂逐段拼装、隧道分步开挖支护。力学上这叫时变结构,模拟它要用生死单元技术,让单元随施工步激活或移除;还要处理材料时变特性,比如混凝土早期强度增长、收缩徐变,再加上支撑接触非线性和临时荷载转换。一个超高层核心筒的爬模施工模拟,动辄几十上百个施工步,每步都要迭代求解大规模非线性方程组。
“这类计算,”小程说,”吃CPU多核,吃内存容量。网格上到百万自由度以后,普通台式机根本起不动。”
第二条线是数字孪生工地。林老师接话:工地现场的塔吊、爬架、支护和监测设备布上传感器,数据经物联网网关回流;无人机航测和地面激光扫描生成点云,与BIM模型配准融合,在虚拟空间里建一个和现实同步更新的孪生体。孪生体的价值在预测–把实时监测数据喂给仿真模型,推演下一步施工的风险。
“这条线有两层负载:点云处理和模型轻量化,吃GPU显存和图形能力;实时渲染和数据看板要一直开着,对机器的稳定性和并发能力有要求。”
第三条线是BIM与结构计算协同。设计院的BIM模型是信息容器,构件、材料、进度、造价都在里面;结构计算要的是力学模型–网格、边界条件、荷载组合。两者之间靠IFC标准做数据交换,中间要做大量模型简化、剖分和映射。”前处理阶段特别吃CPU单核性能和内存,模型转换经常一跑一晚上。”小程说。
硬件瓶颈对号入座
老吴在白板上画了个对照:
- 施工过程仿真:隐式非线性求解靠CPU多核与大内存,显式动力学类问题靠GPU加速
- 数字孪生:点云配准、模型轻量化、实时渲染靠GPU显存与带宽
- BIM前处理与协同:靠CPU单核主频、内存容量和存储IO
- 课题组共享:多人多任务并发,内存容量和扩展插槽是瓶颈
“所以今天的问题在于,要买的是一套能同时养得起这三条线的算力工作站平台,”老吴说,“单买一台机器顶不住。”
大模型专网部署:给工地配一个”值班工程师”
为什么把大模型请进课题组
讨论会中段,林老师抛出一个新话题:”我们最近和施工企业谈合作,对方问了两件事–施工方案能不能智能审查,监测日报能不能自动问答。这两件事用大模型做很合适,但模型得在我们自己的环境里跑。这就是我说的’大模型专网部署’:模型部署在课题组的服务器上,校内和合作方工地通过专网访问,数据不出内网。”
周教授关心为什么非得本地部署。林老师列了三条:
- 数据安全:施工方案、招投标文件、未竣工项目的监测数据都涉及商业敏感信息,走公有云API等于把工程底牌交到别人手里
- 长期成本:课题组每天都要处理成批的方案文本和监测日报,按API调用计费,一年下来的花费远超本地部署的电费
- 离线可用:工地现场网络条件差,本地部署的问答服务断外网也能照常运转
模型选型与显存账
“选型我做过功课,”小程翻开笔记本,”两个模型组合着用。审查施工方案要深度推理–支护参数合不合规、荷载组合有没有遗漏–用DeepSeek-R1。这是深度求索2025年1月发布的开源推理模型,6710亿总参数的MoE架构,每个token激活370亿,配套的蒸馏版本从15亿到700亿参数都有,小参数版本单卡就能跑。做监测数据问答和知识库检索,用GLM-4.5,智谱2025年7月开源的模型,3550亿总参数、激活320亿,工具调用能力强,适合对接我们现有的监测数据库;它还有个轻量版GLM-4.5-Air,1060亿总参数、激活120亿。”
显存怎么估?小程给出了估算公式:
所需显存 ≈ 参数量(B) × 量化字节数 × 1.2
FP16每个参数占2字节,Q8占1字节,Q4占0.5字节;1.2是KV cache和系统开销的预留系数,上下文越长、并发越高,系数越大。
“按这个口径算几笔账。DeepSeek-R1的320亿参数蒸馏版,Q4量化后约19 GB,留足上下文余量,24 GB显存的卡就能从容跑。700亿参数蒸馏版Q4约39~43 GB,得48 GB起步。GLM-4.5-Air是MoE模型,显存按总参数算,不按激活参数算–Q4约64 GB,一张72 GB以上的专业卡单卡可跑。全量GLM-4.5的Q4约213 GB,DeepSeek-R1本体的Q4约403 GB,只有多卡平台装得下。记住一句话:MoE省的是算力,不是显存。”
量化等级的取舍也要讲清:FP16无损但显存翻倍,Q8精度损失极小、显存减半,Q4是消费级默认档,精度损失在工程问答类任务上通常感知不强,但长上下文场景要多留余量。
速度量级上,老吴补了一句:”纯CPU推理就是每秒几个token,问一句话等一分钟,没人用;单张GPU几十到上百tokens/s,这才是可用和不可用的分水岭。”
微调与推理的差别更关键。用LoRA对320亿参数级模型做轻量化领域适配,显存增量约3~5 GB,推理机顺手就能做;全参数微调哪怕7B模型也要80 GB以上。课题组的定位是”推理加轻量适配”,这一条为后面配置档位的选择上探空间定了调。
软件生态:先把工具链摆清楚
老吴提醒:”买机器之前,先确认你们的软件栈跑在哪类硬件上。”
施工过程仿真这边,通用非线性有限元用ABAQUS,隧道开挖、基坑开挖的分步施工模拟是它的主场,生死单元、接触、材料时变都支持;显式动力学用LS-DYNA,吊装、落物冲击、拆除这一类瞬态问题靠它;岩土方向常用PLAXIS 3D和FLAC3D,专门处理土与结构的相互作用;面向国内工程体系还要做规范校核,MIDAS系列在设计院体系里用得多。
BIM与协同这边,建模用Autodesk Revit和Bentley系列,国产的广联达在造价与施工管理环节渗透很深;碰撞检查和进度模拟用Navisworks;模型交换靠IFC标准,往计算软件导模型时常要借助Geometry Gym这类转换工具,或者直接二次开发。
数字孪生平台这边,实时渲染和交互主流是Unity3D和Unreal Engine,Web端三维常用Cesium承载城市级场景,点云处理靠CloudCompare,航测建模用ContextCapture;孪生体和监测数据对接走MQTT协议接物联网网关。整条链路上,前处理和渲染吃GPU,求解吃CPU多核和内存,数据转换吃单核主频和磁盘IO–和前面的硬件分析正好对得上。
配置推荐:讨论会上开出的四张方案单
从软件回到硬件,中间只差一个朴素的道理:仿真引擎跑得动不动、大模型专网部署稳不稳,最终都要落到具体机器上。课题组买设备跟高校采购流程一样,讲究能用三五年、维护省心、升级有路。老吴结合前面聊的三条技术线和大模型需求,以智能建造算力工作站的定位开出四张方案单,按计算负载从轻到重排。
方案A:轻量起步档
适用场景:BIM正向设计与常规建模、中小规模施工步仿真、14B~32B级量化模型推理,适合刚组建方向或预算有限的课题组。
推荐机型:A350 153128-MCT
- CPU:Intel Ultra9 285K(24核,8P核5.6GHz)+水冷
- GPU:RTX 5090D v2 24GB+水冷
- 内存:128GB DDR5
- 存储:4TB NVME + 8TB SATA
- 显存:24GB
- 显存带宽:1.34 TB/s
- 注:CPU频率为UltraLAB全核超频实测优化频率。
方案B:数字孪生主力档
适用场景:中型结构计算、点云处理与孪生场景实时渲染、70B级Q4量化模型推理与RAG知识库问答,适合以一两个数字孪生项目为主攻的团队。
推荐机型:AR350 148192-MCT
- CPU:AMD锐龙9950X3D(16核,4.8~5.7GHz)+水冷
- GPU:RTX 4090 48G+水冷
- 内存:192GB DDR5
- 存储:4TB NVME + 8TB SATA
- 显存:48GB
- 显存带宽:1.01 TB/s
- 注:CPU频率为UltraLAB全核超频实测优化频率。
方案C:并行仿真专网档
适用场景:大型基坑、隧道开挖的并行有限元仿真,GLM-4.5-Air级模型的专网部署与多人并发访问,适合承担横向课题较多的应用型课题组。
推荐机型:GX660M 227384-MD4T
- CPU:2×Xeon金牌6530(64核,2.7~4GHz)
- GPU:4×RTX 4090 48G+水冷
- 内存:384GB DDR5
- 存储:8TB NVMe
- 显存:192GB
- 显存带宽:4×1.01 TB/s
- 注:CPU频率为UltraLAB全核超频实测优化频率。
方案D:课题组共享平台档
适用场景:全量DeepSeek-R1或GLM-4.5级模型的本地部署、数字孪生渲染与仿真求解多任务并发、多课题组共享的私有算力平台。
推荐机型:GX660M 227768-MD6E_Pro6000
- CPU:2×Xeon金牌6530(64核,2.7~4GHz)
- GPU:6×RTX Pro 6000 96G
- 内存:768GB DDR5
- 存储:8TB NVMe
- 显存:576GB
- 显存带宽:6×1.79 TB/s
- 注:CPU频率为UltraLAB全核超频实测优化频率。
“注意,”老吴强调,”这四档是起点不是终点。方案C将来要接全量大模型,加卡扩容就是;方案A用两年不够用了,内存和存储都能往上加。买工作站买的是平台,一步到位买顶配反而有一半性能用不上。”
常见问题
BIM模型能直接做有限元计算吗?
不能直接算。BIM模型是信息模型,装的是构件属性、进度、造价这些工程信息;有限元计算需要力学模型,包括网格、单元类型、材料本构、边界条件和荷载。两者通过IFC等标准交换数据之后,还要做几何简化、剖分和力学属性映射。工程上常见的做法是保留BIM作为数据源,按计算需求派生力学子模型,算完再把结果挂回BIM构件上。
数字孪生工地和普通三维可视化有什么区别?
三维可视化把模型画出来给人看,数据是静态的;数字孪生要求虚拟模型和物理工地之间有实时或准实时的数据通道–传感器数据进来,孪生体状态跟着更新,并基于仿真模型对未来施工状态做推演预警。前者偏展示,后者偏计算。这也是为什么数字孪生工地的后端通常要挂仿真服务器和大模型问答服务。
大模型专网部署之后还需要联网吗?
部署完成后不需要外网。下载模型权重和后续更新时需要外网,推理服务本身完全在内网运行。施工方案审查、监测数据问答这类服务面向课题组和合作工地开放,走校内专网或VPN即可,断外网不影响使用。这正是专网部署相对公有云API的核心优势。
施工仿真一定要GPU吗?
不绝对。隐式非线性求解(ABAQUS、MIDAS为主)主要靠CPU多核和大内存,GPU加速有限;显式动力学和岩土方向的部分算法GPU加速明显;数字孪生的点云处理、模型轻量化、实时渲染则基本靠GPU。所以纯做施工步仿真的组,可以先上高主频多核CPU配大内存;做点云和孪生渲染的组,必须把预算向GPU倾斜。
一台机器多人共用会不会排队?
会,但有办法缓解。轻量任务(BIM建模、文档处理)和重度任务(大规模求解、模型推理)分机器部署,本身就错开了峰值;多卡平台支持调度,可以把仿真求解、渲染、大模型推理分配到不同GPU上同时跑;再配上任务队列管理,错峰效果明显。真到了天天排队的规模,就该考虑上集群了。
现在买的机器以后还能升级吗?
工作站的设计寿命通常在五年以上,升级空间主要看三点:内存插槽是否还有余量、扩展插槽能否加卡、电源功率是否留有余量。多卡平台后期加内存、加GPU都比较直接;入门塔式机型升级显卡和内存也没问题。采购时把未来三年的需求增长写进论证报告,比一步到位买顶配更务实。
结语
散会前,周教授把四张方案单折起来:”今天至少有两件事想明白了。第一,智能建造这个方向,算力是生产资料,省不得–模型算不动,论文和项目都谈不上。第二,大模型专网部署这条路得走,而且要和仿真平台一起规划,不能各买各的。”
小程在旁边补了句:”那我先把算力缺口清单按这四档重新排一下。”
老吴收拾着白板笔,留下最后一句:”机器只是底座。你们把施工力学和数字孪生搞通了,底座才值钱。”
工作站配置选型欢迎咨询~
微信号:maxftxwx
fuyiqin@xasun.com












