
一个方向的悄然扩容
这两年能源动力专业的课题组里,最能感觉到”方向在变”的,是做储能的那批人。
南京航空航天大学能源与动力学院2025年5月公布的博士招生专业目录里,”电池热管理”和”先进储能技术”已经作为独立方向挂在导师名下招收博士生——前者依托航空飞行器热管理与能量利用工信部重点实验室,后者则把研究边界一路推到太阳能光热转换与合成燃料。往早了看,该院连文磊教授团队在2021年1月申请、同年5月公开的发明专利”一种基于浸没式沸腾传热的动力电池组热管理系统”,让电池泡在绝缘工质里靠沸腾换热控温,思路相当激进。这些信号连起来读就一句话:储能已经从”电池化学”的问题,长成”热科学加系统工程”的问题。
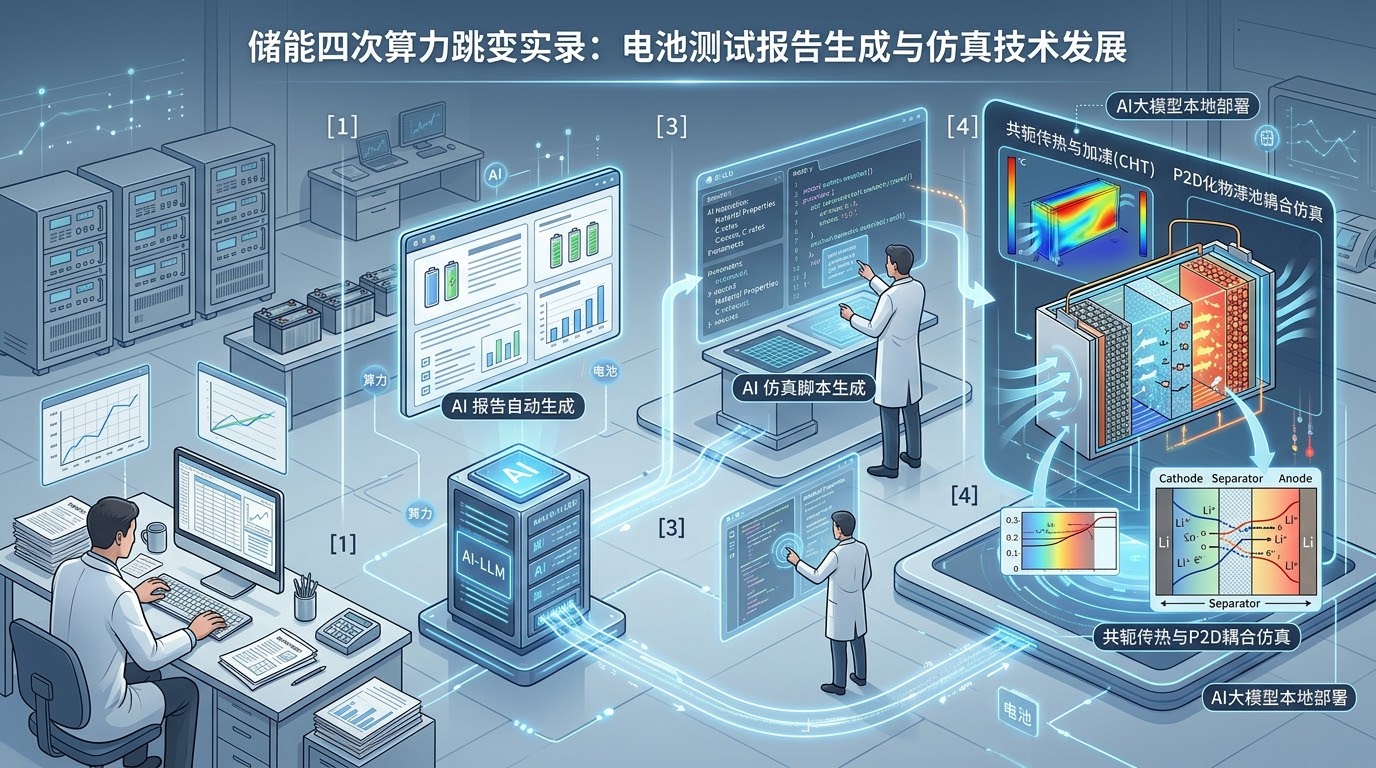
问题变大了,算力需求跟着变形。一个能源动力专业的学生,从本科竞赛第一次打开电池仿真软件,到博士毕业前搭起课题组的储能计算平台,七八年时间里,他要面对的网格规模会从几十万膨胀到几千万,内存需求会从”笔记本还凑合”涨到”没有768GB内存连算例都提交不了”。这篇文章按这条时间线走一遍,把每个阶段的技术瓶颈和硬件账本算清楚——尤其是那个被问到最多的问题:电池包热仿真,内存到底要多大?
算力需求的四次跳变
第一次跳变:本科竞赛——单体电芯产热仿真
故事从一个普通本科生开始:大三大四参加创新项目或数学建模竞赛,题目是”某型磷酸铁锂电池的散热优化”,第一件事是给单体电芯建产热模型。
电池产热的经典框架是Bernardi在1985年提出的能量平衡公式:产热功率等于焦耳热加上可逆的熵热,前者由充放电电流平方乘内阻给出,后者来自开路电压对温度的偏导项。实际工程里,学生通常用等效电路模型算出内阻和产热率曲线,作为热源加载到三维固体传热模型。这个阶段的网格规模很小:电芯本体加一个风冷通道,几十万网格足够,稳态求解器跑一轮几分钟到十几分钟。
硬件门槛也低得可爱:一台内存32GB的游戏本就能应付,甚至能跑跑开源电化学仿真工具PyBaMM验证SOC曲线。但”能跑”有前提:冷却气流被简化成一个经验对流系数。一旦认真算电芯间隙里的真实流动,网格数和求解时间都立刻上一个台阶。
第二次跳变:硕士课题——整包热管理CFD
读上硕士,课题升级为”某储能电池包液冷板流道设计”。这一步跨得非常大,因为研究对象从”一根电芯”变成了”几十到上百根电芯加一整张液冷板”,从”固体传热”变成了”流固共轭传热”。
共轭传热意味着流体域和固体域联立求解:对流换热系数不再靠猜,由流场算出后反馈给固体侧温度场。电芯按Bernardi公式发热,热量穿过导热硅胶垫和铝基液冷板,被乙二醇水溶液带走。流道往往做成蛇形、U形或叉状并联结构,入口流量、流道截面积、导流板开孔全是设计变量。
网格规模直接跳到五百万到两千万。流体域贴着流道边界层加密,固体域要分辨每颗电芯和导热垫,瞬态计算每个时间步还要保存全场数据。工程经验法则是:带能量方程的瞬态CFD每百万网格吃掉36GB内存,流固两侧网格要合并计算。折算下来,一千万网格的整包瞬态算例,求解器占3060GB,加前后处理和系统开销,128GB是起步线;做流道参数扫描往往要同时挂两三个算例,256GB才不觉得紧。
这就是标题那个问题的直接答案:电池包热管理CFD,内存至少128GB,认真做优化建议256GB起步。笔记本在这个量级上彻底出局:内存容量装不下这种规模的求解域,散热也压不住满载数小时的求解器。
第三次跳变:博士阶段——电化学-热-流多物理场耦合
博士开题后,物理层次又深一层。导师会问:产热率从等效电路来,能不能从电化学机理推出来?电芯内部的锂离子浓度分布、局部产热不均匀性,都会影响寿命预测和热失控早期特征。
于是模型从”集总产热加传热”升级为”电化学-热-流多物理场耦合”。电化学层用多孔电极理论(P2D模型)描述正负极内的反应与扩散,热层把空间分布产热接过来,流层继续负责冷却回路。三场耦合的代价是内存近似翻倍:电化学子模型要在每个电芯里再嵌一层网格,时间步长被电化学动力学压得更小,工况矩阵一旦铺开——低温、高温、高倍率、不同SOC窗口——就是几百个瞬态算例排队。
这个阶段还叠着一桩体力活:参数辨识。HPPC脉冲测试、不同倍率的温度响应,都要先拟合出内阻、熵热系数和热物性参数才能喂给模型。一个循环工况导出的数据动辄几百MB,一个项目攒下几十个G的测试数据是常态。
第四次跳变:课题组平台——储能系统数字建模与共享
博士后期或者留校工作后,角色从”用机器的人”变成”管机器的人”。师弟师妹加入,方向从电芯、电池包扩展到储能系统级:集装箱储能电站的热管理、PCS功率变换与电池的联合仿真、BMS策略在环验证。这时候系统级数字建模工具登场:用Simulink加Simscape Battery这类部件库,把数百个电芯的等效电路、热网络、冷却回路和控制策略连成整机模型,跑一整天的典型工况曲线。
系统级模型单机就能算,但组里真正的矛盾变成了资源争抢:三个人同时要提交千万网格的CFD算例,两台工作站轮流排队,一个人的参数扫描能堵住全组一周的机时。这时候需要的是一个共享计算平台——大内存、多GPU、能同时吃下多个并发算例,顺便把组里积压的测试报告生成、参数脚本整理这些杂活也接过去。
算力曲线到这里不再是爬坡,而是跳台阶:每换一次课题层级,网格规模涨一个数量级,内存需求翻两三倍,而经费批复永远滞后半年。
AI大模型本地部署:把测试报告和参数脚本的杂活交给私有模型
走到这一步的课题组会自然产生一个念头:测试报告能不能自动生成?充放电测试仪导出的原始数据、热仿真算例的边界条件参数表,这些整理工作年复一年地消耗研究生的时间。这正是储能方向做AI大模型本地部署的价值所在。
先说为什么必须本地部署。第一,电池测试数据是企业或课题组的核心资产:循环寿命曲线、热失控实验记录、HPPC原始数据,直接决定下一代产品的竞争力,这类数据走公网API等于把底牌交给别人。第二,很多中试场地和实验室物理隔离,根本不通外网。第三,按三年周期算,一个课题组要生成的测试报告、工况说明、仿真参数文档数以千计,长期调用API的费用会超过一次性投入的本地硬件。
模型选型上,32B级 dense 模型是性价比最高的档位。做储能测试报告生成,可以选阿里2025年4月开源的Qwen3-32B,Apache 2.0许可,128K上下文足够一次性吞进几十页原始数据加模板;做热仿真参数脚本场景提取——从case文件和测试记录里抽出边界条件、物性参数,生成Fluent UDF或Python批处理脚本——Yi-1.5-34B在代码和数学任务上的训练强化正对这个场景。
显存账这样算:所需显存约等于参数量乘以量化字节数再乘1.2的KV cache预留系数。FP16每参数2字节、Q8每参数1字节、Q4每参数0.5字节。两个算例:Qwen3-32B在Q4下约需1922GB显存,Yi-1.5-34B在Q4下约需2023GB——也就是说24GB显存是舒适线,24GB的卡能从容跑起其中任何一个。开FP16则要77GB左右,Q8落在38GB左右。Q4成为默认选择的原因很实际:报告生成和脚本抽取对数值精度不敏感,Q4的精度损失几乎无感,显存占用却只有FP16的四分之一。
速度是另一道分水岭。CPU纯内存推理只有个位数tokens/s,一份十页测试报告要等到天荒地老;单卡GPU稳定在几十到上百tokens/s,带数据表格的报告草稿几分钟出炉。所以它属于工作站,不属于办公电脑。
最后区分推理和微调。用LoRA对32B模型做储能领域适配,比如让它学会你们组测试报告的行文格式,显存只需在推理基础上增加3~5GB——28GB左右的显存就能边推理边微调。但全参数微调完全是另一回事:7B模型全参微调就要80GB以上显存,32B全参得数百GB,那是平台级机器才玩得起的配置。对多数课题组,Q4推理加LoRA适配,已经覆盖了九成的日常杂活。
储能仿真软件生态:从电化学机理到系统级数字建模
硬件聊清楚之前,先把这条技术链上常用的软件摆一遍。
- 电化学仿真:COMSOL的电池模块是多物理场耦合主力,P2D电化学、固体传热、流体对流能在同一界面联立;开源侧有PyBaMM,轻量可脚本化,适合批量工况。
- 电池包CFD:ANSYS Fluent内置电池模块和共轭传热求解流程,工业界装机量最大;STAR-CCM+在电池包热管理方向有专用流程模板,自动化程度高。
- 开源CFD:OpenFOAM免授权费,适合经费紧张但要深度定制的课题组,代价是上手成本高。
- 系统级数字建模:MATLAB/Simulink加Simscape Battery,用等效电路加热网络搭整机模型,是BMS策略在环验证的标准环境。
- 胶水层:Python。参数辨识、测试结果对接、报告生成,都靠它把测试仪器、仿真求解器和大模型串成流水线。
一个务实的建议:电化学和系统建模在工作站上完成,千万网格级的电池包CFD交给大内存机器,软件授权跟着硬件分工走,能省下一笔不小的浮动授权费用。
配置推荐:按科研阶段对号入座
从本科竞赛到课题组平台,这条成长线上每个节点的算力需求都差着数量级。高校买设备跟企业不一样,钱要花出去还得过采购流程、过资产验收,最好一台机器能撑过两届学生的毕业周期。所以下面这几套方案按”够用三年、升级有路”的原则来搭,你可以把它当成写采购申请时的参考底稿,再按组里实际课题方向裁剪。
方案A:本科竞赛与课程设计
适用场景:单体电芯产热建模、小型电池包稳态散热分析、数学建模竞赛、本科毕业设计,网格规模百万级以内;同时覆盖Qwen3-32B或Yi-1.5-34B的Q4量化推理,用于测试报告草稿生成和入门大模型练习。
推荐机型:A350 153128-MCT
- CPU:Intel Ultra9 285K(24核,8P核5.6GHz)+水冷
- GPU:RTX 5090D v2 24GB+水冷
- 内存:128GB DDR5
- 存储:4TB NVME + 8TB SATA
- 显存:24GB
- 显存带宽:1.34 TB/s
- 注:CPU频率为UltraLAB全核超频实测优化频率。
方案B:硕士课题主攻电池包热管理CFD
适用场景:五百万至两千万网格的电池包流固共轭传热瞬态计算、液冷板流道优化与参数扫描;48GB级显存可同时承担34B级模型推理和LoRA微调,让测试报告生成流水线跑在算CFD的同一台机器上。
推荐机型:AE450 141384-MDD
- CPU:AMD霄龙9755(128核,4.1GHz,512MB缓存)
- 图形卡:Quadro T400
- 计算卡:RTX Pro 5000 48GB
- 内存:384GB DDR5
- 系统盘:2×4TB NVME SSD
- 数据盘:20TB SATA
- 显存:4GB / 48GB
- 显存带宽:80 GB/s / 1.34 TB/s
- 注:CPU频率为UltraLAB全核超频实测优化频率。
方案C:博士课题多物理场耦合与寿命预测
适用场景:电化学-热-流三场耦合、全气候工况矩阵批量计算、热失控传播模拟;大容量内存容纳两千万级以上网格和多个并发算例,也能为32B级模型的LoRA适配提供余量。
推荐机型:EA660 235768-MCT
- CPU:2×AMD霄龙9755(256核,3.5GHz)+水冷
- GPU:RTX 5090 32G+水冷
- 内存:768GB DDR5
- 系统盘:2TB NVME+4TB NVME
- 数据盘:2×20TB SATA
- 显存:32GB
- 显存带宽:1.79 TB/s
- 注:CPU频率为UltraLAB全核超频实测优化频率。
方案D:课题组储能计算平台
适用场景:储能系统级数字孪生建模、多用户并发提交算例、70B级模型推理API服务和全参数微调探索,覆盖5~10人课题组的共享需求,把测试报告生成、参数脚本提取这类杂活统一收编到私有算力上。
推荐机型:GX660M 227768-MD6E_Pro6000
- CPU:2×Xeon金牌6530(64核,2.7~4GHz)
- GPU:6×RTX Pro 6000 96G
- 内存:768GB DDR5
- 存储:8TB NVMe
- 显存:576GB
- 显存带宽:6×1.79 TB/s
- 注:CPU频率为UltraLAB全核超频实测优化频率。
常见问题
电池包热仿真的内存到底怎么估?
经验法则是带能量方程的瞬态CFD每百万网格占36GB内存,流固共轭传热要把两侧网格加在一起算。一个一千万网格的整包瞬态算例,求解器占3060GB,加前后处理和系统开销,128GB是起步线;要做到流道参数扫描不憋屈,建议256GB起步。
内存够了,为什么算例还是慢?
内存决定”能不能跑”,速度取决于CPU核心数和存储IO:千万网格级瞬态算例每个时间步都读写大量中间数据,IO跟不上,求解器会卡在写盘上。排查时先看资源占用分布,再决定加核、换盘还是加内存。
笔记本能跑电池包CFD吗?
单体级和小电池包的稳态问题可以,整包瞬态共轭传热不行。瓶颈在内存上限和散热:32GB内存装不下一千万网格的求解域,满载几小时的求解器也不是笔记本散热压得住的。
Qwen3-32B和Yi-1.5-34B能在一台机器上同时加载吗?
Q4量化下两个模型各需约20GB显存,双开需要48GB以上显存,或者两张24GB卡各跑一个。如果还想留LoRA微调的余量,建议直接上48GB显存的机型,一次到位。
做储能仿真,CPU和显卡哪个优先?
求解阶段CPU和内存优先,主流电池包CFD求解器的并行主力是CPU核;显卡的价值在本地大模型推理和可视化后处理。除非买了求解器的GPU加速授权,否则预算先堆内存和核心数,再考虑显存。
课题组该集中买一台旗舰,还是买几台中档?
看任务能否拆分。储能负载天然可分:CFD求解、系统建模、大模型推理各占一类资源,三台定位不同的中档机比一台旗舰更不容易排队。某方向真正吃满单机后再升级那一路。
结语
回看四次跳变,从几十万网格的单体产热到两千万网格的整包共轭传热,再到三场耦合和共享平台,算力需求几乎没有线性增长过——它总在换课题层级的那个学期突然翻倍。内存买多大,答案取决于你站在哪个阶段,更取决于两年后要站在哪里。对储能这个还在长个子的方向,给机器留足余量,本质上就是给课题留足余地。
工作站配置选型欢迎咨询~
微信号:maxftxwx
fuyiqin@xasun.com












