
项目缘起:一条代工厂产线的排产难题
2025年初,长三角一家3C结构件代工厂找到我们,问题很典型:厂里十二条注塑产线、三百多台设备,排产全靠计划员的经验加一张Excel表。旺季订单插单频繁,平均每周有两次”今天刚排好的计划,明天被紧急订单全部打乱”的情况。厂长算过一笔账:排产不合理导致的设备空转和加班成本,一年大概损失七位数。
这个方向的火热,从学术界也能看出来。2025年11月,第九届自动化、控制和机器人国际会议(ICACR 2025)在西安举办,西安电子科技大学是主办方之一,会议专门设置了”工业工程、生产和管理”分论坛,议题包括供应链和物流工程、生产计划、调度和控制、智能制造与自动化。调度这个老话题,在智能制造的新背景下重新成了显学。另一个可以参考的实例是西安电子科技大学2023年11月获得授权的发明专利”智能仓储环境下的任务调度方法”(专利号ZL202110650745.2),它针对双深位多层穿梭车储分系统,用遗传算法框架求解货物调度方案:先按目标函数把种群个体划分到不同等级的支配层,再通过交叉、变异不断迭代,目标是解决双深位系统的阻塞货物重排问题、缩短出货时间。调度问题的核心数学结构,在车间、仓库、产线之间是相通的。
厂方给项目组的要求很直接:三个月内拿出一套能用的排产优化方案,先仿真验证,再上试点产线。
技术攻关节点一:前期调研——先把问题仿真出来
接题之后的第一步是建模仿真,算法可以往后放。工业工程里有个朴素的共识:你连系统怎么运转都模拟不出来,就谈不上优化它。
离散事件仿真是这类问题的标准工具。它把产线抽象成实体、资源、事件三类对象:工件按工艺路线流动,设备是资源,工件到达、加工完成、设备故障是事件。仿真时钟不连续推进,而是从一个事件直接跳到下一个事件,所以几十万次事件也可以在几分钟内跑完。
前期调研阶段跑的是小模型:一条产线、十几台设备、几种产品。我们用Plant Simulation和FlexSim分别搭了一遍,互相校验。这个阶段对硬件的要求其实不高,普通桌面工作站就能胜任,但有两个细节值得注意:一是建模和调试阶段交互操作多,CPU单核性能决定拖拽和编译的流畅度;二是仿真软件本身对内存的胃口随实体数量线性增长,小模型32GB内存够用,但已经能感到紧张。
技术攻关节点二:模型构建——单核性能和内存的第一道坎
进入全厂建模阶段,问题开始显现。十二条产线、三百多台设备、两百多种产品型号,光是物料清单和工艺路线数据就整理了三周。模型里每个实体在每个仿真时刻都携带一串属性:当前工位、排队时长、优先级、设备状态。实体数上万之后,内存占用曲线陡然上升。
离散事件仿真有个容易被低估的特点:事件调度本身开销不小。每次事件入队、出队、排序,都要操作未来事件表。业界常用的二叉堆结构单次操作是对数量级,事件总数冲到百万级时,主循环对CPU单核性能非常敏感。所以仿真工程师圈子里有个共识:宁可要一颗高频的八核CPU,也不要一颗低频的六十四核CPU——至少在建模调试阶段是这样。
我们最初在组里的老机器上跑全厂模型,加载一次模型要四分钟,每改一个参数重新编译又要两分钟。一天的有效工作时间被切成十几段,效率低得让人烦躁。后来换到高频多核的平台上,加载时间缩到四十秒,交互建模的卡顿感基本消失。
这个节点的教训:仿真建模阶段,CPU主频和内存容量是硬指标,GPU几乎用不上。
技术攻关节点三:调度求解——算例规模翻倍,计算量翻十倍
模型跑通之后,真正的硬骨头才露出来:柔性作业车间调度问题。三百多台设备、两百多种产品,每种产品工艺路线不同、可用设备集合不同、换模时间还取决于前后工序的组合,这是教科书级的NP难问题。精确求解器在小算例上能给出最优解,算例规模一上来就组合爆炸,实际工程里基本靠启发式算法。
项目组对比了两条路线:一条是遗传算法加非支配排序的多目标框架,优化目标包括最大完工时间、总拖期、设备利用率;另一条是近年很热的深度强化学习排产。前者可解释性好、工程落地稳;后者训练数据要求高,换一条产线就要重新训练,泛化性是硬伤。和厂方沟通后选了第一条路线,这也和前面提到的智能仓储调度专利思路一致:用进化算法框架在可接受时间内逼近满意解,对理论最优不作执念。
麻烦在于计算量。多目标遗传算法每一代要维护几百个个体,每个个体都要调用仿真模型评估适应度。全厂模型单次仿真跑一次要八分钟,一代评估就要几百次,一百代下来纯CPU时间直奔数千小时。我们做了两件事:一是把评估粒度做粗,先用聚合模型筛选,再用精细模型复评;二是把评估环节并行化——群体评估天然并行,个体之间没有依赖,直接分发到多个CPU核心上。
并行化之后,瓶颈从CPU核心数转移到了内存带宽和存储IO上。几百个并行仿真进程同时读写未来事件表和结果日志,内存带宽先打满,随后是结果写入的IO争抢。这个阶段我们真切体会到:多核CPU只是入场券,内存容量、内存通道数、NVMe盘的持续写入速度,决定并行效率能不能兑现。
技术攻关节点四:数字孪生——结果要看得见
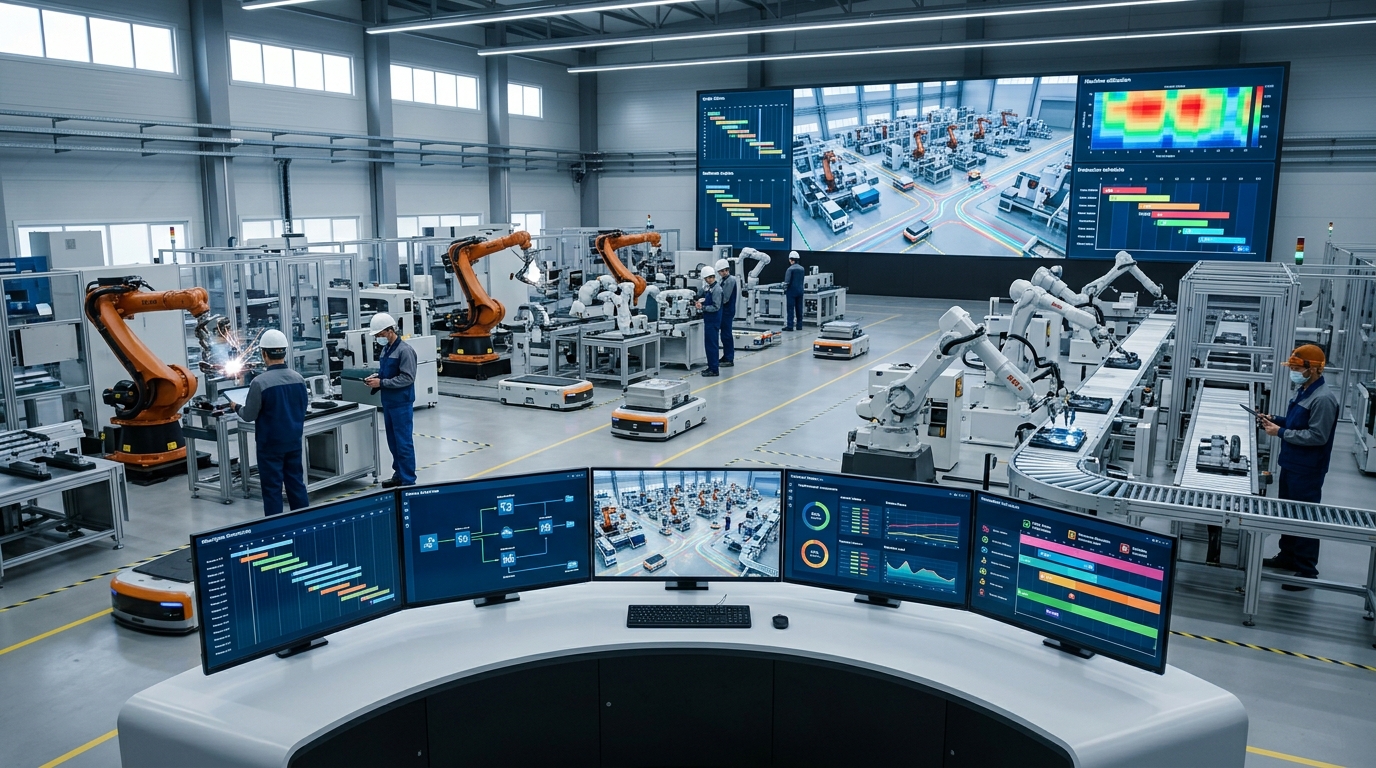
算法跑出结果,还得让厂长和车间主任看懂。纯数据表格说服力有限,项目组把全厂模型接上了三维可视化:厂房、产线、设备按真实比例建模,仿真运行时能实时看到工件流转、设备状态、缓冲区堆积,瓶颈工位直接标红。这就是轻量级的数字孪生——仿真模型驱动三维场景,实时数据反向校准模型参数。
数字孪生对硬件的需求和前三阶段都不一样:实时渲染吃GPU,大场景贴图和顶点数据吃显存,多视角同步演示吃多路视频输出。我们试过用游戏本演示,三维场景一开,帧率掉到十几帧,风扇噪音大得盖过人声。换到带专业显卡的工作站之后,同样场景稳定在六十帧,后台仿真照常跑。
到这里,一个完整项目的技术链路就清晰了:离散事件仿真建模考验CPU单核和内存,调度求解考验多核并行、内存带宽和存储IO,数字孪生可视化考验GPU和显存。三个阶段三种瓶颈,没有哪台机器能同时便宜又全能,只能按预算和优先级取舍。
AI大模型本地部署:让工作站自己写排产脚本
这个项目的转折点出现在中期汇报之前。组里同学发现,每天大量时间花在写胶水上:把仿真结果导成报表的脚本、批量生成仿真场景的配置文件、遗传算法的参数调优代码。这些代码不复杂,但繁琐、容易出错。我们尝试在工作站上本地部署开源大模型,让它承担这部分工作,效果出乎意料地好。
先说为什么放着云端API不用、坚持本地部署。第一,排产脚本里嵌着产线节拍、瓶颈工位、订单结构,工艺参数是工厂的核心商业机密,传到公网API等于把家底交出去。第二,车间现场网络环境封闭,很多工厂内网根本不通公网,离线可用是硬要求。第三,按项目周期折算成本,本地一次性投入比按token付费的云端调用便宜一个数量级,代码越写越多,差距越明显。
模型选型上我们试了两款开源模型。一款是零一万物2024年5月开源的Yi-1.5-34B,34B稠密参数,数学和代码能力强,适合生成遗传算法、排产逻辑这类严肃脚本。另一款是阿里2025年4月开源的Qwen3-30B-A3B,混合专家架构,总参数300亿、每token只激活30亿,吞吐量高,适合多人并发解读仿真报告、回答工单问题。
显存账要算清楚。估算公式很简单:所需显存约等于参数量(B)乘以量化字节数再乘以1.2,1.2是上下文缓存和系统开销的预留系数。按这个口径,Yi-1.5-34B用FP16需要约34×2×1.2等于82GB显存,单张消费级显卡装不下;量化到Q4,每参数0.5字节,约20GB,24GB显存就能舒适运行。Qwen3-30B-A3B虽然每token只激活30亿参数,但显存要按300亿总参数算,Q4同样约18GB——MoE省的是算力,显存一分都省不了。三档量化的选择逻辑也直观:FP16精度最高但占显存最多,Q8折中,Q4精度损失通常只有一两个百分点,显存却只有FP16的四分之一,这也是消费级显卡上Q4成为默认选择的原因。
速度方面,纯CPU推理这两款模型都只有个位数tokens/s,写脚本会急死人;换到单张高性能显卡,Q4量化下能跑到几十甚至上百tokens/s,体验和云端API基本无差。微调我们也试过:用LoRA方法在量化版Yi-1.5-34B上继续训练,让它学会厂里的排产业务术语和报表格式,显存增量约8~12GB,单张48GB显存的卡就够用。全参数微调想都不要想,34B模型需要200GB以上的显存,那是多卡服务器的领域。
部署了大模型之后,项目组的人均产出明显提升:仿真报表脚本由大模型生成、人工校验,时间从半天缩到一小时;新同学上手仿真软件,直接问本地模型,不用翻半天手册。
常用软件清单
这个方向的主流工具链分四层。建模仿真层:Siemens Plant Simulation、FlexSim、AnyLogic、Arena,前三者在高校和企业里用得最多,AnyLogic还支持系统动力学、基于主体建模和离散事件三种范式混建。调度求解层:MATLAB加YALMIP做快速原型,Gurobi、CPLEX处理中等规模的精确求解,Python生态里的OR-Tools免费且接口友好,做大规模启发式算法绕不开它。数据与接口层:Python加Pandas处理仿真日志,SQLite或轻量数据库存中间结果。可视化层:Unity3D或虚幻引擎搭三维场景,配合OPC UA接口做仿真数据对接。
项目组的最终配置方案
原理聊得再多,最终还是要落到”这台机器能不能把三个月的工期撑下来”这个问题上。项目组复盘整个项目周期,按三个阶段的负载特征,把当时如果能重来一次会选的配置整理成下面三档,供同类课题参考。
方案A:课程设计与中小规模产线仿真
适用场景:本科课程设计、毕业设计级离散事件仿真模型,单一产线或小型车间的建模与优化,Yi-1.5-34B Q4量化本地推理辅助写代码。
推荐机型:A350 153128-MCT
- CPU:Intel Ultra9 285K(24核,8P核5.6GHz)+水冷(5.6GHz为全核超频实测优化频率)
- GPU:RTX 5090D v2 24G 水冷
- 内存:128GB DDR5
- 存储:4TB NVMe + 8TB SATA
- 显存带宽:1.34 TB/s
方案B:课题组级多产线仿真与调度优化
适用场景:多产线联合仿真、供应链网络模拟、柔性作业车间调度多目标优化大规模算例并行评估。这台机器的定位是计算主力——大模型解读报告、生成排产脚本的任务,交给方案A或方案C级别的显卡机型完成。
推荐机型:AE450 141384-MCB
- CPU:AMD霄龙9655(96核,4.14.5GHz,384MB缓存)(4.14.5GHz为全核超频实测优化频率)
- GPU:RTX A1000 8GB
- 内存:384GB DDR5
- 存储:4TB NVMe
- 显存带宽:192 GB/s
方案C:数字孪生工厂与多任务并行平台
适用场景:厂区级数字孪生实时三维渲染、多仿真场景并行评估、大模型并发服务与LoRA微调,一机支撑课题组公共平台。
推荐机型:GX660M 227192-MC4T
- CPU:2×Xeon金牌6530(64核,2.74.0GHz)(2.74.0GHz为全核超频实测优化频率)
- GPU:4×RTX 5090D 32G 水冷
- 内存:192GB DDR5
- 系统盘:4TB NVMe
- 数据盘:20TB SATA
- 显存带宽:4×1.79 TB/s
如果重来一次,我们会怎么选
第一,不会在一开始就把预算大头押在显卡上。项目前两个月GPU使用率几乎为零,建模和求解全靠CPU和内存,显卡的钱省下来加到内存上更划算。
第二,不会为了省钱把内存卡在最低配。全厂模型的临时实体表和事件表膨胀速度远超预期,后期加内存不如一步到位。
第三,不会一上来就幻想全参数微调排产大模型。LoRA微调配合好的提示词工程已经能解决八成问题,全参数微调的预算应该留给真正的训练服务器。
第四,数字孪生演示不会用游戏本凑数。厂房现场环境复杂,长时间渲染的稳定性比峰值性能重要,专业显卡的驱动稳定性和显存容量是刚需。
常见问题FAQ
生产仿真软件到底吃CPU还是吃GPU?
建模和求解阶段主要吃CPU主频、核心数和内存,GPU只在三维可视化阶段才成为瓶颈。预算有限时,优先保证CPU和内存,显卡按需后置。
离散事件仿真的内存怎么估?
经验法则是实体数乘以单个实体的属性开销,再留出一倍余量给未来事件表和结果缓存。几千个实体32GB起步,几万个实体建议128GB以上。
运筹优化求解器需要什么配置?
Gurobi、CPLEX这类求解器吃CPU多核和内存带宽,大规模算例建议内存按问题规模的十倍预留;OR-Tools做启发式则和仿真类似,主频优先。
数字孪生和普通仿真的硬件差别在哪?
普通仿真输出数据,数字孪生要实时渲染三维场景并对接现场数据流,显存容量、显卡驱动稳定性和多路输出能力是分水岭。
学生做毕业设计,最低什么配置能起步?
单一产线的小模型,24GB显存加高频CPU的入门工作站足够,还能顺带跑34B级大模型的Q4推理辅助写代码。
已有高性能游戏本,能替代工作站吗?
小模型调试可以,长时间大规模仿真不行:散热压不住持续满载,内存上限太低,三维渲染和多任务并行会互相抢资源。
结语
三个月后,项目组的排产方案在试点产线跑了起来:平均完工时间下降11%,紧急插单的响应时间从两天缩到四小时。厂方满意,项目组也攒下了一套从仿真建模、调度求解到数字孪生的完整方法论。
回头看,这个项目真正贵的地方是时间,硬件反而排在后面。一台匹配负载特征的工作站,把每个环节的等待时间砍掉一半,三个月工期里省出来的就是完整的验证轮次。智能制造调度的算法会越来越聪明,但算力这个老伙计,依然决定了你能不能把聪明劲儿按时兑现。
欢迎咨询~
微信号:maxftxwx
fuyiqin@xasun.com












