
本文采用技术分析视角,以清华大学科学计算研究为参照系探讨行业趋势。文中提及的学术成果均来自公开文献,不代表任何官方立场。硬件配置建议仅供参考。
一、写在前面:2024年诺奖引发的”AI for Science”狂潮
2024年10月,诺贝尔物理学奖授予了John J. Hopfield和Geoffrey E. Hinton,表彰他们在人工神经网络和机器学习领域的基础性贡献。这个消息让计算数学圈炸开了锅——连诺贝尔奖都认可了神经网络在科学发现中的价值。
在清华大学丘成桐数学科学中心,这种趋势早有预见。2025年2月,曾在阿卜杜拉国王科技大学(KAUST)工作的何俊材博士正式加入清华,担任助理教授。他的研究方向正是科学计算与机器学习的交叉——尤其是从有限元方法的角度理解和设计深度神经网络。
何俊材团队的代表作MgNet(2019)和MgNO(2024),开创了将多重网格方法与神经网络结合的新范式。前者首次将多重网格与卷积神经网络统一,后者则通过多重网格结构高效参数化神经算子中的线性算子,仅用2.1百万参数就能学习从点源和波速到波场的复杂映射。
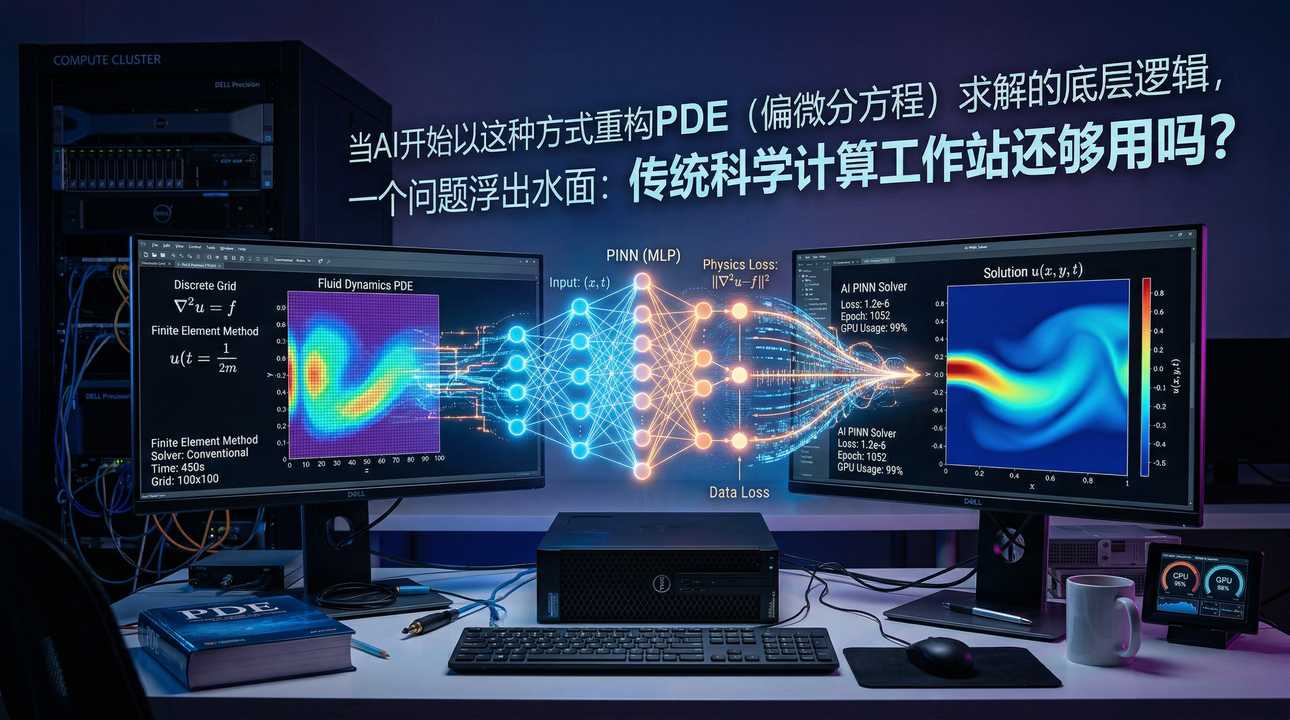
当AI开始以这种方式重构PDE(偏微分方程)求解的底层逻辑,一个问题浮出水面:传统科学计算工作站还够用吗?
答案是:不够,但也别担心——关键是买对方向。
本文就从算法本质、前沿技术、行业痛点三个维度,聊聊AI时代的科学计算工作站该怎么配。
二、算法本质:传统方法 vs AI方法,硬件需求有何不同?
1. 传统数值方法:稀疏矩阵求解的”内存密集型”选手
有限差分法(FDM)、有限元法(FEM)、谱方法(Spectral)——这些传统方法的共同点是离散化后转化为大规模稀疏线性系统求解。Ax=b
其中A是稀疏矩阵(非零元占比通常<0.1%),维度可能达到百万甚至千万级。
计算瓶颈:
- 直接求解器(如MUMPS、SuperLU):适合中小规模,但内存需求随维度立方增长(O(N³))
- 迭代求解器(如CG、GMRES):内存友好,但收敛速度依赖预处理子质量
- 多重网格法(Multigrid):理论上最优复杂度O(N),但实现复杂,需要精细的网格层级设计
硬件需求特点:
- 内存是王道:稀疏矩阵存储(CSR/CSC格式)+ 多重网格的粗网格层级,需要大内存容量
- CPU并行性好:稀疏矩阵向量乘(SpMV)可以并行,但受限于内存带宽而非计算峰值
- GPU加速有限:稀疏线性系统求解的GPU加速比通常只有2-5倍(相比稠密矩阵的10-50倍)
代表软件:
- FEniCS、deal.II(有限元框架)
- Hypre、PETSc(并行线性代数库)
- 清华薛巍教授团队的StructMG(结构化代数多重网格)
2. PINN:物理约束下的”梯度下降苦战”
物理信息神经网络(Physics-Informed Neural Networks, PINN)由Raissi等人于2019年提出,核心思想是用神经网络直接近似PDE的解,并通过自动微分(AD)计算PDE残差作为损失函数的一部分。
损失函数组成:L=LPDE+LBC+LIC+Ldata
- PDE残差损失:神经网络解代入PDE方程后的残差
- 边界条件损失:Dirichlet/Neumann边界条件的满足程度
- 初始条件损失:初始时刻的符合度
- 数据损失:与观测数据的匹配(如果有)
计算瓶颈:
- 高阶导数计算:通过自动微分计算二阶、四阶导数,计算量是前向传播的数倍
- 配点采样:需要在时空域内采样大量配点(collocation points),通常数万到数百万
- 训练不稳定:PDE残差损失和边界条件损失的量级可能相差数个数量级,需要精细的权重调参
硬件需求特点:
- GPU是刚需:神经网络的训练天然适合GPU,尤其是高阶导数计算的并行化
- 显存决定batch size:配点数量受限于显存容量,大显存GPU(48GB+)可以处理更大规模的PDE
- 混合精度训练:FP16/FP32混合精度可以加速训练,但需要小心数值稳定性
行业痛点:
- 高频模式难以学习:PINN倾向于先学习低频模式,高频振荡需要极长的训练时间
- 刚性问题:对流占优或刚性源项的PDE,PINN收敛极慢甚至失败
- 无法泛化到新参数:对于每个新的边界条件或材料参数,都需要重新训练
3. 神经算子:从”求解一个问题”到”学习一个算子”
神经算子(Neural Operators)是2020年后兴起的新范式,目标是学习从输入函数空间(如边界条件、源项)到输出函数空间(PDE解)的映射。G:a(x)↦u(x)
一旦训练完成,对于同一类PDE的不同参数配置,无需重新训练即可快速推理。
主要架构:
- DeepONet(2021):基于通用算子近似定理,分支网络(Branch)编码输入函数,主干网络(Trunk)编码空间坐标
- FNO(傅里叶神经算子,2021):在傅里叶频域进行卷积,具有分辨率无关性(超分辨率能力)
- MgNO(多重网格神经算子,2024,清华何俊材团队):将多重网格结构引入神经算子,高效参数化线性算子
计算瓶颈:
- 数据生成成本:需要大量传统数值模拟数据(FEM/FDM)作为训练集
- 训练算力需求:神经算子参数量通常数千万到数亿,训练需要多GPU并行
- 分辨率泛化:FNO虽然在理论上分辨率无关,但实际中低频模式学习较好,高频细节可能丢失
硬件需求特点:
- 大显存GPU集群:训练神经算子通常需要4-8张A100/H100,显存80GB+
- 高速互联:多GPU训练需要NVLink或InfiniBand保证通信带宽
- 存储需求:训练数据集(大量FEM模拟结果)可能达到TB级
三、前沿技术:2024-2025年AI求解PDE的三大突破
突破1:MgNO——清华团队的”数学驱动”神经算子
2024年,何俊材团队(当时还在KAUST,现已加入清华)在ICLR发表了MgNO(Multigrid Neural Operator),开创性地将数值PDE中的多重网格结构引入神经算子。
核心创新:
- 层级化参数化:在不同分辨率层级上参数化线性算子,模拟多重网格的V-cycle/W-cycle
- 高效性:仅用2.1百万参数就能学习复杂波场映射,参数量仅为FNO的1/10
- 数学可解释性:网络结构直接对应多重网格算法,不是纯粹的黑箱
硬件启示:
- MgNO的层级结构适合多GPU并行,不同层级可以分布式计算
- 相比FNO的全局傅里叶变换,MgNO的局部计算更内存友好
突破2:PI-DeepONet——物理信息+算子学习的融合
传统DeepONet是纯数据驱动的,需要大量训练数据。2024年兴起的PI-DeepONet(Physics-Informed DeepONet)将物理约束引入算子学习。
核心思想:
- 分支网络输入边界条件/源项参数
- 主干网络输入空间坐标
- 新增物理损失:在训练时施加PDE残差约束,减少对数据的依赖
优势:
- 训练数据量减少50-80%
- 泛化能力显著提升
- 适合数据稀缺但物理方程已知的场景
突破3:DIMON——微分同胚映射算子学习
2024年发表的DIMON(Diffeomorphic Mapping Operator Learning)由约翰霍普金斯大学尹明朗(Minglang Yin,第一作者)等提出,通讯作者为Natalia Trayanova教授。该模型能够在普通个人电脑上比超级计算机更快地求解复杂PDE。
核心能力:
- 从单个已求解的形状学习模式
- 将解映射到多个新形状上,避免重复网格划分
- 适用于医疗(心律失常预测)、航空航天、材料科学等领域
硬件启示:
- 推理阶段消费级GPU即可,无需超算
- 训练阶段仍需工作站,但一次训练多次推理的经济性极高
四、行业痛点:AI求解PDE的四大焦虑
痛点1:训练成本 vs 推理收益的”算账难题”
| 方法 | 训练成本 | 单次推理成本 | 适用场景 |
|---|---|---|---|
| 传统FEM | 无 | 高( hours-days) | 一次性问题 |
| PINN | 中( hours) | 低( seconds) | 参数扫描、实时推理 |
| 神经算子 | 高( days-weeks) | 极低( milliseconds) | 大量参数组合、实时预测 |
关键决策:如果只需要求解10个不同参数的PDE,传统FEM更划算;如果需要求解10000个,神经算子的训练成本就被摊薄了。
痛点2:高频模式的”学习盲区”
无论是PINN还是FNO,高频振荡模式都是学习难点。
- PINN:梯度下降天然偏好低频解,高频模式需要特殊的采样策略或 Fourier特征嵌入
- FNO:频域截断(mode truncation)会丢失高频信息
- 解决方案:混合方法——低频用神经算子,高频用传统Galerkin方法
痛点3:泛化能力的”信任危机”
神经算子训练完成后,对于训练分布外的参数是否还能准确预测?
- OOD泛化(Out-of-Distribution):材料参数、几何形状超出训练范围时,误差可能急剧增大
- 不确定性量化:需要额外的贝叶斯神经网络或集成学习来估计预测置信度
- 清华方案:何俊材团队正在研究结合物理约束的泛化理论
痛点4:软件生态的”碎片化”
| 类型 | 代表工具 | 问题 |
|---|---|---|
| PINN框架 | DeepXDE、NeuroDiffEq、SimNet | API不统一,学习曲线陡峭 |
| 神经算子 | FNO官方实现、MgNO(清华) | 多为研究代码,工程化程度低 |
| 传统FEM | FEniCS、deal.II | 与AI框架(PyTorch/JAX)整合困难 |
五、硬件配置分级:从PINN调参到神经算子训练的四级跃迁
Level 1:入门型——PINN学习与中小规模推理
定位:学习PINN原理、小规模PDE(1D/2D泊松方程)、课程作业
核心配置:
| 配件 | 推荐规格 | 说明 |
|---|---|---|
| CPU | AMD Ryzen 9 9950X (16核32线程) | 单核性能强,适合调参迭代 |
| 内存 | 64GB DDR5-5600 | 中小规模PDE够用 |
| 显卡 | RTX 4080 SUPER 16GB | 16GB显存可处理中等规模PINN |
| 存储 | 2TB NVMe SSD | 数据集和模型存储 |
避坑提示:
- 别买非ECC内存,长时间训练可能bit翻转
- PINN训练对显存需求不如大语言模型夸张,16GB足够入门
Level 2:进阶级——大规模PINN与神经算子预研
定位:3D PINN、小规模神经算子训练(百万参数级)、科研验证
核心配置:
| 配件 | 推荐规格 | 说明 |
|---|---|---|
| CPU | AMD Threadripper 7970X (32核64线程) | 数据预处理并行化 |
| 内存 | 256GB DDR5-4800 ECC REG | 大规模配点采样需要大内存 |
| 显卡 | RTX Pro 6000 Blackwell 96GB | 96GB显存可训练中型神经算子 |
| 存储 | 4TB NVMe SSD (企业级) + 16TB HDD | 训练数据集存储刚需 |
避坑提示:
- RTX Pro 6000 Blackwell的GDDR7带宽对FNO的FFT运算提升明显
- 神经算子训练需要保存大量检查点(checkpoint),SSD容量要充足
Level 3:专家级——神经算子训练与多物理场耦合
定位:千万参数级神经算子(FNO/MgNO)、多GPU并行训练、服务课题组
核心配置:
| 配件 | 推荐规格 | 说明 |
|---|---|---|
| CPU | 双路 AMD EPYC 9575F (2×64核128线程) | 数据并行加载预处理 |
| 内存 | 512GB DDR5-4800 ECC REG | 多GPU训练时需要大内存缓冲 |
| 显卡 | 2× RTX Pro 6000 Blackwell NVLink | 双卡192GB显存池化 |
| 存储 | 8TB NVMe SSD (U.2企业级) + 40TB HDD | 海量训练数据 |
| 网络 | 25GbE 以太网 | 连接超算或数据中心 |
避坑提示:
- NVLink桥接器必须买原厂,第三方兼容性差
- 多GPU训练神经算子时,显存容量比CUDA核心数更重要
Level 4:集群级——基础模型训练与数字孪生
定位:超大规模神经算子(亿级参数)、多物理场基础模型、实时推理服务
核心配置:
| 节点类型 | 配置要点 | |
|---|---|---|
| 训练节点 | 8× H100 80GB NVLink全互联 + 双路 EPYC 9575F (2×64核128线程) | 高主频Zen 5架构,适合数据并行加载和参数更新 |
| 推理节点 | 4× RTX Pro 6000 Blackwell + 高速网络 | |
| 存储节点 | 100TB+ Lustre并行文件系统 | |
| 网络 | 200GbE InfiniBand NDR |
软件栈:
- 分布式训练:PyTorch DDP / DeepSpeed / FSDP
- 模型部署:TensorRT / ONNX Runtime
- 工作流:Kubernetes + Kubeflow
六、避坑指南:AI求解PDE的五大陷阱
陷阱1:盲目追求大模型,忽视数据生成成本
误区:”神经算子参数越多越好”
现实:
- 训练数据需要传统FEM/FDM生成,成本极高
- 一个千万参数的FNO可能需要10万张FEM模拟图像作为训练集
- MgNO的优势:2.1百万参数就能达到SOTA,数据需求降低一个数量级
建议:先从小模型(MgNO、小型FNO)开始,验证可行性后再扩大规模。
陷阱2:忽视PINN的训练不稳定性
误区:”PINN是黑箱,丢进去就能学”
现实:
- PDE残差损失和边界条件损失的量级可能相差10⁶倍
- 高频模式可能完全学不到
- 刚性问题(如对流占优)收敛极慢
建议:
- 使用自适应权重策略(如NTK权重、梯度统计平衡)
- 对于高频问题,先用传统FEM生成粗解作为初始猜测
陷阱3:混淆”分辨率无关”与”精度保证”
误区:”FNO说分辨率无关,所以任何分辨率都能用”
现实:
- FNO的”分辨率无关”是指可以从粗网格训练,推理时细网格
- 但高频模式(超出训练时的最高频)无法准确预测
- 超分辨率有上限,通常是2-4倍
建议:训练时的分辨率应覆盖问题的主要频谱成分。
陷阱4:忽视OOD泛化风险
误区:”训练好的神经算子可以泛化到任意参数”
现实:
- 训练集外的材料参数、几何形状可能导致灾难性误差
- 缺乏不确定性量化机制时,无法判断预测是否可信
建议:
- 使用集成学习或贝叶斯神经网络估计预测方差
- 对于关键应用,神经算子结果应与传统FEM交叉验证
陷阱5:软件栈选型失误
误区:”PyTorch搞定一切”
现实:
- 科学计算需要几何建模→网格生成→PDE求解→后处理的完整 pipeline
- 纯PyTorch缺乏有限元网格处理能力
- 传统FEM软件(FEniCS)与PyTorch整合需要额外工作
建议:
- 使用DeepXDE(科研)或NVIDIA Modulus(工程)等集成框架
- 对于复杂几何,先用FEniCS/deal.II生成训练数据,再用PyTorch训练神经算子
七、写在最后:AI不会取代传统方法,但会改变工作流
在AI for Science的浪潮下,PDE求解的范式正在发生微妙但深刻的变化。
传统工作流:
问题定义 → 几何建模 → 网格划分 → FEM求解 → 后处理 → (每个新参数重复)
AI增强工作流:
问题定义 → 生成训练数据(FEM批量计算) → 训练神经算子 → 实时推理/参数扫描
正如清华大学何俊材团队的研究所示:从数学角度理解神经网络(如MgNet将CNN与多重网格统一),比纯粹的黑箱调参更能带来实质性突破。
硬件投资的原则:
- 明确使用场景:参数扫描用神经算子,一次性问题用传统FEM
- 显存 > 算力:神经算子训练受限于显存容量,而非CUDA核心数
- 数据预算 ≥ 算力预算:生成高质量训练数据可能比买显卡更烧钱
- 软件先行:先确定用DeepXDE、Modulus还是自研框架,再定硬件
最后,引用何俊材在ICLR 2024论文中的一句话:
“神经算子是否能带来科学计算的新范式?答案是肯定的,但前提是我们要从数学原理出发,而不是盲目堆砌算力。”
在AI for Science的时代,数学直觉比硬件配置更能决定研究成败。
文章关键词:PINN、神经算子、DeepONet、FNO、MgNO、物理信息神经网络、AI for Science、科学计算、有限元、多重网格、何俊材、清华丘成桐数学科学中心
相关阅读推荐:
- He et al., ICLR 2024, MgNO: Efficient Parameterization of Linear Operators via Multigrid
- Li et al., ICLR 2021, Fourier Neural Operator for Parametric Partial Differential Equations
- 2024研究前沿报告:物理引导神经网络在偏微分方程求解中的方法与应用












