
本文采用技术分析视角,以清华大学计算地球物理研究为参照系探讨行业趋势。文中提及的学术成果均来自公开文献,不代表任何官方立场。硬件配置建议仅供参考。
一、写在前面:当地震波遇上”并行墙”
2017年,由清华大学、北京师范大学与山东大学组成的联合研究团队,基于”神威·太湖之光”超级计算机,实现了千万核规模下25公里分辨率的全球气候模式模拟——这是当年戈登·贝尔奖(Gordon Bell Prize)的入围项目。而在地球物理学的另一分支——地震波传播模拟领域,同样面临着算法与硬件的双重挑战。
在清华大学数学科学系,杨顶辉教授团队长期致力于计算地球物理学研究。作为国家杰出青年基金(2007)获得者,杨教授发表论文151篇,在地震波传播正反演、储层波传播理论、地震成像等方面取得了系统性创新成果。他担任中国地球物理学会”地震波传播与成像”专题召集人,推动着我国地震波数值模拟方法的发展。
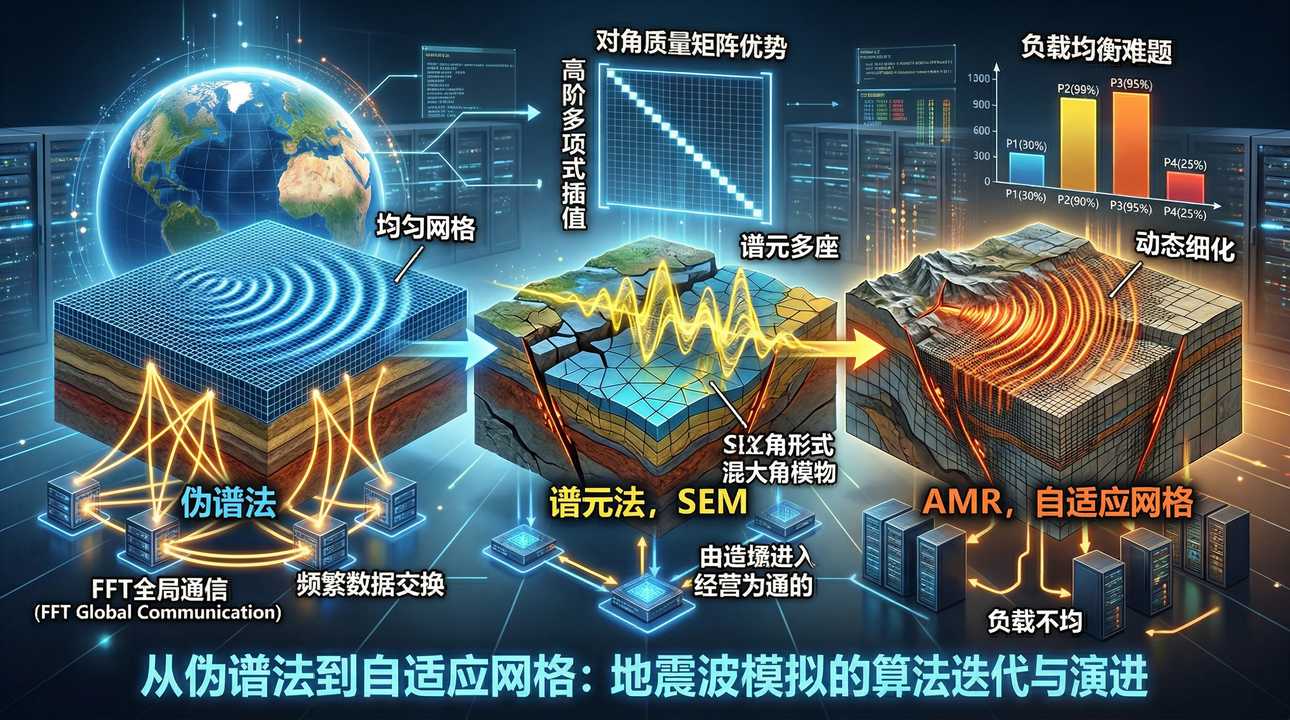
从伪谱法的FFT全局通信,到谱元法的对角质量矩阵优势,再到自适应网格的负载均衡难题——地震波传播模拟正在经历一场静默的算法革命。本文从算法本质、前沿技术、行业痛点三个维度,聊聊地震波模拟的演进与硬件配置逻辑。
二、算法本质:四大数值方法的精度-效率权衡
1. 有限差分法(FDM):工程应用的”务实之选”
核心思想:在离散网格点上用差分近似微分,将波动方程转化为代数方程组。
交错网格技术:
- 速度分量定义在网格边中点
- 应力分量定义在网格面心或体心
- 时间积分通常采用二阶或四阶中心差分
计算特性:
| 特性 | 描述 |
|---|---|
| 局部性 | 每个格点的计算只依赖邻居(stencil计算) |
| 稀疏矩阵 | 线性系统稀疏,适合迭代求解 |
| 内存需求 | 相对较低,N个格点约需O(N)内存 |
| 并行性 | 优秀,适合大规模CPU集群 |
精度与阶数:
- 高阶FDM(16阶或更高)对最短波长的三个网格样本,网格色散误差可小于1%
- 但高阶差分算子长度增加,计算量和通信开销也随之增加
清华实践:
- 杨顶辉教授团队在非常规油气储层介质波传播模型研究中,发展了基于非达西流的波传播模型
- 有限厚度震源模型:清华研究团队提出,针对近场大地震(断层达数十至数百公里),能准确生成符合实际的宽频带地震动
2. 伪谱法(PSM):精度与效率的”双刃剑”
核心思想:利用快速傅里叶变换(FFT)在波数域进行微分,将物理域的求导转化为波数域的乘法。
数学表达:∂x∂f=F−1{ik⋅F{f}}
其中 F 表示FFT,k 是波数。
优势:
- 指数精度:空间微分精度理论上无限高(受限于浮点精度)
- 粗网格可用:相比FDM,可用更粗的网格达到相同精度
- 内存节省:网格点数可大幅减少(约为高阶FDM的1/4~1/9)
致命弱点:
- 全局通信:FFT需要全局数据交换(All-to-all通信)
- 并行瓶颈:分布式内存系统上并行效率受限
- 复杂介质:对强非均匀介质的处理能力有限
硬件适配:
- 适合共享内存系统(单节点多核)
- 需要高内存带宽(数据重排密集)
- 分布式集群上需采用混合策略(如PSM/FDM混合方法)
清华相关研究:
- 中国地震局地震预测研究所、北京大学等发展了伪谱/有限差分混合方法:水平方向用PSM,垂直方向用FDM
- 利用FDM的局部性实现垂直方向并行分解,保留PSM的高精度优势
3. 谱元法(SEM):”鱼和熊掌兼得”
核心思想:将计算域划分为若干单元,每个单元内使用谱方法(高阶多项式)。
勒让德谱元法(Legendre SEM):
- 插值点和积分点采用Gauss-Lobatto-Legendre(GLL)分布
- 质量矩阵为对角矩阵(集中质量),无需求解线性方程组
- 显式时间积分(如Leapfrog、Newmark)即可推进
计算特性对比:
| 特性 | 有限差分 | 伪谱法 | 谱元法 |
|---|---|---|---|
| 精度 | 代数收敛 | 指数收敛 | 谱收敛(单元内) |
| 质量矩阵 | 对角(集中质量) | N/A | 对角(GLL积分) |
| 通信 | 局部(stencil) | 全局(All-to-all) | 单元间边界交换 |
| 并行性 | 优秀 | 受限 | 优秀 |
| 复杂几何 | 一般 | 差 | 优秀(非结构网格) |
SPECFEM3D:
- 基于勒让德谱元法的地震波模拟开源软件
- 2003年获得戈登·贝尔奖(全球超算应用最高奖)
- 2013年在Blue Waters超级计算机上达到持续千万亿次浮点运算性能
- 支持全球尺度地震波传播模拟(如2011年日本东北地震)
清华实践:
- 基于PHG平台(中科院数学与系统科学研究院科学与工程计算国家重点实验室张林波研究员主持研制的并行自适应有限元平台),开发了区域尺度地震波并行谱元PML求解器
- 采用六面体非结构网格和谱元格式求解地震波PML方程
- 单元刚度矩阵分解策略显著降低存储量和计算量
- 支持MPI+OpenMP混合并行,可扩展到98304个CPU核(并行效率98.01%)
4. 自适应网格细化(AMR):”哪里需要密,哪里就加密”
核心思想:根据解的局部特征(如梯度、误差估计)动态调整网格密度。
地震波模拟中的AMR挑战:
- 波前追踪:地震波传播具有明确的波前,需要在波前附近加密
- 高频衰减:高频成分衰减快,近场需要更密的网格
- 复杂地形:盆地边缘、断层附近需要局部加密
实现策略:
- h-细化:将粗单元细分为多个子单元
- p-细化:在单元内增加多项式阶数
- r-细化:重新分布网格节点(移动网格)
并行负载均衡难题:
- 自适应细化后,各处理器负载可能严重不均
- 需要动态域分解和负载重平衡
- 网格重分区的通信开销可能抵消计算收益
清华相关研究:
- PHG平台支持自适应有限元,具有动态负载均衡能力
- 在地震波谱元求解器中,通过网格预划分和动态调整,实现大规模并行效率
三、前沿技术:全波形反演(FWI)的”算力黑洞”
1. 从正演到反演:问题复杂度跃迁
全波形反演(FWI):通过最小化观测数据与模拟数据的差异,反演地下介质参数(速度、密度、各向异性等)。
数学框架:χ(m)=21r∑∫0T∥u(m;xr,t)−dobs(xr,t)∥2dt
其中 m 是模型参数,u 是模拟波场,dobs 是观测数据。
计算流程:
- 给定初始模型 m0
- 正演计算:求解波动方程得到 u(m;xr,t)
- 计算残差:δd=u−dobs
- 伴随传播:将残差作为震源反向传播
- 梯度计算:正演波场与伴随波场零延迟互相关
- 模型更新:mk+1=mk−αk∇χ
- 重复步骤2-6直到收敛
2. 伴随方法:梯度计算的”时空逆转”
核心思想:利用伴随状态法(Adjoint State Method),通过一次正向传播和一次反向传播计算梯度,避免直接计算Jacobian矩阵。
梯度公式:∇χ=−sources∑∫0Tu˙(t)⋅u˙†(t)dt
其中 u 是正向波场,u† 是伴随波场。
内存灾难:
- 梯度计算需要同时使用正向波场和伴随波场
- 正向波场沿时间正向传播,伴随波场沿时间反向传播
- 简单存储全部正向波场:Ngrid×Ntime×8 字节
- 典型三维问题:10亿网格点 × 10000时间步 × 8字节 = 80TB内存!
3. 检查点策略:内存与计算的三方博弈
解决思路:在正演过程中保存部分中间状态(检查点),反向传播时从检查点重新计算所需波场。
策略对比:
| 策略 | 内存需求 | 额外计算量 | 实现复杂度 |
|---|---|---|---|
| 全存储 | 极高(80TB+) | 无 | 低 |
| 检查点法 | 中等 | 50%-100% | 中 |
| 有效边界法 | 较低 | 20%-50% | 高 |
| 随机边界法 | 极低 | 0% | 低 |
最优检查点(Optimal Checkpointing):
- 通过动态规划确定检查点最佳分布
- 在给定内存限制下,最小化重计算量
- Revolve算法:经典的最优检查点调度算法
有损压缩检查点(2020年研究进展):
- 将检查点数据用ZFP等算法进行有损压缩
- 压缩比可达100:1,对收敛率和最终解质量影响较小
- 在80TB内存需求的FWI问题中,可将存储需求降至800GB
4. GPU加速:异构计算的”双刃剑”
GPU优势:
- 高内存带宽(H100:3TB/s vs EPYC 400GB/s)
- 大规模并行(数千CUDA核心)
- 适合显式时间积分的逐元素计算
GPU限制:
- 显存容量有限(H100 80GB vs 服务器TB级内存)
- 需要 careful 的内存管理
- 检查点策略更加重要
实现策略:
- 随机边界法:仅需保存最后两个时刻的波场,适合GPU显存
- 有效边界法:存储边界波场,GPU实现需优化内存访问模式
- 混合CPU/GPU:CPU负责粗粒度并行,GPU负责细粒度计算
四、行业痛点:地震波模拟的五大”拦路虎”
痛点1:CFL条件的”紧箍咒”
稳定性限制:
- 显式时间积分要求:Δt≤vmax⋅CFLΔx
- 对于地震波(vmax = 8-10 km/s),1km分辨率需要Δt < 0.1秒
- 模拟100秒地震动需要1000+时间步
分辨率与时间的矛盾:
- 高频成分需要更密的网格和更小的时间步
- 宽频带地震动(0.1-10Hz)模拟,高频部分是计算瓶颈
缓解策略:
- 局部时间步长:不同区域采用不同时间步长
- 隐式-显式混合:低速区域用隐式,高速区域用显式
- 子循环:高频成分在局部区域子循环推进
痛点2:并行扩展的”天花板”
强扩展限制:
- 有限差分:受stencil宽度限制,单分区不能太小
- 谱元法:单元间边界通信开销随分区数增加
- 伪谱法:FFT的全局通信限制扩展性
负载均衡难题:
- 自适应网格导致负载不均
- 复杂地形(盆地、断层)需要局部加密
- 动态负载重平衡开销可能抵消收益
清华经验:
- PHG平台的谱元求解器通过网格预划分和动态调整,在98304核上保持98%并行效率
- 关键在于最小化通信量和计算/通信重叠
痛点3:全波形反演的”非线性地狱”
局部极小值:
- FWI目标函数高度非凸,存在大量局部极小值
- 初始模型稍有偏差,可能收敛到错误解
- 低频到高频的多尺度策略:先用低频数据构建大尺度结构,再逐步加入高频
振幅拟合 vs 走时拟合:
- 早期FWI直接拟合波形振幅,对噪声敏感
- 当前趋势:结合走时信息和波形信息
- Wasserstein距离(最优输运):新的目标函数,凸性更好
痛点4:吸收边界条件的”反射幽灵”
问题本质:
- 有限计算域需要截断,但截断边界会产生人工反射
- 吸收边界条件(ABC)或完全匹配层(PML)必须有效吸收 outgoing waves
PML挑战:
- 标准PML对倏逝波和低频波吸收效果差
- 大角度入射时反射增加
- CFS-PML(卷积型):改进版本,但计算量增加
清华实践:
- PHG平台的谱元求解器实现了高效的PML边界条件
- 通过优化数值积分格式,保证长时间积分的稳定性
痛点5:软件生态的”碎片化”
代码多样性:
- 有限差分:AWP-ODC、SW4、FD3D
- 谱元法:SPECFEM3D、GAMERA、SPEED、SeisSol
- 自适应:p4est、AMROC、PHG
互操作性差:
- 不同代码的网格格式、输入输出不兼容
- 从正演到反演的工作流整合困难
- 可视化工具分散(Paraview、Visit、MATLAB等)
五、硬件配置分级:从教学演示到千万核集群的四级跃迁
Level 1:教学演示级——个人工作站
定位:地震波传播入门学习、理想化模型测试、算法验证
核心配置:
| 配件 | 推荐规格 | 说明 |
|---|---|---|
| CPU | AMD Threadripper 7970X (32核64线程) | 单节点并行 |
| 内存 | 128GB DDR5-4800 ECC | 中等规模2D问题 |
| 存储 | 2TB NVMe SSD | 源代码、小规模数据 |
| 显卡 | RTX 4090 24GB | SPECFEM3D GPU版本 |
| 网络 | 单机无需 | — |
可运行案例:
- 2D地震波传播,1000×1000网格,1000时间步
- 3D小尺度模型(100×100×100),频带0-2Hz
- SPECFEM3D tutorials(全球模型粗网格)
Level 2:科研进阶级——小型服务器
定位:区域地震动模拟、FWI预研、方法开发
核心配置:
| 配件 | 推荐规格 | 说明 |
|---|---|---|
| CPU | 双路 AMD EPYC 9655 (2×96核192线程) | 中等规模并行 |
| 内存 | 512GB DDR5-4800 ECC REG | 区域尺度模型 |
| 存储 | 8TB NVMe SSD + 50TB HDD | 快速IO+大容量 |
| 网络 | 25GbE 以太网 | MPI通信 |
| 加速卡 | 可选2× RTX Pro 6000 Blackwell | GPU加速FWI |
可运行案例:
- 北京/四川盆地区域(50×50×20 km),100m分辨率,0-5Hz
- 三维全波形反演(检查点策略),50×50×20网格
- SPECFEM3D区域模拟,多层速度模型
Level 3:专家级——部门级HPC集群
定位:城市尺度地震动预测、FWI生产运行、耦合模拟
核心配置:
| 组件 | 配置要点 |
|---|---|
| 计算节点 | 32-64节点,每节点2× EPYC 9655,512GB内存 |
| 存储系统 | 500TB Lustre/GPFS并行文件系统,100GB/s带宽 |
| 网络 | 100GbE InfiniBand HDR,全 fat-tree拓扑 |
| GPU节点 | 4-8× H100 80GB,用于FWI梯度计算 |
| 登录节点 | 大内存(2TB+),用于网格生成和预处理 |
可运行案例:
- 京津冀地区(200×200×50 km),50m分辨率,0-10Hz
- 全波形反演:1000×1000×500网格,20炮同时反演
- 自适应网格:盆地精细刻画+外围粗网格
Level 4:集群级——国家级超算中心
定位:大陆尺度地震波传播、全球地震学、多尺度耦合
核心配置(以神威·太湖之光为参照):
| 组件 | 配置要点 |
|---|---|
| 计算系统 | 百万核级国产众核处理器 |
| 峰值性能 | >100 PFlops |
| 内存 | >1 PB 分布式内存 |
| 存储 | 50PB+ 并行文件系统 |
| 网络 | 定制高速互连(如神威网) |
运行能力:
- 全球尺度地震波传播(如2011年日本地震)
- 全地幔对流+地震波传播耦合
- SPECFEM3D全球模拟,分钟-小时级周期
六、避坑指南:地震波模拟的五大陷阱
陷阱1:盲目追求高阶精度
误区:”阶数越高,结果越好”
现实:
- 高阶方法需要更密的网格才能达到稳定(CFL条件更严格)
- 16阶FDM的时间步长可能比8阶小一倍,总计算量增加
- 高阶方法对网格质量要求更高,扭曲网格可能降低实际精度
建议:
- 谱元法通常4-6阶即可,无需盲目追求高阶
- 有限差分8-12阶是性价比最佳区间
- 先用低阶方法验证模型,再逐步提高阶数
陷阱2:忽视网格质量
误区:”有网格就能跑”
现实:
- 谱元法对网格扭曲敏感,Jacobian矩阵条件数恶化
- 长宽比过大的单元会导致数值不稳定
- 复杂地形(盆地边缘)的网格生成是艺术也是技术
建议:
- 使用Trelis/Cubit等专业网格生成工具
- 检查网格质量指标(Jacobian、长宽比、扭曲度)
- 盆地边缘采用渐进加密,避免突变
陷阱3:FWI初始模型选择失误
误区:”随便给个初始模型就能反演”
现实:
- FWI高度非凸,初始模型错误可能导致收敛到局部极小
- 速度误差超过10%,高频成分可能完全错位
- 从高频开始的FWI几乎必然失败
建议:
- 先用走时层析或偏移速度分析构建大尺度初始模型
- 多尺度策略:从低频(长周期)开始,逐步加入高频
- 分阶段反演:先反演长波长结构,再优化短波长细节
陷阱4:检查点策略配置不当
误区:”检查点越多越好”
现实:
- 检查点过多:存储开销大,IO瓶颈
- 检查点过少:重计算量大,时间浪费
- 均匀分布检查点并非最优
建议:
- 使用Revolve等最优检查点算法
- 考虑有损压缩(ZFP等),压缩比10-100
- 在GPU上优先考虑随机边界法(存储最小)
陷阱5:忽视IO和存储规划
误区:”先跑起来,存储不够再加”
现实:
- 三维地震波场输出:1000×1000×1000网格 × 1000时间步 × 8字节 = 8TB
- FWI梯度计算可能产生数十TB中间数据
- 并行文件系统带宽有限,可能成为瓶颈
建议:
- 只输出必要的接收点数据,避免全波场输出
- 使用压缩(ZFP、SZ等),有损压缩通常可接受
- 分级存储:热数据SSD,温数据HDD,冷数据磁带
七、写在最后:地震波模拟的未来图景
地震波传播模拟正在经历从”方法驱动”到”问题驱动”的范式转变。
短期趋势(1-3年):
- 机器学习+物理模型:用神经网络替代部分物理计算,加速FWI
- 自适应网格普及:基于误差估计的动态加密成为标配
- 异构计算优化:CPU+GPU混合架构成为主流
中期趋势(3-10年):
- 实时地震模拟:地震发生后分钟级完成区域地震动预测
- 数字孪生地球:高分辨率(百米级)全球地震波传播模型
- 多物理场耦合:地震波-结构响应-次生灾害全链条模拟
长期愿景:
- 地震预测:从统计预测向物理预测转变
- 城市抗震规划:基于高保真模拟的精细化风险评估
- 行星地震学:火星、月球等行星内部结构探测
正如杨顶辉教授在青藏高原深部地球物理探测研究中所展现的,计算地球物理学的发展,离不开算法创新与硬件演进的协同推进。当伪谱法的精度、谱元法的并行性、自适应网格的灵活性融为一体,我们对地球内部的认识,也将进入一个新的时代。
文章关键词:地震波传播、伪谱法、谱元法、有限差分、自适应网格、全波形反演、FWI、伴随方法、检查点策略、SPECFEM3D、杨顶辉、清华大学、PHG平台、戈登·贝尔奖
相关阅读推荐:
- Komatitsch & Tromp (1999), GJI, Introduction to the spectral element method for three-dimensional seismic wave propagation
- Fichtner (2010), Full Seismic Waveform Modelling and Inversion
- 杨顶辉等,地球物理学报,非常规油气储层介质波传播模型
- PHG平台文档:地震波谱元PML求解器技术报告












