
一个专业 两样战场
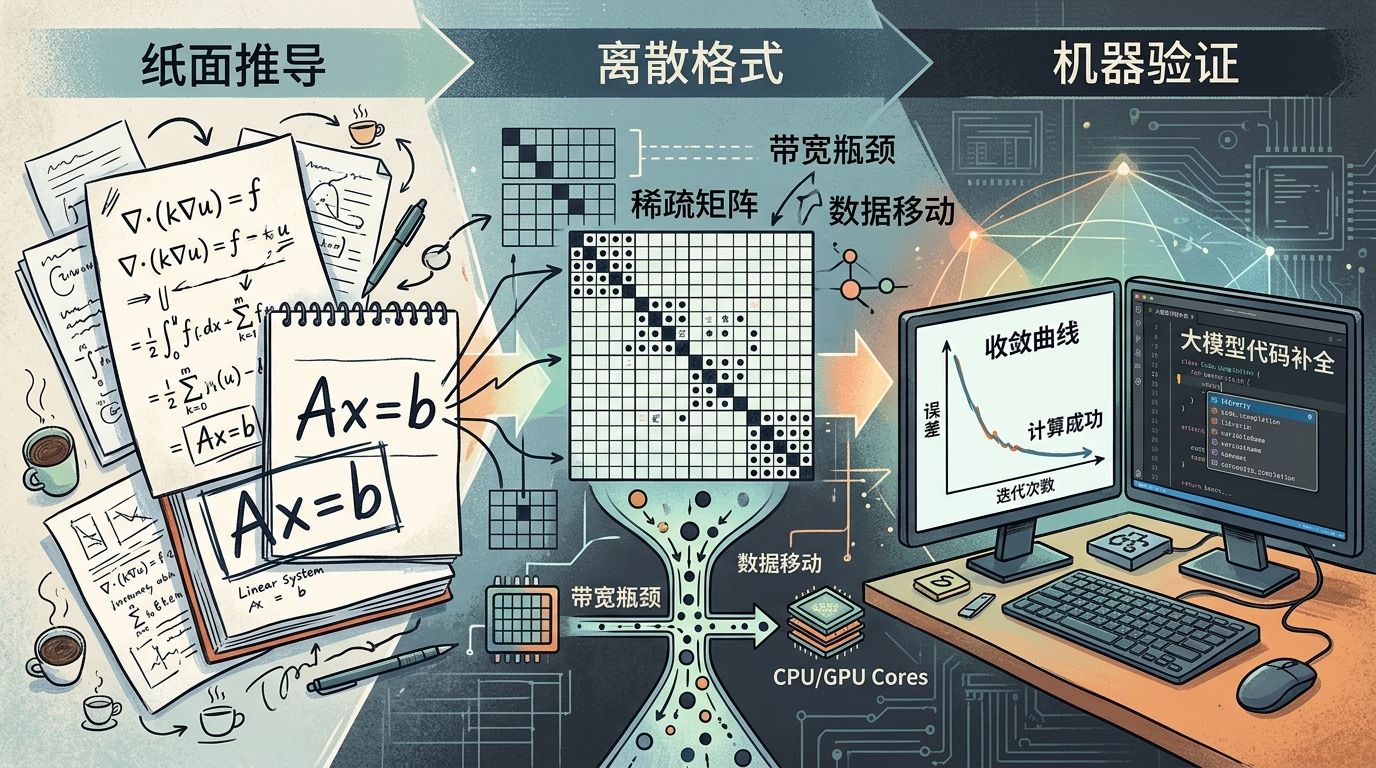
信息与计算科学是个有意思的专业:名字里带”信息”,根子上却是数学。学生前两年啃数学分析、高等代数,后两年扎进数值分析、数值线性代数、微分方程数值解,毕业设计往往是给一个实际物理问题建离散格式、写求解器、做收敛性分析。这个专业的日常,一半在纸面推导,一半在机器上验证——而验证这一步对硬件的挑剔程度,经常被低估。
华中科技大学数学与统计学院把这个方向铺得很开。学院始建于1953年,现有数学与应用数学、信息与计算科学、统计学三个本科专业,其中信息与计算科学是国家级一流本科专业建设点;科研平台上建有工程建模与科学计算湖北省重点实验室、湖北国家应用数学中心华中科技大学分中心。2026年,学院李海波副教授与合作者在国际期刊《SIAM Journal on Scientific Computing》发表文章,提出一种可扩展的迭代数据自适应RKHS正则化方法(iDARR),用于求解病态线性反问题——方法的核心思路,是在能够识别真实解的子空间里做迭代搜索,把原本难以承受的大规模反问题计算拆成可执行的步骤。这类工作有个共同点:推导走到终点,总要落到一个或一串大规模线性系统上,交给机器去解。
问题来了:解这个线性系统,需要一台什么样的机器?
核心算法 离散化之后 全靠解线性系统
科学与工程问题的数值求解,主流路线是离散化:把连续的微分方程、积分方程或反问题,在网格与采样点上离散成代数问题。有限差分、有限元、谱方法、配置方法,殊途同归,最后都汇到同一个地方——线性方程组 Ax=b。
规模有多大?三维问题用二阶精度格式离散,网格点数随分辨率三次方增长。百万自由度稀疏矩阵的非零元以千万计,直接法(LU分解)的填充元会让内存和运算量双双爆炸。所以大规模问题几乎一律走迭代路线:共轭梯度(CG)对付对称正定,GMRES、BiCGStab 对付非对称,再配上预处理(不完全LU、代数多重网格、区域分解)把条件数压下来。病态问题还要叠加正则化——Tikhonov、截断奇异值分解,或者像 iDARR 那样在再生核希尔伯特空间里做数据自适应的正则化迭代。
迭代法每轮迭代的主体是稀疏矩阵向量乘(SpMV)。SpMV 是典型的内存带宽受限操作:每个非零元只参与一次乘加,算术强度极低,计算单元大部分时间饿着,等数据从内存喂进来。这一条决定了数值算法工作站的第一性需求:先看内存带宽和内存容量,峰值算力反而排在后面。
计算特点与数据IO特征
把负载摊开看,有四组矛盾。
第一,单核与多核都要。稀疏矩阵组装、网格生成、前处理脚本,串行部分吃单核主频;并行 SpMV 与并行迭代吃核心数和内存通道数。一颗”核多但低频”或”高频但核少”的处理器,都会在某个环节卡住。
第二,内存容量决定能算多大规模。n 个自由度的双精度问题,矩阵按稀疏存储(CSR 格式,每个非零元一个双精度加一个列索引)就要数倍于 n 的字节,再叠加几个长度为 n 的临时向量。算到三百万自由度,64GB 内存只是地板。更隐蔽的是带宽:SpMV 的并行效率几乎随可用内存带宽线性走,双路 CPU 加八通道内存的价值就在这里。
第三,双精度是硬约束。数值算法要盯残差范数和收敛曲线,单精度累加误差会让”收敛”变成”假收敛”。这带来一个反直觉的结论:消费级显卡的游戏性能与数值计算基本无关——游戏卡的双精度吞吐被刻意限制在单精度的几百分之一,双精度代码的加速还得靠 CPU。显卡在这个专业里的正当用途,是跑大模型推理和科学计算可视化。
第四,IO 与并行环境。大规模算例的矩阵快照、收敛历史、后处理场数据动辄数十 GB;MPI 跨进程通信对内存子系统一致性和网络延迟敏感;多人共用时,作业调度与存储分层直接决定排队时间。
硬件配置分析 把瓶颈翻译成配置语言
把上面的特征翻译成采购语言:CPU 选核心多、主频不塌、内存通道多的平台,双路或高核数单路是常态;内存按”目标自由度规模的三倍”规划,宁多勿少,且必须 ECC——数值代码连续跑十几小时,一位软错误就能废掉整晚算例;存储分层,NVMe 扛热数据,SATA 大容量盘做归档;显卡按大模型需求配,下一节细算;散热与供电按满载长时运行设计,实验室夏天空调掉链子时,风道就是生命线。
常见误区也有三个:一看显卡跑分买机器,数值算法不吃这套;二把内存刚好卡在自由度规模上买,预处理和临时缓存一挤就 swap,求解时间翻十倍;三拿游戏本顶科研机,散热压不住持续满载,降频之后连纸面性能都保不住。
大模型本地部署 数值算法研究的副驾
数值方向对大模型的需求很实在:查文献、啃论文、写代码、改报错。为什么必须本地部署?一是课题组的未公开论文和研究数据不适合送进公有云对话框;二是文献问答与代码辅助属于全天候高频使用,API 账单拉长看并不便宜;三是数值实验常在内网环境进行,离线可用是硬门槛。
模型选型两个就够。Qwen3-14B 由阿里通义团队于2025年4月开源,约148亿参数的稠密模型,支持思考与非思考双模式,适合文献摘要、LaTeX 公式整理、MATLAB 与 Python 数值代码补全等高频任务。DeepSeek-R1-Distill-Qwen-32B 由深度求索于2025年1月开源,约320亿参数,基于 Qwen2.5 蒸馏,适合算法推导验证、报错链诊断、论文引言草拟等需要多步推理的任务。
显存账先算清:所需显存约等于参数量(B)乘量化字节数再乘1.2预留系数(覆盖 KV 缓存与系统开销),FP16 每参数2字节,Q8 为1字节,Q4 为0.5字节,Q4 下每10亿参数约0.6 GB。算例一:Qwen3-14B 的 Q4 量化约9 GB,16 GB 显存从容运行。算例二:DeepSeek-R1-Distill-Qwen-32B 的 Q4 量化约19到22 GB,24 GB 显存是起步线,上下文拉长或多人并发还要留余量。
量化等级这样选:FP16 几乎无损但显存翻倍,Q8 损失约一到三个百分点,Q4 损失五到十个百分点、体积只有 FP16 的四分之一,是消费级显卡的默认选项,日常辅助足够,关键推导再切高精度复核。
速度要有预期:纯 CPU 内存推理通常只有个位数 tokens/s,问一句要等几十秒;单卡 GPU 推理能到几十到上百 tokens/s,啃一篇论文几分钟出摘要,这才是工作站相对普通电脑的真正价值。
推理之外是微调的分水岭:用 LoRA 对14B模型做数值领域适配,显存增量约3到5 GB,前面算的显存余量足以覆盖;全参数微调哪怕7B模型也要80 GB 以上显存。想清楚”只推理”还是”推理加微调”,档位边界就清楚了。
软件清单
操作系统用 Ubuntu Server 或 openEuler,配好离线源。编译器选 GCC 或 Intel oneAPI,数值库用 Intel MKL 或 OpenBLAS——BLAS/LAPACK 是线性代数求解的发动机。并行环境装 OpenMPI 或 MPICH;迭代求解器库首选 PETSc(配 hypre 做预处理)与 Trilinos,特征值问题用 SLEPc;有限元框架 deal.II、FEniCS 二选一,网格划分用 Gmsh,后处理可视化用 ParaView。原型验证离不开 MATLAB 与 Julia,Python 侧的 NumPy、SciPy 负责胶水脚本和快速画图。大模型服务用 vLLM 或 SGLang 对外提供 OpenAI 兼容接口,轻量验证可用 Ollama。全部环境容器化管理,代码进 Git,数据用 HDF5 归档。授权方面,MATLAB 与商业求解器按课题组正版口径提前规划。
UltraLAB配置怎么选
高校买设备跟企业不一样:钱要走采购流程、过资产验收,机器得撑过几届学生的毕业周期。信息与计算科学方向的负载又有自己的脾气——数值求解吃内存带宽与容量,大模型部署吃显存,两条线叠加,”均衡”比”偏科”重要。前面把迭代求解的硬件账和大模型的显存账都算清了,下面按负载规模给四个参考档位,都是报价表里的实际机型,下单前可按课题组的目标自由度规模和并发人数微调内存与存储容量。
方案A:入门学习与课程科研档
适用场景:本科毕设与课程级数值实验,十万到百万自由度规模的稀疏线性求解,Qwen3-14B 级模型本地推理与文献问答。
| 硬件类别 | 具体配置 | 说明 |
|---|---|---|
| CPU | Intel Core Ultra 7 265K 20核(8性能核全核5.3GHz/12能效核全核3.8GHz) | 20核混合架构兼顾串行前处理脚本与并行 SpMV,高主频保证网格生成与预处理构造不拖后腿 |
| GPU | RTX 5090D v2 24G 水冷 | 24G 显存覆盖 Qwen3-14B Q4 量化与文献问答,水冷压住长时间推理负载 |
| 内存 | 64GB DDR5 | 百万自由度稀疏求解的起步容量,课程级算例的矩阵与临时向量周转够用 |
| 存储 | 2TB NVMe | 系统、求解器环境与热数据同盘高速读写,矩阵快照落盘不卡顿 |
| 显存 | 24G | Qwen3-14B Q4 约9GB,余量覆盖 KV 缓存与多人轻量并发 |
| 显存带宽 | 1.3TB/s | 单卡推理吞吐的保障,决定文献摘要与代码补全的响应速度 |
推荐机型:A350 15364-MBT
硬件解析:这档是”课程学习加轻量科研”的入门定位——CPU 主频优先于核心数,对应预处理与串行段的单核刚需;64GB 内存卡在百万自由度的地板线上,属于够用而非宽裕;RTX 5090D v2 的 24G 显存恰好吃下 14B 级模型 Q4 推理,与本档负载严丝合缝,花出去的每一分钱都落在真实瓶颈上。
方案B:进阶课题与推理增强档
适用场景:硕士课题与大规模算例,百万到千万自由度迭代求解,DeepSeek-R1-Distill-Qwen-32B 级推理模型常驻,兼顾 LoRA 领域微调。
| 硬件类别 | 具体配置 | 说明 |
|---|---|---|
| CPU | AMD锐龙9950X3D (16核, 4.8~5.7GHz) +水冷 | 3D 大缓存对 SpMV 的随机内存访问友好,高主频兼顾预处理构造的单核需求 |
| GPU | RTX 4090 48G+水冷 | 48G 显存让 32B 级模型 Q4 常驻并留足上下文与 LoRA 微调余量 |
| 内存 | 192GB DDR5 | 千万自由度迭代求解的容量保障,预处理矩阵与 Krylov 子空间向量不再挤占 swap |
| 存储 | 4TB NVME + 8TB SATA | NVMe 扛活跃算例热数据,SATA 归档收敛历史与后处理场数据 |
| 显存 | 48 GB | DeepSeek-R1-Distill-Qwen-32B Q4 约19到22GB,余量覆盖 KV 缓存与微调增量 |
| 显存带宽 | 1.01 TB/s | 保障 32B 模型推理与结果可视化的并发流畅度 |
推荐机型:AR350 148192-MCT
硬件解析:这档把”推理增强”做实了——48G 显存是前文显存账里 32B 模型 Q4 档的起步线再加余量,LoRA 微调的 3 到 5GB 增量也吃得住;9950X3D 的 3D 大缓存恰好对冲 SpMV 的随机访存特征,是数值负载里少见的消费级技术反哺科研的案例;192GB 内存则把自由度的天花板从百万级抬到千万级。
方案C:课题组共享与专家计算档
适用场景:课题组多人共用平台,超大规模数值模拟与蒙特卡洛类计算,大模型多任务并发与知识库服务,需要超大内存和超大缓存的 CPU 支撑带宽受限负载。
| 硬件类别 | 具体配置 | 说明 |
|---|---|---|
| CPU | 2×AMD霄龙9684X (192核3.5GHz, 超大缓存) | 双路 192 核加超大缓存直接喂饱带宽受限的 SpMV 与蒙特卡洛并行,多人共用不缺核 |
| GPU | RTX 5090 32G+水冷 | 32G 显存支撑 32B 级模型 Q4 常驻,知识库服务与可视化共用一卡 |
| 内存 | 512GB DDR5 | 超大规模算例的矩阵、预处理因子与临时向量全驻内存,从根上杜绝 swap |
| 存储 | 系统盘 4TB NVME 数据盘 20TB SATA | 系统与求解器分离于 20TB 数据盘,多人归档互不抢 IO |
| 显存 | 32 GB | 32B 模型 Q4 常驻之外,还能并行跑结果可视化与轻量多任务 |
| 显存带宽 | 1.79 TB/s | 单卡推理与渲染的高带宽底座 |
| 性能指标 | CPU C10.7T | 双路平台的综合算力标尺,对应超大规模迭代的吞吐上限 |
推荐机型:AlphaPro660 234512-MDT
硬件解析:这是”带宽与容量双满配”的课题组共享方案——双路霄龙加超大缓存对 SpMV 随机访存的针对性极强,512GB 内存让超大规模算例全程驻留内存;192 核摊到多人并发,每人仍握有充足的内存通道份额;系统盘与数据盘分离,多人共用不互相踩踏 IO。从这档开始,瓶颈不再是硬件本身,而是作业调度与使用规范。
方案D:集群并行扩展档
适用场景:院系级公共计算平台,千万自由度以上的 MPI 并行数值模拟,多节点分布式求解与存储分离,支撑整个研究方向的多课题组并发使用。
| 硬件类别 | 具体配置 | 说明 |
|---|---|---|
| 计算节点·CPU | 2颗AMD霄龙9575F(128核4.5GHz) / Ultra9 285K(8核 5.6GHz) | 双路霄龙节点主攻 MPI 并行 SpMV,高主频节点适合串行前处理与调度 |
| 计算节点·GPU | RTX4090D / RTX A4000 | 推理节点与可视化节点按角色分工配卡 |
| 计算节点·内存 | 768GB DDR5 / 64GB DDR5 | 大内存节点驻留千万自由度以上矩阵,小内存节点承接轻量任务 |
| 计算节点·存储 | 2TB NVME / 2TB NVME | 每节点本地 NVMe 扛临时交换与 checkpoint |
| 计算节点·显存 | 24 GB / 16 GB | 24G 节点跑 32B 级推理,16G 节点跑 14B 与可视化 |
| 计算节点·显存带宽 | 1.01 TB/s / 448.0 GB/s | 对应两类节点的推理与渲染吞吐 |
| 存储管理节点·CPU | 2颗Xeon银牌 4310(24核) | 存储服务与作业调度的控制面,不抢占计算资源 |
| 存储管理节点·内存 | 192GB DDR4 | 并行存储的缓存与元数据驻留 |
| 存储管理节点·存储 | 126TB存储 | 全院共享的矩阵快照与场数据集中归档 |
推荐机型:UltraLAB 分布式集群方案 8.6(科学计算通用型)
硬件解析:这是从”买一台大机器”到”搭一套平台”的跃迁——计算节点按负载角色分成大内存并行节点与高主频轻量节点,显卡也随之分流;存储管理节点把 126TB 数据集中管理,MPI 跨节点求解不再被本地盘 IO 拖住。对院系级平台而言,节点堆料只是门票,真正的分水岭在节点间互联与作业调度。
常见问题
稀疏求解到底吃 CPU 还是吃内存
都吃,但瓶颈有先后顺序:先内存带宽,再内存容量,最后才是 CPU 核心数。SpMV 喂不饱数据时,加核无效;内存不够开始 swap 时,一切免谈。买机器先问内存通道数和容量上限,再问主频。
迭代法收敛慢甚至不收敛怎么办
八成是预处理没配好。先估条件数,再试不完全 LU 或代数多重网格;病态反问题叠加正则化参数扫描。注意预处理构造本身比迭代更吃内存和单核性能,别把这一步漏算进硬件规划。
游戏显卡能不能加速数值计算
基本不能。数值算法要双精度,消费级显卡的双精度吞吐只有单精度的几百分之一。显卡在这个方向的正当用途是跑大模型推理和结果可视化,指望它加速 SpMV 会失望。
大模型和数值计算抢一张卡怎么安排
错时使用。白天求解器独占 CPU,大模型跑轻量问答与代码补全;夜里批量参数扫描时,把大模型推理的显存配额压下来。显存48 GB 以上的机型可以让32B模型与中等规模可视化共存。
笔记本能撑到毕业吗
课程作业能,科研算例不能。散热降频、内存上限、没有 ECC,三条都踩在数值计算的命门上。真要做课题,从方案A起步,往后留给升级。











