
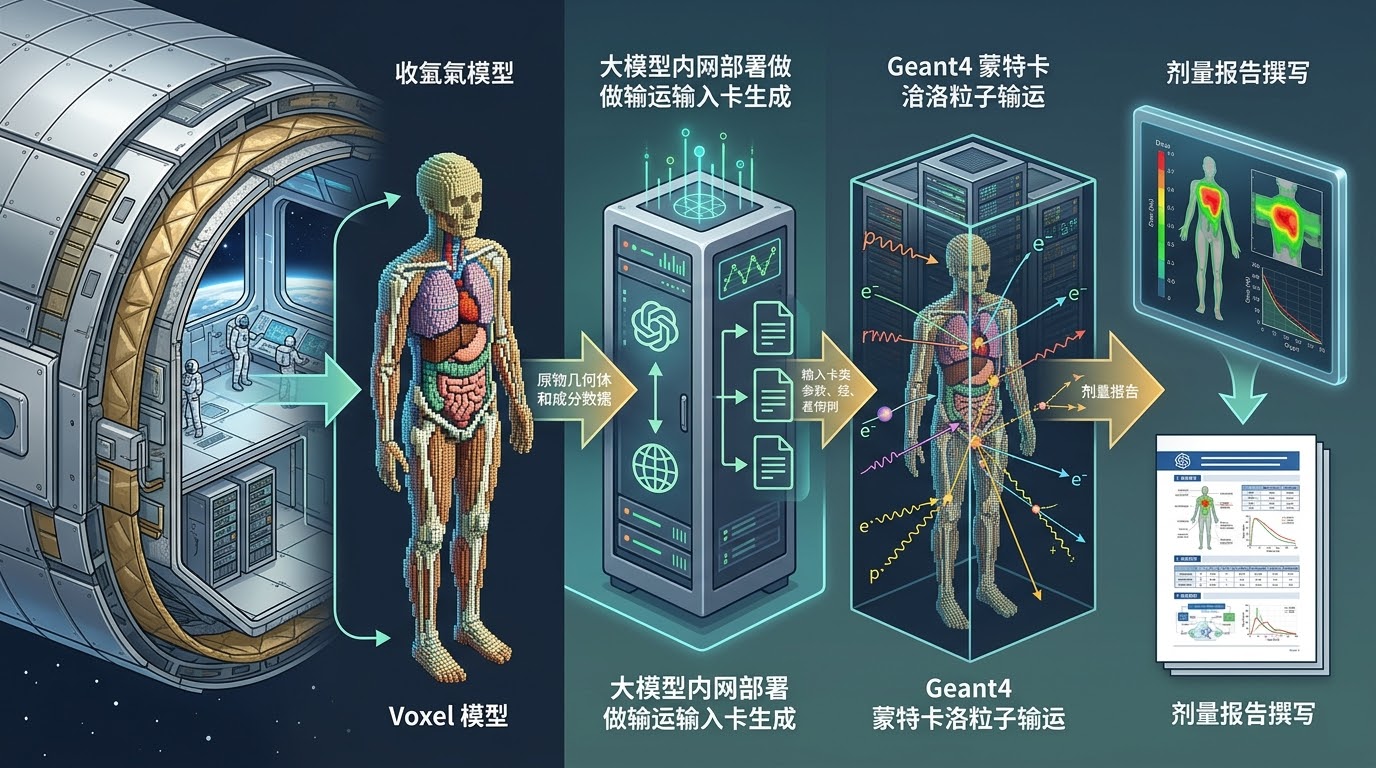
一句”80%来自地球辐射带质子”背后,是亿万粒子的随机游走
2023年,《航天器环境工程》刊发了一项来自南京航空航天大学航天学院的研究:为了评估空间站舱内航天员的辐射风险,研究团队基于CT数据建立了精细化的男性体素模型,再用Geant4搭建蒙特卡罗输运程序,计算空间站轨道辐射穿过舱壁——等效5 g/cm²铝屏蔽——之后沉积在人体组织中的吸收剂量、当量剂量与有效剂量。结论令人印象深刻:航天员体内吸收剂量约80%来自地球辐射带质子,约14%来自银河宇宙线质子,α粒子约占5%,其余重离子加起来约1%。
这类屏蔽体剂量评估问题的计算模式非常典型:真实源项经过舱壁材料的多重散射与核反应,演变为次级中子、γ光子和带电粒子的级联过程,只能靠随机抽样逐粒子追踪。把时间线往前推,2012年12月《强激光与粒子束》刊登了该校核科学与工程系耿长冉、汤晓斌、谢芹与陈达等人的工作:用Geant4对银河宇宙线和典型太阳质子事件做蒙特卡罗模拟,发现1 g/cm²铝等效屏蔽能把太阳质子事件的皮肤剂量压到初始值的8%左右,10 g/cm²可压到0.48%左右,而平均能量更高的银河宇宙线,加厚屏蔽的收益相当有限,浅层组织剂量甚至不降反升。
两个工作相隔十一年,工具都是Geant4,内核都是蒙特卡洛粒子输运,差别在算例规模与模型精细度。这也是辐射防护与核安全专业日常的缩影:从课程作业里的点源平板屏蔽,到全尺寸设施三维剂量场,同一套输运代码,算力需求可以差出几个数量级。这篇文章换个玩法:给辐射屏蔽计算做一场极限压力测试,看一台机器从轻载到极限负载分别能扛到哪一级,以及——既然标题摆在这里——这个过程到底该押注CPU还是GPU。
压力测试设计:同一套输运逻辑,四级加码
测试对象设定为典型的屏蔽体剂量评估任务:给定辐射源项与屏蔽结构,用蒙特卡洛方法计算屏蔽体外表面的剂量率,或屏蔽体内部某关注位置的通量与剂量。逐级加码的规则很简单——几何复杂度、粒子抽样数、计数(tally)精细度三项同时拉升,看每一级先把哪项资源打爆。
Level 1:轻载——教学级点源平板屏蔽
最简单的算例:一个各向同性点源,一层或几层平板屏蔽材料,抽样一百万到一千万个粒子,目标相对误差控制在5%以内。蒙特卡洛的统计规律决定了结果误差与抽样数平方根成反比,要把误差从5%压到1%,粒子数要放大约25倍——这是所有后续压力的根源。
这一级别任何主流台式工作站都能从容应对,几分钟到十几分钟出结果。此时的瓶颈甚至不在算,而在前后处理:几何建模、截面库读取、结果可视化。Level 1考的是机器的日常体验分,而非算力分。
Level 2:中载——加速器机房与核设施局部屏蔽
加码到真实工程问题:一座医用直线加速器机房的迷路屏蔽,或核设施某个工艺间的局部剂量评估。几何从十几层平板变成由数百上千个cell拼成的三维结构,粒子数拉到一亿量级,还要分多个计数栅元分别给出剂量率分布。Geant4的多线程模式或MCNP的并行计算在这时开始真正发力,32到64个物理核心能把实际耗时压进几个小时。
第一个瓶颈随之出现:内存。每个线程都要维护独立的几何索引、截面缓存与计数器数组,线程数翻倍,内存占用几乎线性上涨;再加上连续能量截面库本身的体积,整机内存很容易顶到几十GB。这个阶段如果内存不够,下场只有两个:线程数打折,或者操作系统开始swap——后者一旦启动,性能损失远不止一两成,而是直接垮一个数量级。
Level 3:重载——深穿透问题与降方差技巧
压力测试真正的分水岭是深穿透。屏蔽计算的工程目标常常是”屏蔽体外一米处剂量率是多少”——光子或中子穿过厚屏蔽后,通量指数衰减几个数量级,直接模拟意味着绝大部分粒子在屏蔽体内就被吸收,能到达关注位置的粒子寥寥无几,统计误差怎么都压不下去。
工程上的答案是降方差技巧:权窗、源偏置、指数变换,本质都是把有限的抽样预算强行倾斜到关注区域。代价是技术门槛与调参轮次陡增,而硬件负担并不会因此变轻——为了让偏置后的粒子历史有意义,总抽样数往往不降反升,实际算力消耗通常是Level 2的数倍。此时第二个瓶颈浮现:内存带宽。蒙特卡洛输运每一步都要随机访问截面数据,缓存命中率成为性能关键;核心数堆上去之后,每个核能分到的带宽越来越窄,并行效率出现拐点。
Level 4:极限负载——全尺寸设施遇上体素人体模型
最后一级加码,把前面所有要素叠加:全尺寸核设施或航天器屏蔽结构的三维精细几何,数十亿粒子抽样,再加上人体体素模型——开篇提到的航天员剂量评估就属于此类。体素模型把人体切成千万级微小体素,每个体素独立计数,tally的内存开销与输出数据量同步爆炸。
到这一级,单机平台的三个上限会先后到来:内存容量上限,tally数组与过程数据塞不下;缓存与带宽上限,截面随机访问喂不饱上百个核心;时间上限,哪怕能跑,一次完整计算按周计时,课题进度等不起。工程上的出路是跨节点并行:把粒子历史切成独立任务分发到多台机器,计算与存储分离,配并行文件系统。换句话说,Level 4的单机形态是一台超大内存的双路旗舰工作站;再往上,就是小型专用集群的地界了。
绕不开的问题:这类计算用CPU还是GPU?
压力测试走完,标题里的问题自然有了答案:MCNP没有官方GPU版本,FLUKA只运行在CPU上,Geant4的GPU路径停留在研究阶段,生产级屏蔽计算几乎清一色跑CPU——根源在算法本性。蒙特卡洛粒子输运是分支极多的条件密集型随机游走:每个粒子的下一步是散射、吸收还是穿出几何,运行时才知道,同一批线程很快各走各的路,GPU并行执行架构遭遇严重的线程分歧,理论浮点算力根本释放不出来。
所以辐射屏蔽计算的硬件优先级很清楚:CPU核心数、每核缓存与内存带宽、内存容量排前三。GPU在此处的正经用途是结果三维可视化,以及下面要聊的另一件事——大模型内网部署。
大模型内网部署:让输入卡与剂量报告跟上计算效率
屏蔽计算有个甜蜜的负担:算得快了,前后处理反而成了新瓶颈。一份像样的MCNP或Geant4算例,输入卡动辄几百行,剂量评估报告要对照标准逐条给出结论,这些文字与逻辑密集型工作,恰恰是大语言模型的主场。在课题组内网部署大模型,理由有三:其一,屏蔽计算输入卡包含设施几何、源项活度等敏感信息,涉核项目往往在内网环境开展,数据出域这条路从制度上就被堵死;其二,一个课题组每年产出的输入卡与报告数以百计,按次调用云端接口的长期花费会超过本地一次性投入;其三,内网服务离线可用,外场测量与出差场景不受网络条件掣肘。
模型选型上,两个真实开源模型足以覆盖这个场景。负责长文撰写与格式规范的是Llama-3.3-70B——Meta在2024年12月发布的700亿参数指令模型,128K上下文足以吞下一整份输入卡加技术文档,适合剂量报告撰写与输入卡语法规范化;负责复杂逻辑排错的是R1-Distill-Qwen-32B,DeepSeek在2025年1月随R1系列开源的320亿参数蒸馏模型,继承了R1的长思维链推理能力,适合分析输入卡中偏置参数与几何定义的潜在冲突。
显存估算有一个简单口径:所需显存约等于参数量(B)乘以量化字节数,再乘1.2的KV cache余量系数——FP16每参数2字节,Q8每参数1字节,Q4每参数0.5字节。照此计算,R1-Distill-Qwen-32B用Q4量化约需19到22GB显存,24GB显存的单卡即可舒适运行;Llama-3.3-70B用Q4量化约需39到43GB,单卡得48GB起步,或者直接上双卡。FP16状态下70B模型约需140GB显存,那是数据中心多卡的领域;课题组用Q4这一档,精度损失极小,是消费级部署的默认选择。
速度量级同样值得建立直觉:纯CPU内存推理只有个位数tokens每秒,生成一张输入卡要等上一顿饭;单卡GPU推理则可达几十到上百tokens每秒,体验从煎熬变成流畅。若还想用课题组积累的历史报告做LoRA微调,32B级模型的显存增量约在10GB以内,现有机器加一张卡就能胜任;全参数微调的显存需求数倍于推理,则另当别论——这也为后面的配置分档埋下了伏笔。
主流蒙特卡洛屏蔽计算软件盘点
MCNP:屏蔽计算的行业基准
由美国洛斯阿拉莫斯国家实验室维护的MCNP系列,是辐射屏蔽与剂量评估事实上的基准工具,连续能量截面库与丰富的计数类型是它的看家本领,6系列仍在持续更新。核工程与辐射防护领域的技术文件里,用MCNP复核几乎是默认动作。它纯CPU运行,支持共享内存与分布式内存两级并行。
Geant4:开源世界的全能选手
由欧洲核子研究中心主导开发的开源工具包,以C++内核加物理过程模块构成,自由度极高:粒子种类、物理列表、几何描述全都可以按需定制,多线程模式成熟。从空间辐射防护到加速器屏蔽,从医学物理到核安全检查,Geant4的身影无处不在——本文开篇的两项工作都基于它完成。代价是学习曲线陡,上手需要写代码。
FLUKA:强子输运与复杂屏蔽的老牌利器
由欧洲核子研究中心与意大利国家核物理研究院等机构联合维护,FLUKA在强子与电磁级联、深穿透屏蔽问题上口碑扎实,宇宙线与加速器屏蔽领域应用广泛,近年持续迭代新版本。它同样运行在CPU上,输入文件风格自成一派,与MCNP各有拥趸。
配置推荐:按压力等级对号入座的四档机型
做辐射防护计算的经常遇到这种情况:文献里写”我们用Geant4跑了数十亿粒子历史”,你再看自己实验室那台老旧台式机,心里直打鼓——这能复现吗?其实多数时候,关键不在核数多少,而在内存够不够顶住tally数组、缓存与带宽喂不喂得饱随机截面访问,以及机器扛不扛得住7×24小时的连续输运计算。结合前面压力测试各等级的瓶颈分析,下面这四档配置按”能稳跑到哪个Level”来分,供课题组规划设备时对照。
方案A:教学算例与轻量评估(对应Level 1)
适用场景:本科课程设计、点源平板屏蔽教学算例、核安全评审中的快速估算,以及R1-Distill-Qwen-32B级模型的内网推理服务。
推荐机型:A350 153128-MCT
- CPU:Intel Ultra9 285K(24核,8P核5.6GHz)+水冷
- GPU:RTX 5090D v2 24GB+水冷
- 内存:128GB DDR5
- 存储:4TB NVME + 8TB SATA
- 显存:24GB
- 显存带宽:1.34 TB/s
- 注:CPU频率为UltraLAB全核超频实测优化频率。
方案B:设施局部屏蔽的并行计算(对应Level 2)
适用场景:加速器机房、核医学场所与核设施局部屏蔽评估,亿级粒子并行走批,兼顾32B级模型的内网服务。
推荐机型:GR450P 148192-MDT
- CPU:AMD锐龙TR 7980X(64核,4.8GHz)
- GPU:RTX 5090D 32GB
- 内存:192GB DDR5
- 系统盘:4TB NVME
- 数据盘:8TB NVME+20TB SATA
- 显存:32GB
- 显存带宽:1.79 TB/s
- 注:CPU频率为UltraLAB全核超频实测优化频率。
方案C:深穿透问题与降方差攻坚(对应Level 3)
适用场景:厚屏蔽深穿透剂量评估、多轮降方差调参、数十亿粒子长周期计算,并可承担Llama-3.3-70B级模型的内网推理。
推荐机型:GR450P 145384-MDA
- CPU:AMD锐龙TR PRO 7995W(96核,4.5GHz)
- 图形卡:Quadro T400
- 计算卡:A100 80GB+水冷
- 内存:384GB DDR5
- 系统盘:4TB NVME
- 数据盘:8TB NVME+20TB SATA
- 显存:4GB / 80GB
- 显存带宽:80 GB/s / 2 TB/s
- 注:CPU频率为UltraLAB全核超频实测优化频率。
方案D:全尺寸设施与体素人体模型的极限计算(对应Level 4)
适用场景:全尺寸三维设施剂量场、人体体素模型叠加计算、课题组共享的旗舰级输运平台,并为将来跨节点并行留足扩展空间。
推荐机型:AlphaPro660 241640-MDD
- CPU:2×AMD霄龙9655(192核,4.1GHz)
- GPU:RTX Pro 5000 72GB
- 内存:640GB DDR5
- 系统盘:8TB NVME
- 数据盘:20TB SATA
- 显存:72GB
- 显存带宽:1.34 TB/s
- 注:CPU频率为UltraLAB全核超频实测优化频率。
常见问题FAQ
蒙特卡洛屏蔽计算能上GPU加速吗?
截至目前的生产实践,不能指望。粒子输运的分支型随机游走与GPU并行模型天生不合,把买顶级显卡的钱投到更多CPU核心、更大内存与更高内存带宽上,收益立竿见影。显卡的合理位置是三维可视化与大模型内网部署。
CPU核心数和内存容量,先保哪一个?
先保内存。蒙特卡洛输运的内存占用随线程数与tally规模线性增长,内存不够就swap,性能直接塌方;核心数不足还可以靠延长计算时间弥补。经验法则是按目标并行线程数预留内存,再为体素模型或大规模tally留一倍余量。
深穿透问题为什么特别烧钱?
通量随屏蔽厚度指数衰减,而蒙特卡洛误差只按抽样数平方根下降,两者对冲之下,直接模拟成本指数级膨胀。降方差技巧换来数量级效率提升,但调参需要多轮试算,总账依然昂贵——这正是Level 3以上机型存在的意义。
普通台式机或游戏本能跑Geant4吗?
能,但只限于Level 1教学算例。游戏本的长时散热与内存上限是硬伤:粒子输运动辄连续跑十几小时,消费级机器的降频与稳定性都是隐患,更不用说内存顶到上限后的swap。课题级的计算还是交给工作站。
内网部署R1-Distill-Qwen-32B和Llama-3.3-70B,显卡门槛在哪?
按Q4量化口径,32B级模型约需19到22GB显存,24GB单卡即可舒适运行;70B级约需39到43GB,48GB以上显存或双卡是稳妥方案。若还要LoRA微调,在此基础上再预留约10GB。前两级配置满足32B推理,后两级可覆盖70B推理加微调余量。
单机什么时候必须上集群?
当一次完整计算需要按周计时,且tally数据量与内存需求超出单机上限时,就该考虑多节点方案了:粒子历史天然可拆分,跨节点并行加并行存储是标准解法。好消息是Level 4旗舰机通常能多扛一两年,为集群建设留出论证与经费周期。
结语
回到开头那句”80%来自地球辐射带质子”。它读起来只是论文里的一个百分比,背后却是体素模型、厚屏蔽深穿透与数十亿粒子历史的叠加——这正是辐射屏蔽计算的宿命:物理上无法绕开的随机抽样,工程上无法妥协的统计精度。压力测试的意义就在于此:知道自己机器的死线在哪里,比相信它能无限扛下去重要得多。蒙特卡洛粒子输运的世界里,CPU、缓存与内存带宽是硬通货;而大模型内网部署的加入,让这台机器在跑输运的间隙,还能替你把输入卡和报告一并写完。
工作站配置选型欢迎咨询~
微信号:maxftxwx
fuyiqin@xasun.com












