
引言:从”确定论”到”概率论”的预报范式转移
2025年10月,在南京举行的中国气象学会年会上,国防科技大学任开军教授展示了团队最新研制的全AI驱动中期天气智能预报原型系统”羲辰”。该系统在智能同化、注意力机制及四维变分技术融合方面取得突破,标志着我国人工智能气象预报迈入了关键阶段。2026年3月,复旦大学与上海科学智能研究院联合研发的”伏羲”端到端气象预测模型体系入选2025年度”中国十大气象科技进展”——其集合预报大模型在98.1%的气象要素CRPS指标上超越了欧洲中期天气预报中心(ECMWF)这一国际标杆。
这两项成果指向同一个技术方向:集合预报(Ensemble Prediction)。如果说传统的数值天气预报是在求解一组偏微分方程的”唯一解”,那么集合预报则是在追问:”如果初始条件稍微变一点,结果会怎样?”这个看似简单的思路转变,彻底重塑了现代天气预报的方法论,也对支撑其运行的高性能计算基础设施提出了全新要求。
集合预报的本质:驯服混沌的数学艺术
蝴蝶效应与预报的不确定性边界
气象学家洛伦茨在1960年代提出的”蝴蝶效应”揭示了一个残酷事实:大气是一个典型的混沌系统,初始条件的微小误差会在积分过程中指数级放大。传统确定性数值预报只能给出一条预报曲线,却无法回答”这条曲线有多可信”这一关键问题。
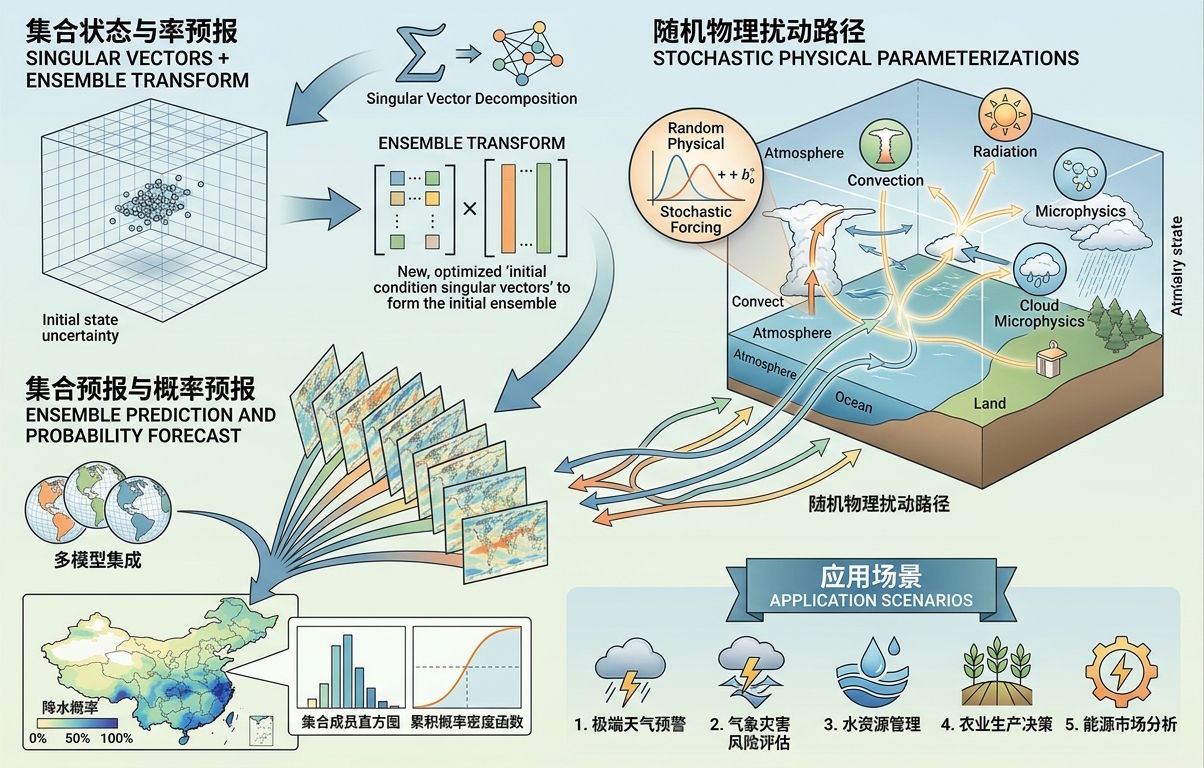
1992年,欧洲中期天气预报中心(ECMWF)率先将集合预报业务化。其核心思路并不复杂:在观测资料同化得到的”最佳初始场”基础上,引入一组精心设计的微小扰动,每个扰动对应一个独立的数值预报积分。最终得到的不是一张预报图,而是一组(通常50个左右)预报成员的”集合”。如果集合成员之间分歧很小,说明预报置信度高;如果成员发散严重,则说明该天气过程的可预报性较低。
扰动生成:集合预报的技术核心
集合预报系统的性能高度依赖于扰动方法的设计。目前主流技术路线包括三类:
初值扰动是最基础的方法,通过在分析场中叠加基于观测误差统计的随机扰动向量,模拟初始条件的不确定性。ECMWF早期采用的奇异向量法(SV)和中国气象局全球集合预报系统采用的奇异向量法(SV)均属此类。区域集合预报系统则采用集合转换卡尔曼滤波(ETKF)。这类方法的数学本质是在相空间中寻找增长最快的扰动方向,确保有限计算资源投放到最敏感的区域。
模式扰动则针对数值模式本身的缺陷——物理参数化方案的不确定性。同一套模式,如果积云对流参数、边界层方案或辐射方案的系数稍作调整,预报结果可能显著不同。随机物理过程倾向扰动(SPPT)和随机动力扰动(SKEB)是目前应用最广泛的模式扰动技术。
多模式集合是更高层次的做法,将不同国家、不同机构的独立预报系统结果进行加权融合。世界气象组织(WMO)下属的TIGGE项目汇集了全球十余个主要数值预报中心的集合预报产品,其核心理念是:模式间的系统性偏差往往可以相互抵消,从而提升整体预报技巧。
从天气预报到气候预测:集合方法的延伸
集合预报的思想早已超越短期天气预报,渗透到次季节-季节预测(S2S)、气候预估乃至极端事件预警等更广阔的领域。2026年3月,以伏羲次季节气象大模型为底座,团队联合国家气候中心研发的”风顺大模型”能在3分钟内完成未来60天的预测,多次成功预报极端降水和干旱事件。这类AI驱动的集合系统不再依赖传统数值模式的物理方程积分,而是通过数据驱动的方式学习历史天气演变规律,在计算效率上实现了数量级的跃升。
AI赋能集合预报:技术融合的新纪元
传统数值集合的算力瓶颈
一套全球高分辨率集合预报系统的计算开销是惊人的。以中国气象局的CMA-GEPS为例,全球集合预报系统包含31个成员,每个成员在全球格点上积分10天,水平分辨率约50公里,垂直层次60层。这意味着每天需要完成超过3000核·年的计算量。再加上资料同化、后处理、产品生成等环节,对高性能计算集群的存储I/O、网络带宽和并行扩展能力都提出了极高要求。
深度学习带来的效率革命
2023年以来,以英伟达FourCastNet、谷歌GraphCast、华为盘古、上海AI实验室风乌为代表的AI气象大模型相继涌现。这些模型的共同特点是:不再需要逐时间步积分求解Navier-Stokes方程,而是通过神经网络直接学习从当前大气状态到未来状态的映射。单次推理可在秒级完成,速度比传统数值模式快4-5个数量级。
国防科技大学研制的”羲辰”系统走得更远——它将AI预测与四维变分同化框架融合,在保持物理一致性的同时实现了端到端的智能预报。而”伏羲”模型通过高效集合扰动设计,在概率预报核心指标CRPS上超越了运行了25年的ECMWF业务系统。这些进展说明:AI不是要取代物理模式,而是在计算效率难以突破的环节提供替代路径,两者正走向深度融合。
本地化部署AI气象模型的现实意义
对于气象科研院所、省级气象台站和气象服务企业而言,完全依赖国家级中心的产品存在时效性和定制化不足的问题。以区域高分辨率集合预报为例,省级业务部门需要在国家级全球预报的基础上,运行本地化的中尺度模式(如WRF),进行动力降尺度或统计后处理。一套支持本地AI气象模型训练与推理的高性能工作站,能够显著提升科研和业务自主能力。
集合预报场景的硬件需求分析
集合预报及相关的数值模拟、AI训练任务对工作站硬件有三重核心诉求:
第一是CPU密集型计算能力。传统数值模式的积分求解是纯粹的浮点运算密集任务,对CPU核心数和内存带宽都很敏感。集合成员的并行运行需要多核CPU支持,而高分辨率格点数据的海量存储则要求大容量内存。
第二是GPU加速能力。无论是AI气象模型的训练(如伏羲、羲辰类模型的本地化微调)还是WRF-GPU等加速版数值模式的运行,GPU都已成为不可或缺的算力组件。显存容量直接决定了单次推理能处理的格点规模,而FP16/FP32算力则影响训练效率。
第三是存储I/O吞吐量。单个全球集合预报成员的输出数据可达数十GB,数十个成员加上诊断产品,一次预报周期的数据量轻松突破TB级别。高速NVMe存储不仅是系统盘的需求,更是数据读写效率的瓶颈所在。
集合预报与气象计算工作站配置推荐
基于上述分析,对于从事集合预报研究、数值天气模式开发或AI气象模型本地部署的科研团队,以下四级配置方案可作为参考:
方案A:入门级科研与教学型
适用场景:集合预报算法学习、中小尺度区域模式试验、轻量级AI模型推理
推荐机型:A350 15064-MBX
- 价格区间:2~4万
- CPU:Intel Ultra7 265K(20核,8P核5.1GHz)+ 水冷(5.1GHz为全核超频实测优化频率,Intel官方单核最高5.5GHz)
- GPU:RTX5060Ti 16GB
- 内存:64GB DDR5
- 存储:4TB NVMe(14GB/s)
推荐理由:该配置适合研究生入门学习集合预报基础算法,或运行城市尺度的WRF集合试验。RTX5060Ti 16GB显存可支持中等规模神经网络模型的推理任务,20核CPU足以应对中小型集合成员并行。
方案B:区域集合预报业务型
适用场景:省级气象台站区域集合预报业务、中尺度模式参数化试验、AI后处理模型训练
推荐机型:GR450P 150128-MCT
- 价格区间:12~14万
- CPU:AMD锐龙TR Pro 7975WX(32核,5.0GHz)+ 水冷(5.0GHz为全核超频实测优化频率,AMD官方单核最高5.3GHz)
- GPU:RTX5080 16GB
- 内存:128GB DDR5
- 存储:4TB NVMe SSD
- 显存带宽:960GB/s
推荐理由:32核高频CPU为WRF、GRAPES等区域模式的多成员并行提供强劲算力。128GB内存可支撑千万格点级别的区域集合试验。RTX5080的FP32算力达56.28 TFLOPS,满足中等规模AI气象模型的训练需求。
方案C:全球模式与AI融合研究型
适用场景:全球集合预报系统开发、AI气象大模型微调、多模式集合后处理
推荐机型:EA660 245512-MDB
- 价格区间:30~32万
- CPU:2×AMD霄龙9475F(96核,3.65~4.8GHz)(4.8GHz为全核超频实测优化频率,AMD官方单核最高4.8GHz)
- GPU:RTX A2000 6GB
- 内存:512GB DDR5
- 存储:8TB NVMe Gen5
- CPU性能:6.9Tflops
推荐理由:双路霄龙96核配置提供接近700 GFLOPS的双精度浮点算力,适合全球谱模式等依赖CPU双精度运算的集合预报系统。512GB内存可完整加载全球高分辨率再分析资料进行集合后处理试验。虽GPU配置偏保守,但CPU端的极致性能正是全球数值模式的核心诉求。
方案D:AI气象大模型训练与推理型
适用场景:本地化AI气象大模型训练(如伏羲、盘古等架构的迁移学习)、高分辨率集合预报产品生成、气象数据智能分析
推荐机型:GX660M 227256-MC4T
- 价格区间:31~33万
- CPU:2×Xeon金牌6530(64核,2.7~4GHz)(4.0GHz为全核超频实测优化频率,Intel官方单核最高4.1GHz)
- GPU:4×RTX4090 48GB + 水冷
- 内存:256GB DDR5
- 存储:4TB NVMe + 20TB SATA
- FP32算力:288Tflops
推荐理由:4块RTX4090 48GB提供总计192GB显存和超过320 TFLOPS的FP32算力,足以支撑70B参数级别气象大模型的全精度推理或LoRA微调。双路Xeon处理器负责数据预处理与后处理,256GB内存保障海量气象数据集的快速加载。该配置代表了当前AI气象计算的前沿算力水平。
主要软件生态
数值模式核心:WRF(Weather Research and Forecasting)、GRAPES(中国气象局全球/区域同化预报系统)、ECMWF-IFS(欧洲中期天气预报中心集成预报系统)、CESM(社区地球系统模式)。
资料同化平台:WRF-DA(三维/四维变分同化)、DART(数据同化研究测试平台)、JEDI(联合地球系统资料同化基础设施)。
AI气象模型:伏羲(Fuxi)、盘古气象(Pangu-Weather)、GraphCast、FourCastNet、风乌(FengWu)。
后处理与可视化:ECtools(集合预报诊断工具)、NCL/NCAR、Python(xarray、matplotlib、cartopy生态)、MetPy。
并行计算框架:MPI(消息传递接口)、OpenMP、NCCL(GPU多卡通信)、PyTorch/TensorFlow(AI模型训练)。
常见问题
Q1:集合预报需要多少个成员才足够?
A:这取决于应用场景。全球中期预报通常需要30-50个成员以充分采样概率分布;极端天气预警可能需要100个以上成员以捕捉小概率尾部事件;而AI驱动的集合系统(如伏羲)可通过高效的隐式扰动设计,在更少的推理次数下达到相近的概率覆盖度。
Q2:AI气象模型能否完全替代传统数值模式?
A:短期内不能。AI模型在计算效率和模式识别上优势显著,但在物理守恒性、极端事件外推和可解释性方面仍有局限。当前最佳实践是”AI+物理”的混合范式:AI负责快速生成初估场,物理模式负责约束守恒律。
Q3:区域集合预报与全球集合预报对硬件的要求有何不同?
A:全球预报对CPU双精度算力和内存容量要求更高,因为需要处理全球格点数据;区域预报通常分辨率更高、物理过程更复杂,对CPU主频和存储I/O更敏感。如果涉及AI后处理,两者都对GPU有明确需求。
Q4:显存容量如何影响AI气象模型的应用?
A:全球气象数据的空间维度极大。以1°分辨率为例,单时次全球格点数据包含约6万个水平格点×37个垂直层次×6个变量。训练或推理时,模型需要将时空序列数据打包为张量送入显存。显存不足将被迫降低分辨率或缩短序列长度,直接影响预报精度。
Q5:集合预报后处理中统计方法的计算量如何?
A:集合后处理(如贝叶斯模型平均、分位数映射校准、极端事件概率提取)的计算量常被低估。以50个成员、10天预报、6小时间隔为例,仅生成概率预报产品就涉及数万次统计运算。大内存和高主频CPU是保障后处理效率的关键。
Q6:气象工作站是否需要特殊的环境要求?
A:是的。数值模式积分通常是数小时到数十小时的连续计算,对系统稳定性要求极高。建议配置UPS不间断电源、机房级散热方案,并选择经过长时间稳定性验证的硬件平台。水冷散热在高负载持续运行场景下比风冷更具优势。
结语
从1993年银河-II巨型计算机支撑我国首套中期数值天气预报业务系统,到如今”羲辰””伏羲”等AI驱动集合预报系统的涌现,中国气象预报技术走过了三十余年的跨越式发展。集合预报的普及让天气预报从”猜一个数字”进化到”给出一个概率分布”,其背后是算法创新、物理认知与计算能力的三重跃迁。
对于深耕气象预报领域的科研团队和业务部门而言,选择一套与自身研究尺度、算法路线和数据规模相匹配的高性能工作站,不是锦上添花的装备升级,而是决定研究能否触及前沿的底层基础设施。毕竟,在混沌的大气面前,算力不只是速度——它是我们窥探未来天气的窗口能开多大。
如果您有任何配置疑问欢迎加微信沟通~
微信号:maxftxwx












