
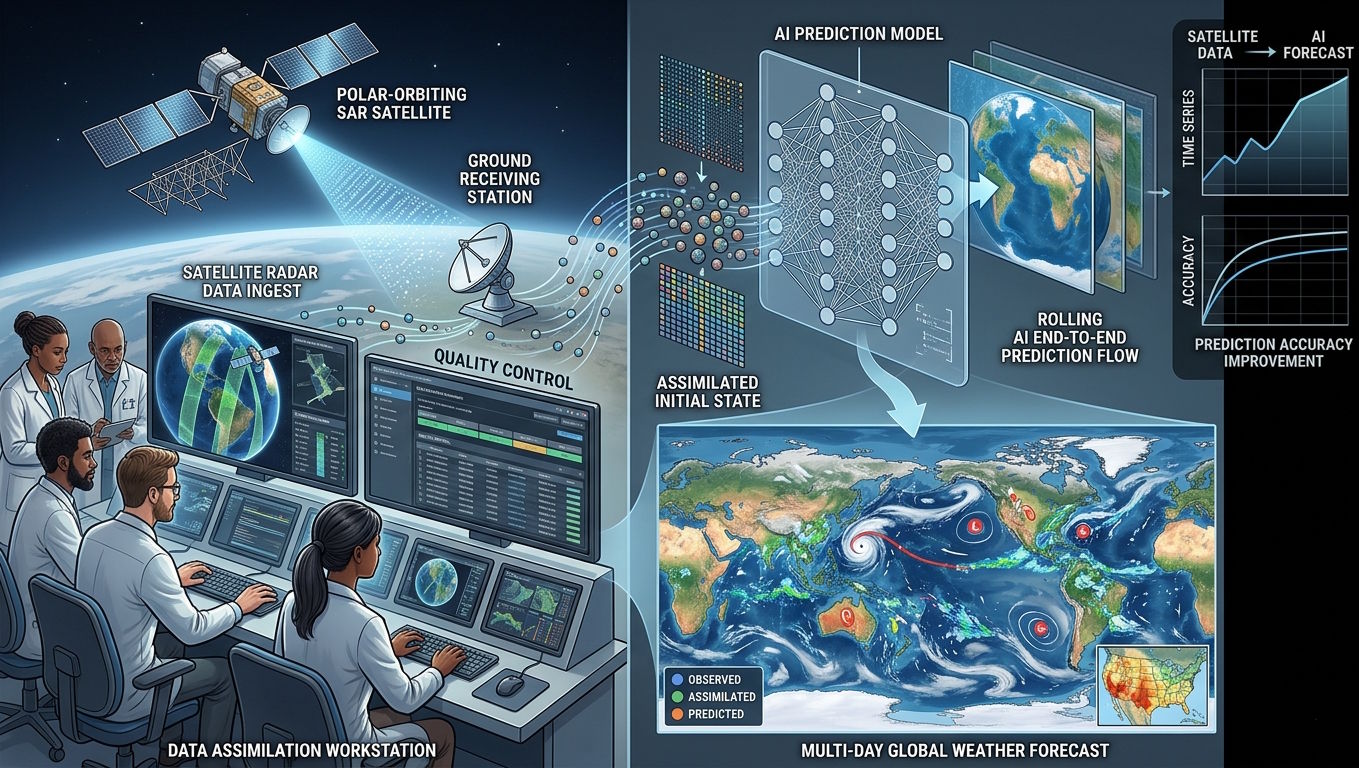
2024年12月31日,中国气象局全球数值天气预报系统CMA-GFS 4.2版完成了一项关键升级:全球四维变分同化(4DVar)正式升级为全球集合四维变分同化(En4DVar),并投入业务运行。这意味着中国数值天气预报的初始场质量迈上了新台阶——而站在这一切背后的,是一门名为”资料同化”的技术。
如果你曾好奇过,为什么手机上的天气预报越来越准、台风路径误差逐年缩小,答案并不完全在于”算得更快”的模式,而在于”起点更准”的初始场。资料同化就是那个把卫星、雷达、探空、地面站等成千上万条观测数据,塞进数值模式初始场的”翻译官”。它不是简单的插值,而是一场在高维空间中进行的精密优化——把观测和模式背景场之间的矛盾,用数学手段调和到最优。
资料同化到底在做什么
数值天气预报的本质,是求解大气运动方程组。给定一个初始状态,模式向前积分,就能算出未来的天气。但问题是:初始状态从哪来?观测数据零零散散,空间分布极不均匀——地面站只在陆地上,探空气球一天两次,卫星虽全球覆盖但存在云雨遮挡。这些观测不能直接作为模式的初始场,因为它们和模式变量之间隔着一层复杂的”观测算子”。
资料同化的核心任务,就是解决这个”观测到模式”的映射问题。它把观测信息和模式背景场(通常是上一时次的预报结果)融合起来,生成一个最优的初始场估计。从数学上看,这等价于求解一个最优化问题:找到一个模式状态,使得它与背景场的偏差和与观测的偏差之和达到最小。
目前主流的资料同化方法分为三大类。第一类是变分同化,包括三维变分(3DVar)和四维变分(4DVar)。3DVar只在单个时刻寻找最优分析场;4DVar更进一步,考虑观测在时间窗口内的分布,让模式轨迹在6小时同化窗内整体最优。欧洲中期天气预报中心(ECMWF)的IFS系统和中国的CMA-GFS都采用了4DVar框架,这也是当前全球业务数值预报的标杆配置。
第二类是集合卡尔曼滤波(EnKF)及其衍生方法。与变分同化不同,集合方法不依赖预先设定的背景误差协方差矩阵,而是通过一组模式集合成员的统计特征来动态估计误差结构。这种方法对非线性过程更加友好,在处理中小尺度天气系统时表现尤为突出。
第三类是混合同化,即把变分框架和集合方法结合起来。En4DVar就是典型的混合同化方案——用集合样本估计流依赖的背景误差协方差,再嵌入到四维变分的优化框架中。2024年底CMA-GFS升级的核心,正是这套混合同化系统。
为什么资料同化是算力黑洞
表面上看,资料同化只是”把数据揉在一起”,但它的计算开销足以让任何高性能计算集群感到压力。
首先是协方差矩阵的规模。全球模式的分辨率不断提高,CMA-GFS的水平分辨率已达到0.125°,垂直层数87层,模式状态变量的维度轻松突破十亿级别。背景误差协方差矩阵的维度是状态维度的平方——一个十亿维的矩阵,即便采用低秩近似,也需要巨大的内存和计算资源。
其次是迭代优化的代价。4DVar需要在内外循环之间反复调用模式积分和伴随模式。以GRAPES全球4DVar为例,外循环分辨率0.125°,内循环0.75°,最大迭代次数50次,每次迭代都要运行一次正模式和一次伴随模式。中国气象局的业务系统每天运行4次全球同化,这意味着单是同化环节就要消耗数千核时的计算资源。
第三是观测数据的爆炸式增长。2021年风云三号E星(黎明星)成功发射,中国实现了上午星、下午星、黎明星的三星组网观测,填补了极轨卫星在6小时同化窗口内的覆盖盲区。加上静止卫星FY-4A/B的高光谱探测、多普勒天气雷达的分钟级更新、风廓线雷达的连续观测——每天进入同化系统的观测数据量已经超过千万量级。每一条观测都要经过质量控制、偏差订正、稀疏化,再与模式变量建立映射关系,这个过程对I/O带宽和内存容量提出了极高要求。
第四是集合成员并行的压力。集合同化方法需要同时运行数十到数百个模式成员。国家超级计算无锡中心和清华大学联合开发的DIDA系统(发表于SC23,论文链接:https://sc23.supercomputing.org/proceedings/tech_paper/tech_paper_pages/pap139.html)就是一个典型代表——该系统基于UNet生成模型替代传统模式集合,在神威超算上实现了数百个集合成员的集合同化,强可扩展性接近线性。即便如此,单是同化系统的研发和测试,就需要在通用计算集群上进行大量并行试验。
AI正在改写资料同化的游戏规则
传统资料同化面临一个根本性的张力:它假设误差服从高斯分布、更新过程近似线性。但大气系统本质上是高度非线性的,尤其是当模式分辨率进入公里尺度、需要解析对流尺度过程时,这些假设的偏差会迅速放大。AI的出现,为这一困境提供了新的解法。
2024年,上海人工智能实验室联合多家机构发布的”伏羲”气象预测大模型体系,入选2025年度”中国十大气象科技进展”。伏羲系列实现了从临近预报到气候预测的全覆盖,其中关键的一环正是AI驱动的资料同化探索。与传统方法相比,深度学习模型可以从海量历史数据中学习非线性的误差结构,无需显式构造协方差矩阵。
更引人注目的是2025年3月发表在《Nature》上的Aardvark Weather。这个由剑桥大学团队开发的端到端深度学习系统,完全绕开了传统数值预报的”同化+积分”两步流程——它直接从原始观测数据生成全球网格化预报,在4块NVIDIA A100 GPU上完成一次全球预报仅需约1秒钟。相比之下,欧洲中心的高分辨率预报系统(HRES)仅资料同化和模式积分就需要约1000个节点小时。Aardvark的核心思路是用编码器整合多种观测源,用Vision Transformer处理非网格化数据,再用自回归解码器生成未来预报。这种”观测进、预报出”的端到端架构,彻底重构了天气预报的算力需求图景。
不过,AI气象模型目前仍存在一个关键短板:它们大多依赖再分析数据(如ERA5)作为训练集的”初始场”,缺乏实时资料同化的能力。这正是传统数值预报的核心护城河——它能将刚刚获取的卫星过境数据、雷达分钟级扫描、探空气球观测,在数分钟内融入初始场并启动预报。国内研究者已经意识到这一点,多篇综述论文指出:”AI气象大模型在实时数据同化方面尚显稚嫩,未来发展基于AI模型的资料同化系统是重要方向。”
国家超级计算无锡中心和清华大学在SC23上发表的DIDA系统,正是这个方向的先行探索。该系统创新性地将基于UNet的生成模型嵌入集合卡尔曼滤波框架,用神经网络生成模式集合成员替代昂贵的模式积分,在保持同化精度的同时实现了数量级的计算加速。这种”物理框架+AI替代”的混合路线,或许是资料同化下一阶段演化的主流范式。
资料同化主要软件工具
在业务和研究层面,资料同化的实现依赖于一系列成熟的软件系统。
WRF/WRFDA 是中尺度气象研究和业务应用最广泛的组合。WRF(Weather Research and Forecasting)模式本身提供动力框架,WRFDA则是其配套的同化系统,支持3DVar、4DVar和集合卡尔曼滤波等多种同化方法。WRFDA的优势在于开源、社区活跃、文档丰富,适合高校课题组进行雷达资料同化、卫星资料同化等针对性研究。其代价函数和梯度函数的可视化工具,也方便了教学和科研。
GRAPES 是中国气象局自主研发的全球/区域同化预报系统,也是中国数值天气预报业务的核心平台。GRAPES全球4DVar业务系统采用有预调节功能的Lanczos-CG算法和L-BFGS算法,前者收敛速度快、过程平稳,后者容错能力好,两者可以自动切换。区域系统CMA-MESO的千米尺度3DVar和En3DVar混合同化系统,已经在2024年实现了1km分辨率、1h更新周期的业务运行。
GSI(Gridpoint Statistical Interpolation)是美国国家环境预报中心(NCEP)开发的格点统计插值同化系统,支持3DVar和混合同化。GSI的优势在于对多种观测类型的广泛支持,包括卫星辐射率、雷达反射率、GPS掩星等,且与全球预报系统(GFS)紧密集成。
JEDI(Joint Effort for Data assimilation Integration)是近年来由多个国际机构联合推进的新一代同化框架,采用面向对象的C++设计,支持多种同化算法和多种地球系统模式(大气、海洋、陆面、海冰)的统一接口。JEDI代表了资料同化软件的发展方向——模块化、可扩展、跨模式兼容。
此外,ECMWF的IFS同化系统虽然不开源,但其技术文档和科研论文是全球数值预报领域的重要参考。欧洲中心在卫星资料同化、全天空同化、目标观测策略等方面的进展,持续引领着行业的技术前沿。
算力工作站配置推荐
资料同化的计算特性决定了硬件选型的关键要素:高核心数的CPU用于并行矩阵运算,大容量内存容纳高维协方差矩阵和观测数据,高速存储应对海量I/O,GPU则在AI辅助同化和集合预报加速中扮演越来越重要的角色。以下按四级方案推荐:
方案A:
适用场景:个人学习、中小尺度区域同化试验、WRFDA教学科研
推荐机型:A350 156128-MCA
- 价格区间:5~6万
- CPU:Intel Ultra9 285K(24核,8P核全核5.6GHz)+水冷
- GPU:Quadro T400
- 内存:128GB DDR5
- 存储:4TB NVMe(14GB/s)
- 显存带宽:288GB/s
推荐理由:24核高频CPU在中小规模3DVar试验中响应迅速,128GB内存可支撑区域模式(如中国区域3km分辨率)的同化分析,RTX A2000虽定位入门专业卡,但足以应对后处理可视化和轻量AI推理。整机静音塔式设计,适合实验室个人工位部署。
方案B:
适用场景:区域业务同化系统研发、GRAPES-MESO中等规模试验、多源观测资料融合研究
推荐机型:EX660 227192-MCX
- 价格区间:11~12万
- CPU:2×Xeon金牌6530(64核,2.7GHz)+水冷
- GPU:RTX 5060Ti 16GB
- 内存:192GB DDR5
- 存储:4TB NVMe Gen5
- CPU性能:2.7Tflops
- 显存带宽:448GB/s
推荐理由:双路Xeon提供64核并行算力,配合192GB大内存,可运行GRAPES区域3DVar的完整外循环和内循环迭代。NVMe Gen5存储提供高吞吐I/O,适合频繁读写大量观测数据。RTX 5060Ti 16GB显存可用于神经网络辅助的偏差订正或后处理加速。
方案C:
适用场景:全球模式同化试验、集合预报成员并行计算、AI辅助同化算法研发
推荐机型:EX660 227384-MCB
- 价格区间:20~21万
- CPU:2×Xeon金牌6554s(72核,2.7GHz)+水冷
- GPU:RTX A2000 12GB
- 内存:384GB DDR5
- 存储:4TB NVMe Gen5
- CPU性能:2.76Tflops
- 显存带宽:288GB/s
推荐理由:72核+384GB内存的配置,可支撑全球4DVar的外循环运行和中等规模(20~50成员)的集合试验。大内存是处理高维背景误差协方差的关键——全球模式状态向量维度超过10亿时,即使是低秩近似也需要数百GB内存。该机型也可作为JEDI框架的开发和测试平台。
方案D:
适用场景:国家级业务系统研发、大规模集合同化、AI气象大模型训练与微调、多模式耦合试验
推荐机型:EA660 234512-MCX
- 价格区间:约28万
- CPU:2×AMD霄龙9654(192核,2.4~3.7GHz)
- GPU:RTX 5080 16GB
- 内存:512GB DDR5
- 存储:4TB NVMe Gen5
- CPU性能:10Tflops
- 显存带宽:960GB/s
推荐理由:192核霄龙处理器提供极致的并行浮点算力,10Tflops的双精度性能对4DVar的伴随模式计算尤为关键。512GB内存可支持100+集合成员的并行同化,也可容纳ERA5再分析数据的全局加载用于AI模型训练。RTX 5080 16GB的960GB/s显存带宽,在基于GPU加速的集合卡尔曼滤波和神经网络替代模型推理中表现优异。该配置同时覆盖了传统资料同化和AI辅助同化两条技术路线。
常见FAQ
资料同化和插值有什么区别?
插值只是根据已知点估算未知点,不考虑观测误差的统计特征,也不利用模式的动力学约束。资料同化则是基于估计理论的优化过程,它同时考虑观测误差和背景场误差的统计分布,通过最小化代价函数生成最优分析场。简单来说,插值是”数学拟合”,同化是”物理约束下的最优估计”。
为什么4DVar比3DVar更耗算力?
3DVar只在单个时刻进行优化,4DVar则要考虑整个同化时间窗口(通常为6小时)内所有观测与模式轨迹的匹配程度。这意味着4DVar每次迭代都需要运行一次正模式和一次伴随模式,而伴随模式的开发本身就极其复杂。代价是算力,收益是更准确的初始场——ECMWF的研究表明,4DVar相比3DVar可将全球预报技巧提高约5%。
AI气象大模型会取代传统资料同化吗?
短期内不会。当前AI气象模型的主要瓶颈在于缺乏实时资料同化能力——它们依赖再分析数据训练,无法像传统NWP那样在几分钟内把最新的卫星过境数据融入初始场。Aardvark Weather虽然展示了端到端的可能性,但其训练数据仍源自传统系统的输出。未来的趋势更可能是”混合路线”:用AI加速或替代同化流程中的部分环节(如集合成员生成、观测算子计算),而非完全抛弃物理框架。
资料同化对内存的需求为什么如此之高?
资料同化需要同时在内存中保存模式背景场(全球数亿网格点×多层变量)、观测向量(千万级观测数据)、观测算子矩阵、背景误差协方差矩阵(或其低秩近似)以及优化过程中的中间变量。以GRAPES全球4DVar为例,其状态向量维度超过10亿,即使采用高效的预调节技术和降维方法,内存占用也轻易达到数百GB。
个人工作站能做什么级别的资料同化研究?
以方案A级别的配置(128GB内存、24核CPU),完全可以开展中小尺度的3DVar试验,如WRFDA同化雷达资料改进强对流预报、区域模式同化卫星辐射率等。对于4DVar和集合方法,则更适合在方案B及以上级别的多路服务器上进行。入门阶段的重点应放在理解算法原理和掌握软件操作上,而非追求模式规模。
为什么集合方法近年来受到更多关注?
集合方法的核心优势在于”流依赖”的背景误差估计——传统变分同化的背景误差协方差是静态的或缓慢变化的,而集合方法通过实时运行的一组模式成员,动态估计当前时刻的误差结构。这对于中小尺度、快速变化的大气过程尤为重要。此外,集合方法天然产出概率预报产品,为预报不确定性量化提供了直接途径。混合同化(如En4DVar)正是试图结合集合方法的流依赖误差估计和变分框架的全局最优性。
结语
资料同化是数值天气预报的”幕后英雄”。公众看到的是越来越准的台风路径预报,看不到的是每天四次、每次消耗数千核时的全球同化循环。从3DVar到4DVar,从集合卡尔曼滤波到En4DVar混合同化,再到AI驱动的端到端替代方案,这条技术路线的演进始终与算力发展紧密交织。
2024年底CMA-GFS的En4DVar升级,标志着中国在全球数值预报领域的技术追赶到并跑;而DIDA系统、伏羲大模型、Aardvark Weather等AI融合探索,则指向了更远的未来。对于气象科研工作者而言,一台配置合理的工作站不仅是运行模式的工具,更是参与这场技术演进的入场券——无论是调试WRFDA同化雷达资料,还是训练神经网络替代集合成员,算力始终是那条隐形的起跑线。
如果您有任何配置疑问欢迎加微信沟通~
微信号:maxftxwx












