
一、1公里网格,全球海洋的”显微镜”
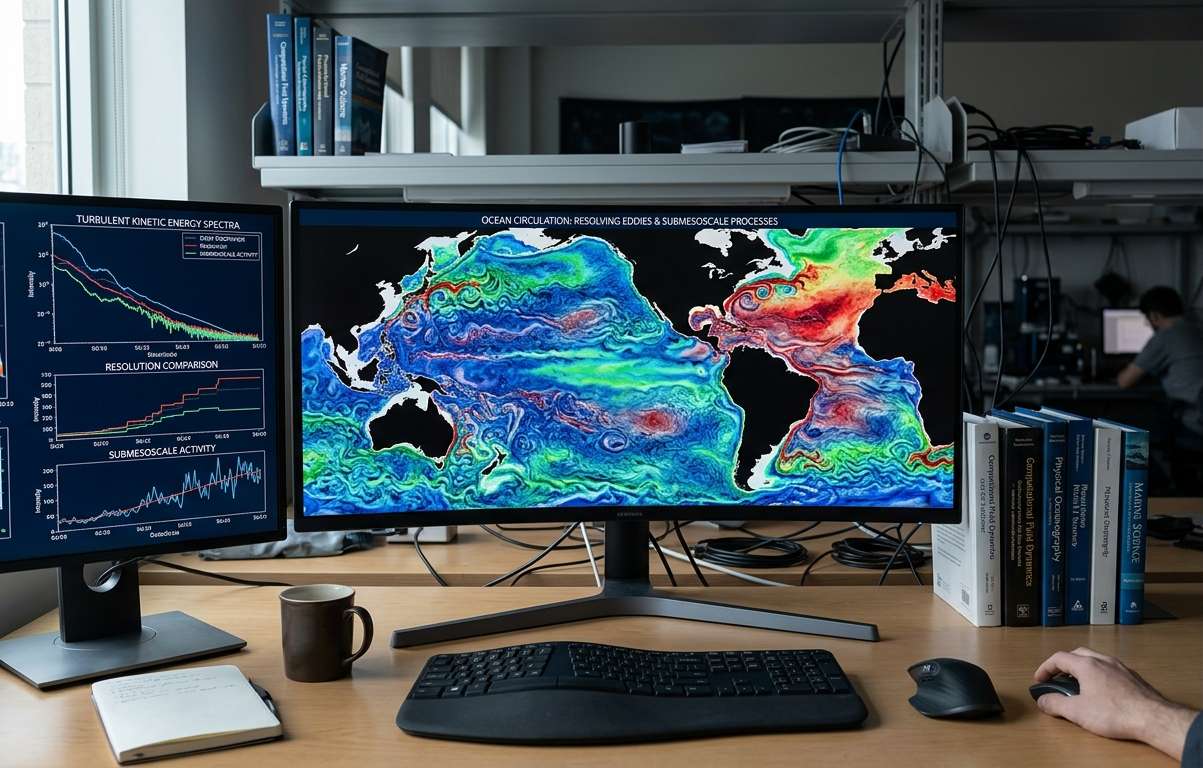
2025年3月,崂山实验室刘海龙研究员团队的一项成果登上了《创新》(The Innovation)期刊:全球首例水平分辨率达1公里的全球海洋环流模式LICOMK++,在”神威·海洋之光”国产超算上完成了具备科学价值的真实海洋短期模拟试验。这不是简单的分辨率提升——从传统10公里到1公里,网格数量膨胀了近百倍,意味着对海洋中尺度涡旋、亚中尺度锋面等精细动力过程的直接解析成为可能。
同年,这项成果入选中国气象局发布的2024年度”中国十大气象科技进展”,并入围国际高性能计算领域最高奖——戈登·贝尔气候建模奖。2025年8月,该团队更进一步,将LICOMK++耦合国产超高分辨率大气模式GRIST,构建出公里级地球系统模式AP3ESM,在3公里大气和2公里海洋耦合配置上实现峰值速度达每天1.01模拟年,再次入围戈登·贝尔奖并斩获CCF HPC China 2025″超算年度最佳应用”奖。
海洋覆盖了地球表面71%的面积,吸收了超过90%的全球变暖新增热量和30%以上的人为二氧化碳排放。理解海洋环流如何搬运热量、盐分和碳,直接关系到气候预测的精度和极端天气的预警能力。而要做到这一点,计算模拟是几乎唯一的手段——卫星能观测海面,但无法直接测量数千米深的海流;浮标能记录点位数据,却无法覆盖全球。数值模式是海洋科学家手中的”望远镜”和”显微镜”。
二、海洋环流模拟:为什么分辨率决定一切
海洋环流是多重时空尺度叠加的复杂系统。大尺度的风生环流和温盐环流以年际到年代际的周期缓慢变化;中尺度涡旋直径在50至300公里之间,生命周期数周至数月;亚中尺度过程则在1至10公里范围内,时间尺度仅数天甚至数小时。这些过程并非孤立存在——亚中尺度锋面不稳定会触发垂向物质交换,将深层营养盐输送至表层,影响海洋生态系统;中尺度涡旋携带的巨大热量则会改变海气界面的能量平衡,进而影响大气环流。
传统的全球海洋模式分辨率多为10至100公里。在这个尺度上,亚中尺度过程完全”不可见”,中尺度涡旋也只能通过参数化方案近似表达。参数化的本质是用统计平均替代真实物理过程,不可避免地带来不确定性和系统性偏差。当模式分辨率提升到1公里时,网格尺度首次小于罗斯贝变形半径(中纬度约20至50公里),这意味着中尺度和部分亚中尺度过程可以被直接解析,而非参数化近似。
分辨率提升的代价是计算量的指数级增长。假设全球海洋模式采用水平均匀网格,从10公里提升到1公里,每个方向的网格点数增加10倍,二维网格总量增加100倍。若同时考虑垂向分层和时间步长的限制,总计算量可能增加两个数量级以上。LICOMK++模式在神威超算上的成功运行,背后是对并行算法、通信优化和混合精度计算的极致打磨。
从数值方法的角度看,海洋环流模式求解的是三维非静力或静力近似下的Navier-Stokes方程组,配合温度、盐度的平流-扩散方程以及连续性方程。时间积分通常采用预测-校正或分裂显式方案,空间离散则有有限差分、有限体积和谱元法等多种选择。每一种方案在精度、稳定性和计算效率之间都有不同的权衡。例如,有限体积法在质量守恒方面表现优异,适合长时间积分的气候模拟;谱元法则在光滑区域能达到指数级收敛,适合高分辨率涡旋解析。
边界条件处理同样关键。真实海岸线复杂曲折,大陆架坡度变化剧烈,如何用阶梯网格或淹没网格(wet/dry)准确表达地形效应,直接影响沿岸流和跨陆架输运的模拟精度。LICOMK++在1公里分辨率下展现出的一个显著优势,正是对复杂地形效应的精准捕捉——在海底峡谷、海山链等区域,精细地形驱动的局地环流与粗分辨率版本相比判若云泥。
三、当AI涌入海洋:参数化替代与数据驱动的双轨突破
海洋模式领域的最新趋势之一,是将人工智能嵌入传统数值框架。AP3ESM模式就采用了AI增强的物理参数化方案,用神经网络学习亚网格尺度的物理过程,替代或辅助传统的经验参数化公式。与纯统计方法不同,这种”物理约束的机器学习”在训练时保留了质量、能量、动量守恒等硬约束,确保AI参数化不会破坏模式的守恒性质。
AI参数化的优势在于适应性。传统参数化方案通常基于简化的理论推导和有限的观测验证,一旦环境条件超出标定范围(如极端气候状态下),方案可靠性会急剧下降。而经过多场景训练的神经网络,理论上能在更广阔的参数空间中保持合理的预测能力。AP3ESM团队报告称,嵌入AI参数化后,模式对中小尺度环流特征的再现能力显著提升,同时计算开销增加有限。
另一个值得关注的方向是大模型在海洋数据分析中的应用。海洋观测和模拟产生的数据量正以PB级增长——仅卫星遥感一项,全球每天产生的海洋相关数据就达到数十TB。面对如此海量的多源异构数据,传统的统计分析方法已经力不从心。大语言模型和多模态AI正在被用于自动化文献综述、实验报告生成、异常检测和跨数据集关联分析。
对于有条件的科研团队,在本地部署中等规模的大语言模型(如14B至30B参数)进行海洋领域知识的问答和辅助写作,已经成为一种实用的工作流。这类任务对显存容量的要求较高——30B模型INT4量化推理至少需要约20GB显存,70B模型则需要40GB以上。这意味着一台配备RTX 5090D 24GB或RTX Pro 5000 48GB的工作站,已经能够支持相当规模的本地AI应用。
此外,AI驱动的资料同化正在改变海洋预报的业务流程。传统同化方法如最优插值、卡尔曼滤波、集合卡尔曼滤波等,计算成本随状态维度线性或超线性增长。基于深度学习的数据驱动同化方法,则有望将同化速度提升一个数量级,使高分辨率模式的实时预报成为可能。
四、主流海洋环流模式软件概览
海洋数值模拟的软件生态经过多年发展,已经形成了覆盖全球、区域和沿岸多个尺度的成熟工具链。
MITgcm(MIT General Circulation Model)是麻省理工学院开发的通用环流模式,以灵活的网格配置和非静力选项著称。它支持从全球到实验室水槽的多尺度模拟,采用有限体积法保证守恒性,在物理海洋学、生物地球化学和冰海耦合领域应用广泛。
ROMS(Regional Ocean Modeling System)是区域海洋模式的代表,采用垂向地形跟随坐标(S-coordinate),在陆架、河口和沿岸区域的模拟中具有天然优势。其开源社区活跃,被全球数百个研究组用于区域海洋动力学、生态系统和沉积物输运研究。
FVCOM(Finite Volume Community Ocean Model)采用非结构化三角形网格,能够灵活拟合复杂海岸线,特别适合近海、海湾和河口的高分辨率模拟。其有限体积求解器在质量守恒和动量守恒方面表现优异。
NEMO(Nucleus for European Modelling of the Ocean)是欧洲主导的通用海洋模式,与大气模式耦合后构成CMIP6的核心贡献模式之一。NEMO采用垂向任意拉格朗日-欧拉坐标(z或s),在全球气候模拟和业务预报中占据重要地位。
POP(Parallel Ocean Program)和MOM(Modular Ocean Model)是美国国家大气研究中心和海洋大气管理局开发的经典全球海洋模式,是早期气候模式耦合系统的核心组成部分。POP的并行设计在超算扩展性方面具有标杆意义。
LICOM(LASG/IAP Climate System Ocean Model)是中国科学院大气物理研究所自主研发的全球海洋环流模式,从LICOM1到LICOM3经历了多次重大升级。LICOMK++作为其最新版本,在神威超算上实现了1公里分辨率的全球模拟,标志着国产海洋模式进入世界最前沿行列。其GPU版本LICOM3-CUDA基于HIP框架开发,为异构计算平台的移植提供了范本。
五、海洋环流模拟的硬件配置推荐
高分辨率海洋环流模拟的硬件需求有其独特之处。这类计算以CPU密集型为主——每个时间步需要遍历全部网格点求解偏微分方程组,时间积分通常是串行依赖的,难以像深度学习那样大规模并行于GPU。但另一方面,内存容量往往是最大的瓶颈:一个1公里分辨率的全球海洋模式,仅三维场变量的存储就需要数百GB甚至TB级别的内存。
基于上述特点,以下四级配置方案面向不同规模和预算的科研需求:
方案A:
适用场景:海洋专业本科教学、小区域理想化实验、模式调试与验证
推荐机型:A350 156128-MCA
- 价格区间:5~6万
- CPU:Intel Ultra9 285K(24核,8P核全核5.6GHz)+水冷(5.6GHz为全核超频实测优化频率,Intel官方单核最高5.7GHz)
- 图形卡:Quadro T400
- 内存:128GB DDR5
- 系统盘:4TB NVMe(14GB/s)
- 推荐理由:128GB内存可支撑中等规模区域模式(如100×100×50层网格)的调试运行,高频CPU适合单线程密集的编译和小规模测试。静音塔式设计适合实验室办公环境。
方案B:
适用场景:区域高分辨率模拟(如中国近海、南海),中长期积分的气候态研究
推荐机型:EX660 227256-MCB
- 价格区间:13~15万
- CPU:2×Xeon金牌6530(64核2.7GHz)+水冷
- 图形卡:Quadro T1000
- 内存:256GB DDR5
- 系统盘:4TB NVMe Gen5
- 推荐理由:双路Xeon提供64个物理核心和良好的MPI扩展性,256GB内存可支持百万至千万量级网格点的区域模式运行。DDR5高带宽有助于缓解内存密集型计算的压力。
方案C:
适用场景:全球中分辨率(1至10公里)海洋环流模拟,多成员集合试验,冰海耦合实验
推荐机型:EA660 234512-MCX
- 价格区间:27~29万
- CPU:2×AMD霄龙9654(192核2.4~3.7GHz)
- GPU:RTX 5080 16GB
- 内存:512GB DDR5
- 系统盘:4TB NVMe Gen5
- 推荐理由:192核AMD霄龙在高度并行的海洋模式积分中展现出色的扩展效率,512GB大内存可支持全球10公里分辨率或区域1公里分辨率的长期积分。RTX 5080可用于模式结果的后处理可视化及LICOM3-CUDA等GPU版本模式的加速测试。
方案D:
适用场景:全球1公里超高分辨率海洋模拟,多模式耦合(海气冰),AI增强参数化的训练与推理
推荐机型:AlphaPro660 241768-MDA
- 价格区间:42~45万
- CPU:2×AMD霄龙9755(256核4.1GHz)
- 图形卡:Quadro T400
- 计算卡:A100 40GB +水冷
- 内存:768GB DDR5
- 系统盘:2TB SSD
- 工作盘:8TB NVMe(14GB/s)
- 数据盘:20TB SATA
- 推荐理由:256核CPU提供顶级的浮点吞吐能力,768GB内存足以支撑全球1公里分辨率海洋模式的核心场存储。A100计算卡兼具FP64双精度算力(9.7 TFLOPS)和大显存,适合运行GPU加速版海洋模式及AI参数化方案的本地训练。双塔式设计和冗余电源保障长时间稳定运行。
六、常见问题FAQ
Q1:海洋环流模拟主要消耗CPU还是GPU资源?
A:传统海洋模式以CPU计算为主,每个时间步的时间积分和物理过程计算具有强串行性,适合多核并行但难以利用GPU的大规模线程并行。不过,近年来LICOM3-CUDA等GPU版本模式已经证明,在特定数值方案下GPU可以带来数倍加速。对于以传统CPU模式为主的用户,应优先投资多核CPU和大内存;若计划尝试GPU加速版本或运行AI参数化训练,则需要配备数据中心级GPU。
Q2:内存容量如何估算?
A:粗略估算公式为:内存需求 ≈ 网格点数 × 垂向层数 × 变量数 × 8字节(双精度)。例如一个全球1度(约360×180水平网格)×50层×10个变量的模式,全部10个三维场约需250MB,考虑多步积分存储和中间变量,总内存需求在数GB量级。但当分辨率提升到0.1度(约3600×1800网格),内存需求立即膨胀到数十GB至百GB量级;1公里分辨率全球网格则轻松突破TB级。
Q3:存储速度对模拟效率影响大吗?
A:对于稳态积分运行,海洋模式主要数据在内存中处理,存储速度直接影响的是结果输出的I/O效率。但在资料同化、集合预报、断点续算等场景下,频繁读写重启文件和观测数据会使高速NVMe存储的优势凸显。建议至少配备4TB以上NVMe SSD作为系统和工作盘,大数据量用户可追加SATA数据盘。
Q4:可以用消费级显卡做海洋模式计算吗?
A:消费级显卡如RTX 4090、RTX 5090的FP32算力很高,但FP64双精度性能仅为FP32的1/64左右。海洋模式通常使用双精度浮点以保证守恒性和数值稳定性,因此消费级显卡在传统海洋模式计算中并不合适。若运行GPU加速版本或AI应用,则消费级显卡可以发挥作用,但需注意显存容量是否满足网格存储需求。
Q5:海洋模式编译和运行对操作系统有特殊要求吗?
A:主流海洋模式均支持Linux系统,部分模式如MITgcm和ROMS也提供macOS支持。生产环境强烈推荐Linux(如Ubuntu、CentOS或Rocky Linux),因为MPI并行库、NetCDF I/O库和HPC编译器在Linux下的优化最为成熟。若使用GPU版本,还需安装对应版本的CUDA或ROCm驱动。
Q6:高分辨率模拟中如何避免数值不稳定?
A:时间步长受CFL条件严格限制,通常与网格尺寸成正比。分辨率提升10倍,时间步长需缩小约10倍,总计算量增加约100倍。此外,高分辨率模式下非线性项增强,易出现虚假振荡。常用的稳定化手段包括:使用ENO/WENO等高精度无振荡格式、增加水平/垂向扩散、采用自适应时间步长策略,以及在关键区域局部加密网格而非全局均匀加密。
七、结语
从10公里到1公里,海洋环流模拟的分辨率跃迁不仅是网格数的简单增加,更是对海洋多尺度动力学理解的一次质的飞跃。LICOMK++和AP3ESM的接连突破证明,中国在超高分辨率海洋模式领域已经站在世界最前沿。而支撑这一切的,是算力的持续升级——从神威超算的千万核心到桌面工作站的数十核心,每一层级的计算资源都在为不同尺度的海洋探索提供可能。
对于准备投身海洋环流模拟的科研团队而言,选择一台与自身研究规模匹配的工作站,是踏入这片深蓝的第一步。分辨率没有尽头,但在力所能及的算力范围内,依然有无数涡旋等待被发现。
如果您有任何配置疑问欢迎加微信沟通~
微信号:maxftxwx












