
2026年3月,度小满与西安交通大学宣布启动AI金融战略合作二期项目。双方在一期合作基础上继续加码资源投入,聚焦风控、智能客服等核心场景的技术转化。度小满CEO朱光公开表示,西安交大在人工智能基础研究上的突破性成果,与度小满在场景、数据和工程能力上的优势形成互补。这个项目的一个细节值得注意:度小满内部的信贷审核流程已全面接入大模型Copilot,单笔审核时间从10分钟压缩到30秒(2025年11月香港金融科技周数据)。这背后不只是大语言模型的功劳,更是一整套信用风险评估与组合优化计算体系在支撑。当算法开始替人做风险判断,算力基础设施的瓶颈便从后台走到了前台。
金融工程领域的信用风险组合优化,本质上是一个高维数值计算问题。一个中型资管机构的持仓可能覆盖上千只债券或信用衍生品,每增加一只标的,协方差矩阵的维度就平方级膨胀。协方差矩阵只是起点。信用风险区别于市场风险的独特之处在于”违约相关性”——两只债券的发行人可能属于同一产业链,一家房企违约会连带触发上下游供应商的信用事件。这种关联结构无法用简单的线性相关刻画,通常需要引入Copula函数(如t-Copula或Clayton Copula)对尾部相关性进行建模。每一次Copula参数估计都需要对历史违约数据进行极大似然优化,而在高维场景下,这个优化本身的计算量就已经不可忽视。
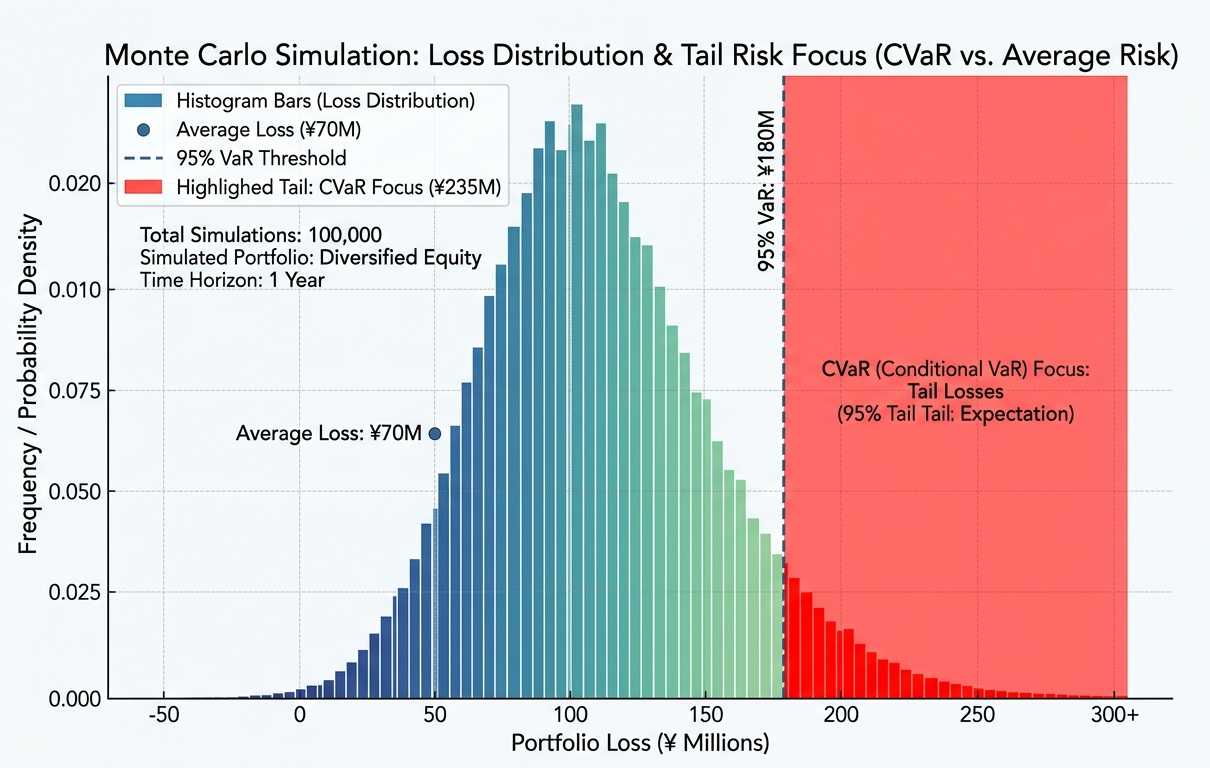
传统的风险价值(Value at Risk,VaR)模型只回答一个问题:在95%或99%置信水平下,明天最大可能亏多少?但VaR的缺陷在金融史上已经反复暴露——它只给出一个阈值,不描述阈值之外的损失分布。2008年雷曼兄弟倒闭后,多家机构发现自己的VaR模型完全低估了尾部风险,因为VaR本身不具有一致性风险度量的数学性质,也不满足次可加性。这意味着分散化投资在VaR框架下可能反而显得风险更高,这与金融常识直接矛盾。
条件风险价值(Conditional Value at Risk,CVaR)正是为填补这个缺口而生。CVaR计算的是损失超过VaR阈值后的平均损失,数学上定义为损失分布尾部在置信水平之上的条件期望。Rockafellar和Uryasev在2000年证明了一个关键结论:CVaR的优化可以转化为线性规划问题,这让大规模组合优化第一次具备了可计算性。但”可计算”不等于”计算快”。对于包含n个资产、置信水平为α的CVaR优化问题,当采用蒙特卡洛模拟生成m条样本路径时,问题规模膨胀到m×n个决策变量和约束条件。假设一个中等规模的信用债组合包含2000只标的,使用10万条蒙特卡洛路径,优化问题的变量数就达到2亿。这个规模已经远远超出了普通笔记本电脑的内存容量,更不用说在合理时间内求解。
优化求解器的选择直接影响计算效率和结果精度。对于中小规模问题(标的数<1000),开源求解器如OSQP和SCS可以在秒级返回结果。但当变量数过亿,商业求解器如Gurobi和CPLEX的稀疏矩阵预处理、对偶间隙收敛控制和并行分枝定界算法才能发挥作用。即便如此,求解时间依然从分钟级延伸到小时级。交替方向乘子法(ADMM)近年来越来越受欢迎,因为它将大规模问题分解为多个可并行求解的子问题,天然适合分布式计算架构。但ADMM的收敛速度对惩罚参数敏感,参数调优本身就是一门手艺。
蒙特卡洛模拟在信用风险计算中的角色不可替代。与历史模拟法不同,蒙特卡洛可以根据预设的违约概率、回收率和相关性结构生成新的市场情景,从而评估极端但尚未发生过的风险事件。每一次模拟路径都需要对组合中每只债券的信用利差、违约时间、回收现金流进行随机抽样和折现计算。对于含有可转债、信用违约互换(CDS)或抵押债务证券(CDO)等复杂结构的组合,单条路径的计算可能涉及嵌套期权定价和多重触发条件判断。当模拟次数达到百万级,总计算量就从”几分钟”变成”几小时”甚至”几天”。
这个计算瓶颈的硬件根源可以拆解为三个层面。第一是内存容量。2000×2000的协方差矩阵以双精度浮点存储,占用约32MB。听起来不大,但蒙特卡洛优化中的系数矩阵规模是路径数乘以资产数,百万路径下就是2000×1,000,000,双精度存储需要约16GB。再加上求解器运行时的临时矩阵、分解因子和迭代向量,实际内存占用轻松突破100GB。如果还要加载历史价格数据、因子暴露矩阵和宏观情景库,256GB内存只是起步。第二是内存带宽。内点法(Interior Point Method)和交替方向乘子法(ADMM)等凸优化求解器的迭代过程中,每次迭代都需要对整个系数矩阵进行矩阵-向量乘法。内存带宽决定了数据从DRAM到CPU的搬运速度,带宽不足时CPU会大量空转。第三是CPU并行效率。蒙特卡洛模拟的每条路径相互独立,天然适合并行。但并行化的效率取决于调度开销、负载均衡和线程同步成本。当路径数极大时,核心数从8核增加到64核,加速比并非线性,但差异仍然显著——在同等频率下,64核处理百万级路径的速度大约是8核的6到8倍。
GPU在信用风险计算中的角色近年来越发重要。传统上,蒙特卡洛路径生成和期权定价被看作CPU的强项,因为分支逻辑复杂、随机数生成需要高质量伪随机数发生器。但现代GPU的通用计算能力已经能够高效处理大量独立路径的并行模拟。一张高端显卡可以同时运行上万个线程,每条线程负责一条蒙特卡洛路径的完整计算。更关键的是,深度学习正在渗透到信用风险建模的各个环节。度小满与西安交大的合作中就包含”推理大模型在风控中的应用”,这意味着违约概率预测、信用评分和异常交易检测都可能采用神经网络。神经网络的训练过程几乎完全依赖GPU的张量核心和显存带宽。从这个角度看,信用风险组合优化已经不再是纯粹的CPU+内存问题,而是一个CPU+GPU+内存+存储的系统性计算挑战。
存储I/O的瓶颈往往被低估。高频信用风险回测需要加载数年甚至数十年的日度或分钟级市场数据,包括债券价格、信用利差、违约事件、宏观指标和财务报表。一个覆盖中国信用债全市场的历史数据库,压缩后也可能达到数TB。当回测策略需要逐日滚动窗口计算时,随机读取速度成为关键。机械硬盘的随机读取延迟在毫秒级,而NVMe SSD的延迟在微秒级,相差两个数量级。对于每天需要读取数万条时间序列的回测任务,这个差距直接决定了”今天能跑完”还是”明天继续等”。
这里需要区分两个场景:回测与组合优化。回测侧重于验证历史策略表现,核心是逐日滚动计算和大量条件分支判断,对单核性能和随机I/O更敏感。组合优化侧重于在给定约束下寻找最优权重,核心是大型矩阵运算和凸优化求解,对多核并行和内存带宽更敏感。一个研究团队通常需要同时处理两类任务:白天用回测验证新策略,夜间用组合优化重新调整持仓。这意味着硬件配置不能只偏向单一维度,需要兼顾CPU单核频率、多核并行、内存容量和存储速度。
理解了这些计算瓶颈,再来看硬件配置,思路就清晰了。下面按个人研究、团队级、机构级和大型资管四个梯度,给出具体的配置方案。需要说明的是,以下所有型号均来自UltraLAB产品目录,参数严格照抄,不做任何自行搭配。
方案A:个人研究员/入门量化
适用场景:单一策略回测、小样本CVaR优化(标的数<500)、学术课题研究、个人因子挖掘。
推荐机型:A350 153128-MCT
- CPU:Intel Core Ultra 7 265K 20核(8P全核5.3GHz)+水冷(产品手册标注为全核超频实测优化频率,Intel官方单核最高睿频为5.5GHz)
- GPU:RTX 5090 v2 24GB
- 内存:128GB DDR5
- 存储:4TB NVMe SSD(产品目录标称14GB/s读取带宽)
20核P核在并行回测中表现足够处理中等规模策略的历史模拟。128GB内存可以支撑约5000×5000的协方差矩阵加上蒙特卡洛优化的临时变量。RTX 5090 v2 24GB的显存可以容纳中小型神经网络(如BERT-base级别的信用文本分析模型),也能加速数万条蒙特卡洛路径的并行模拟。4TB NVMe存储可以容纳约5-8年的日度全市场数据,加上策略中间结果和模型检查点。这个配置的定位是”够做大部分课题,但遇到万级资产组合或百万级蒙特卡洛时需要耐心”。
方案B:量化团队/多策略并行
适用场景:多策略同时回测、中等规模信用组合优化(标的数1000-3000)、机器学习风控模型训练、团队共享计算节点。
推荐机型:GR450P 150128-MCX
- CPU:AMD锐龙TR 7970X 32核5.0GHz+水冷(产品手册标注为全核超频实测优化频率,AMD官方基础频率需核实)
- GPU:RTX 5080 16GB
- 内存:128GB DDR5
- 存储:4TB NVMe SSD
32核5.0GHz的配置在多策略并行回测中优势明显。假设团队同时运行4-6个策略,每个策略分配4-6核,调度开销仍在可控范围。128GB内存在这个级别略显紧凑,对于3000只标的、10万条蒙特卡洛路径的CVaR优化,可能需要将问题分块求解(Block Decomposition),牺牲部分求解速度换取内存够用。RTX 5090D v2 24GB与方案A的GPU相同,但对于多策略场景,GPU可以专门用于神经网络训练,CPU负责回测和优化,两者并行不冲突。存储方案与方案A一致,团队级场景下建议通过NAS扩展历史数据存储。
方案C:机构风控/大规模组合优化
适用场景:全市场信用债组合优化(标的数>5000)、百万级蒙特卡洛CVaR计算、实时风险监控、大规模机器学习模型训练。
推荐机型:EX660 229512-MDT
- CPU:2×Xeon Platinum 8592+ 128核2.9GHz+水冷(产品手册标注为全核超频实测优化频率,Intel官方基础频率需核实)
- 内存:512GB DDR5
- GPU:RTX 4090 48G
- 存储:8TB NVMe Gen5(产品目录标称14GB/s读取带宽)
128核双路Xeon平台是大型数值优化的经典选择。512GB内存可以一次性加载10000×100000规模的蒙特卡洛优化矩阵,无需分块,直接调用商业求解器(如Gurobi、CPLEX或开源的SCS、OSQP)进行全量求解。8TB NVMe存储在读取日度全市场数据时,I/O等待时间几乎消失。RTX 5090 32G的显存比方案A/B的24GB版本多出8GB,对于Transformer级别的信用风险文本分析模型或图神经网络(GNN)处理企业关联网络时,这8GB是”能跑”和”跑崩”的分界线。2.9GHz的基础频率在单线程随机数生成和串行预处理时略显保守,但128核的并行吞吐量在蒙特卡洛模拟中完全弥补了这一短板。
方案D:大型资管/全天候风险中枢
适用场景:多资产类别联合风险建模(信用债+股票+衍生品+商品)、实时组合再优化、深度学习大规模训练、多用户并发访问。
推荐机型:AlphaPro660 345640-MDT
- CPU:2×AMD霄龙9575F 128核4.5GHz(产品手册标注为全核超频实测优化频率,AMD官方基础频率需核实)
- 内存:640GB DDR5
- GPU:RTX 4090 48G
- 存储:8TB NVMe(产品目录标称14GB/s读取带宽)+20TB SATA(如需扩展存储另配HDD)
128核4.5GHz的AMD霄龙平台在频率上明显优于方案C的2.9GHz Intel Xeon,对于混合负载(既有并行蒙特卡洛又有单线程数据预处理)更为均衡。640GB内存足以支撑多资产联合优化的超大规模矩阵,或者同时运行多个独立优化任务而不互相挤占内存。RTX 4090 48G的显存是全线最高的消费级配置,对于多模态信用风险模型(如同时处理企业财报文本、供应链图谱和宏观时间序列的融合模型)提供了充足的显存空间。8TB+20TB的存储组合中,8TB NVMe用于活跃数据和热回测,20TB SATA用于归档历史数据。这个配置的定位是”一个房间里的小型计算中心”,可以支撑一个10-20人的量化团队日常运转。
回到度小满与西安交大的合作。当信贷审核从10分钟压缩到30秒,当违约风险识别率提升50%,这些数字的背后是计算架构的质变。CVaR优化从学术模型变成生产线工具,蒙特卡洛模拟从夜间跑批变成准实时响应,这中间的每一步都需要硬件的承接。西安交通大学作为国内金融工程学科的重要阵地,长期深耕量化金融与风险管理领域,从早期的指数型基金优化复制策略到如今的AI驱动风控,研究方向的演进始终与计算能力的提升同步。金融工程的本质是算力与算法的硬碰硬。选错配置的后果不是慢一点,而是模型根本跑不完。
微信号:maxftxwx












