
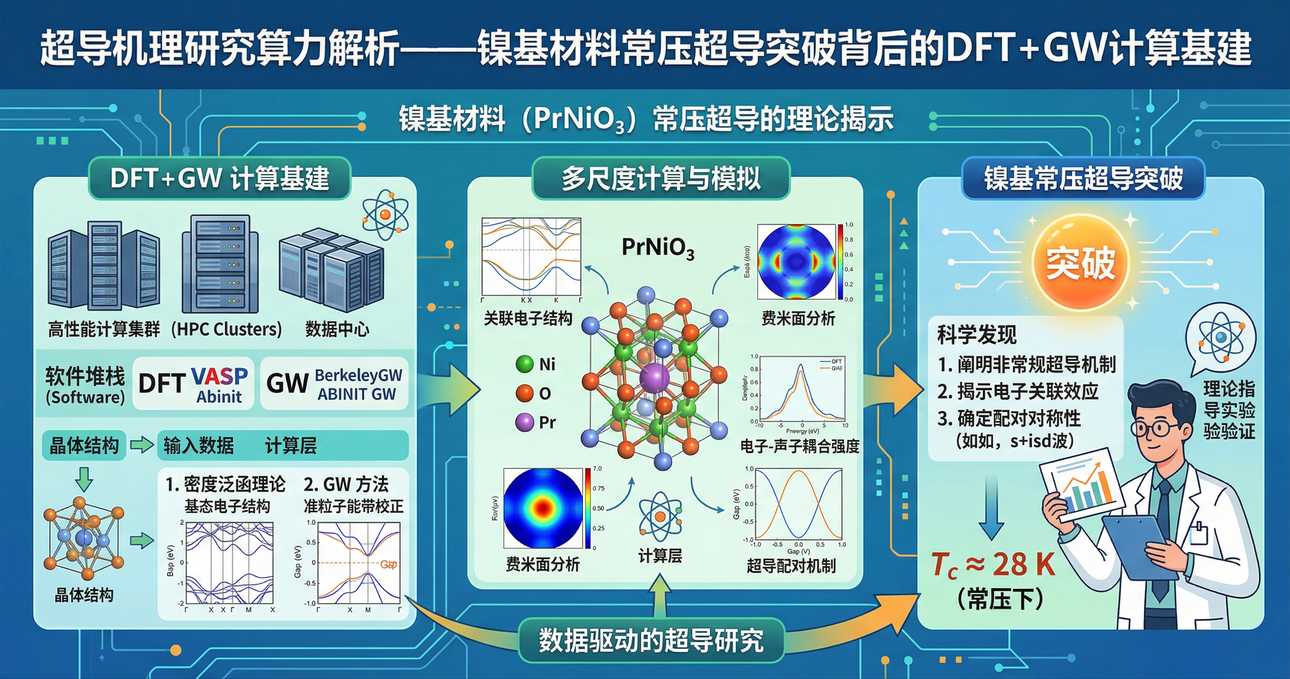
摘要:2025年2月,清华大学联合团队在国际顶刊《自然》发表重大突破:在常压下实现镍氧化物材料的高温超导电性。这一发现使镍基材料成为继铜基、铁基之后第三类突破”麦克米兰极限”的高温超导体系。本文从计算物理视角切入,深入解析支撑这类前沿研究的DFT(密度泛函理论)与GW近似算法本质,梳理拓扑材料电子结构计算的硬件瓶颈,并提供从单点验证到高通量筛选的四级算力配置方案。
一、引言:当”零电阻跑车”突破常压禁区
2025年2月18日,一条消息在凝聚态物理圈炸开了锅。
薛其坤院士与陈卓昱副教授领衔的南方科技大学、粤港澳大湾区量子科学中心与清华大学联合研究团队宣布:在常压环境下实现双层镍酸盐(bilayer nickelate)薄膜的高温超导电性。该材料(La₂.₈₅Pr₀.₁₅Ni₂O₇)的超导起始转变温度(onset Tc)达到45K(约零下228℃),突破了40K的”麦克米兰极限”,并观测到”零电阻”和”抗磁性”的双重特征。
这项发表在《自然》杂志的成果意味着什么?
自1911年超导现象被发现以来,科学家追逐了114年的”圣杯”——在常压下实现高于液氮温度(77K)的超导。1986年铜氧化物、2008年铁基材料相继突破40K的”麦克米兰极限”,但都需要高压环境或复杂制备工艺。而这一次,镍基材料在常压下就做到了。
关键科学事实澄清:
- 起始转变温度(onset Tc):45K——电阻开始下降的温度
- 零电阻转变温度(TBKT):约9K——完全进入零电阻状态的温度,表现出Berezinskii-Kosterlitz-Thouless(BKT)类行为
- 迈斯纳温度(TM):约8K——观测到迈斯纳抗磁效应的温度
这三个温度的区分至关重要:45K是超导开始发生的温度,但完全零电阻和完全抗磁要到约8-9K才实现。
更令人瞩目的是研究团队采用的”强氧化原子逐层外延(GOALL-Epitaxy)”技术——在氧化能力比传统方法强上万倍的条件下,依然实现原子层的逐层生长,如同在纳米尺度上”搭原子积木”。团队成功制备了**三个晶胞厚(three-unit-cell, 3UC)**的超薄薄膜,这种对材料原子级精度的控制,正是计算物理与实验物理深度耦合的产物。
作为一个长期关注材料计算领域的观察者,我注意到一个细节:这项突破的背后,是海量DFT计算对候选材料的预筛选,是GW近似对电子关联效应的精确刻画,是高通量计算对晶体结构的系统优化。
今天这篇,就聊聊支撑这类顶尖超导研究的算力基建——从算法本质到硬件配置,给你一个完整的决策地图。
二、超导机理:为什么计算物理不可或缺
2.1 高温超导:物理学界的”量子迷宫”
高温超导机理被公认为凝聚态物理最具挑战性的难题之一,甚至连诺贝尔物理学奖得主都承认这个领域仍处于”盲人摸象”阶段。
核心难点在于电子关联:传统金属中,电子可以近似看作独立运动的粒子;但在铜基、铁基、镍基等高温超导体中,电子之间存在强烈的库仑相互作用,导致集体激发、自旋涨落等复杂现象。这些关联效应无法通过简单的平均场理论描述。
计算物理的作用体现在三个层面:
- 材料预筛选:在海量候选材料中,通过DFT计算快速评估能带结构、费米面拓扑,缩小实验探索范围
- 机理验证:通过GW近似、DMFT(动态平均场理论)等方法,验证超导配对对称性、计算临界温度
- 结构优化:预测最优掺杂浓度、晶格常数、原子占位,指导实验制备
2.2 从铜基到镍基:三代高温超导的计算演进
| 材料体系 | 发现时间 | 最高Tc | 计算特点 |
|---|---|---|---|
| 铜氧化物 | 1986年 | 134K(高压) | 强关联Hubbard模型,DMFT为主 |
| 铁基材料 | 2008年 | 55K | 多轨道模型,DFT+U广泛应用 |
| 镍基材料 | 2019/2025年 | 45K(常压) | 轨道选择性关联,GW+DMFT结合 |
清华团队的镍基突破,标志着计算物理方法论的又一次升级:传统的DFT+U已经不足以描述镍氧化物的复杂关联,必须引入更精确的GW近似和量子嵌入理论。
三、算法本质:DFT与GW近似的”显微镜”之争
3.1 DFT:材料计算的”瑞士军刀”
**密度泛函理论(Density Functional Theory, DFT)**是现代材料计算的基石。1964年Kohn-Sham定理证明了电子系统的基态能量可以表示为电子密度的泛函,从而将多体问题转化为单电子方程。
VASP、Quantum ESPRESSO、ABACUS等主流软件都基于DFT框架。在拓扑材料和超导研究中,DFT主要用于:
- 能带结构计算:确定价带顶、导带底位置,计算带隙
- 费米面分析:识别拓扑表面态、狄拉克锥、外尔点
- 声子谱计算:评估晶格动力学稳定性,计算电声耦合
DFT的优势:计算效率高,可以处理数百原子的体系;局限:传统泛函(LDA/GGA)会系统性低估带隙,对强关联体系描述不准。
3.2 GW近似:准粒子能带的”精密手术刀”
GW近似(得名于自能表达式Σ = iGW)是超越DFT的准粒子计算方法。它通过Hedin方程迭代求解单粒子格林函数,可以更准确地描述电子关联效应。
在拓扑材料研究中,GW至关重要:
- 拓扑不变量的计算依赖于精确的能带顺序
- DFT可能错误预测某些材料是否为拓扑绝缘体
- GW修正后的带隙通常更接近实验值
但GW的代价是恐怖的:
- 计算复杂度为O(N⁴)到O(N⁶)(N为电子数)
- 内存需求随体系大小急剧增长
- 一个100原子体系的GW计算可能需要数千CPU核时
3.3 算法对比:精度与效率的永恒权衡
| 方法 | 计算成本 | 带隙精度 | 适用场景 |
|---|---|---|---|
| DFT-LDA/GGA | ★☆☆☆☆ | 偏低30-50% | 大体系初筛、几何优化 |
| DFT-HSE06 | ★★☆☆☆ | 中等 | 中等体系能带计算 |
| G₀W₀@DFT | ★★★☆☆ | 较好 | 标准GW计算 |
| scGW/selfCOHSEX | ★★★★☆ | 优秀 | 强关联体系 |
| GW+DMFT | ★★★★★ | 最高 | 高温超导机理研究 |
清华团队的镍基超导研究,根据公开发表的论文(作者:周光地、吕伟等,通讯作者:薛其坤、陈卓昱)推测,很可能采用了DFT+GW+DMFT的多层级计算策略:先用DFT确定晶体结构,再用GW修正单粒子能带,最后用DMFT处理强关联效应。
四、拓扑材料电子结构:计算的”硬骨头”
4.1 为什么拓扑材料特别”吃”算力?
拓扑绝缘体、外尔半金属、拓扑超导体等新型量子材料,对计算精度有极高要求:
1. 能带反转的精准识别
拓扑不变量(Z₂不变量、陈数)的计算依赖于对能带顺序的精确判断。DFT-LDA可能将拓扑绝缘体误判为普通绝缘体,或将普通绝缘体误判为拓扑绝缘体。
2. 自旋-轨道耦合(SOC)必须考虑
重元素(Bi、Sb、Te等)的拓扑材料必须包含相对论效应。SOC计算会使哈密顿量维度翻倍,计算成本增加4-8倍。
3. 表面态计算需要超胞
研究拓扑表面态需要构建 slab 模型(几十层原子),体系尺寸是普通体材料计算的10倍以上。
4.2 典型计算任务的资源需求
| 计算任务 | 原子数 | K点网格 | 计算时长 | 推荐配置 |
|---|---|---|---|---|
| 单点能计算 | 50-100 | 8×8×8 | 数小时 | 单节点工作站 |
| 能带结构 | 50-100 | 密集K路径 | 1-2天 | 单节点工作站 |
| 声子谱计算 | 50-100 | 4×4×4 | 3-7天 | 小集群 |
| GW准粒子能带 | 50 | Γ点 | 1-3天 | 中大内存节点 |
| GW准粒子能带 | 100 | 多个K点 | 1-4周 | 计算集群 |
| 高通量筛选 | 1000+结构 | 自动优化 | 数月 | GPU集群 |
五、四级算力配置方案
基于与多位计算材料学研究者的交流,以及公开论文中的计算规模参考,我整理出以下四级配置方案:
5.1 入门级:本科生/研一教学验证
适用场景:学习VASP/Quantum ESPRESSO基本操作,小体系(<50原子)单点能计算
| 部件 | 推荐配置 | 说明 |
|---|---|---|
| CPU | AMD Ryzen 9 9950X (16核32线程) | Zen 5架构,高主频利于K点并行 |
| 内存 | 128GB DDR5-5600 | DFT计算对内存容量敏感 |
| 存储 | 2TB NVMe SSD + 4TB HDD | 系统+软件,数据归档 |
| 显卡 | RTX 4070 Ti SUPER 16GB | 可选,用于可视化 |
| 网络 | 千兆以太网 | 单机使用 |
软件配置:VASP(学术授权)、Quantum ESPRESSO(开源)、ASE(自动化脚本)
性能预期:50原子体系的DFT自洽场计算约2-4小时完成
5.2 进阶级:博士生/课题组主力
适用场景:100-200原子体系能带计算、声子谱、简单的GW计算
| 部件 | 推荐配置 | 说明 |
|---|---|---|
| CPU | AMD Threadripper 7970X (32核64线程) | 四通道DDR5,大内存带宽 |
| 内存 | 256GB DDR5-4800 (ECC) | ECC纠错防止长时间计算崩溃 |
| 存储 | 4TB NVMe SSD (企业级) + 16TB HDD RAID | 高速缓存+大容量存储 |
| 显卡 | RTX 4090 24GB | 部分DFT软件支持GPU加速 |
| 网络 | 万兆以太网 | 与集群数据交换 |
关键考量:
- 内存带宽:Threadripper的四通道DDR5提供约150GB/s带宽,对平面波基组计算至关重要
- ECC内存:长时间计算中,内存错误可能导致结果 silently wrong
性能预期:100原子体系的HSE06能带计算约1-2天;G₀W₀计算约3-5天
5.3 专家级:GW近似/高通量计算专用服务器
适用场景:GW准粒子能带计算、拓扑不变量批量计算、材料数据库构建
| 部件 | 推荐配置 | 说明 |
|---|---|---|
| CPU | 2× AMD EPYC 9655 (96核192线程) | 双路Zen 5,12通道内存/路 |
| 内存 | 1.5TB DDR5-4800 (24×64GB) | 24通道配置,理论带宽>900GB/s |
| 存储 | 8TB NVMe SSD (U.2企业级) + 40TB HDD RAID6 | 高IOPS+大容量 |
| 网络 | 25GbE + InfiniBand HDR (可选) | 与超算集群互联 |
| 机箱 | 4U机架式 | N+1冗余电源 |
关键考量:
- 内存容量:GW计算对内存的需求近似为O(N²),100原子体系可能需要500GB+内存
- 内存带宽:双路EPYC的12通道×2配置,提供近1TB/s的理论带宽
- 网络:如需对接校超算或国家超算,建议配置InfiniBand
性能预期:100原子体系的scGW计算约1周;支持同时运行4-6个中等规模DFT任务
5.4 集群级:国家级项目/材料基因组计划
适用场景:高通量材料筛选(Materials Project规模)、机器学习势训练、超大规模GW+DMFT
| 部件 | 推荐配置 | 说明 |
|---|---|---|
| 计算节点 | 10-50× 双路EPYC 9965 | 每节点192核384线程 |
| 内存/节点 | 2TB-3TB DDR5 | 大内存节点应对GW计算 |
| 存储 | 并行文件系统 (Lustre/BeeGFS) | 100TB+,带宽>10GB/s |
| 网络 | InfiniBand NDR 400Gbps | 低延迟MPI通信 |
| 管理节点 | 独立登录/调度节点 | Slurm作业调度 |
软件栈:VASP(多授权)、Wannier90、BerkeleyGW、Abinit、AiiDA工作流管理
性能预期:支持每日完成数百个DFT计算,可开展材料基因组级别的高通量筛选
六、避坑指南:来自前线的七条血泪教训
6.1 K点收敛测试:别信”经验值”
坑:很多初学者直接使用文献中的K点网格,或者凭感觉设置。
教训:不同材料、不同性质对K点收敛性要求差异巨大。金属体系通常需要更密的K点网格(12×12×12以上),而绝缘体可以稀疏一些。
建议:正式计算前,务必做K点收敛测试,绘制能量/带隙随K点密度的变化曲线。
6.2 截断能与赝势:匹配的学问
坑:使用高精度截断能但配低精度赝势,或者反过来。
教训:VASP的PBE赝势有多个版本(标准、硬、软),截断能必须与赝势推荐值匹配。过高的截断能不会提高精度,只会浪费算力。
建议:查阅VASP官网的截断能推荐表,或参考Materials Project的统一参数。
6.3 磁矩初始化:拓扑材料的陷阱
坑:磁性拓扑材料计算中,使用默认的磁矩初始值,导致收敛到错误的磁基态。
教训:很多拓扑绝缘体(如Cr掺杂的Bi₂Se₃)具有复杂的磁序。错误的磁矩初始化可能导致计算”伪收敛”到亚稳态。
建议:对磁性体系,先进行自旋极化测试,尝试不同的磁矩初始方向。
6.4 GW计算:内存是天花板
坑:计划做GW计算,但配置的内存不足,导致计算中途OOM被杀。
教训:GW计算内存需求可以用经验公式估算:Memory(GB) ≈ 0.1 × N_elec²,其中N_elec是价电子数。100原子体系可能需要500GB-1TB内存。
建议:GW计算前先用小规模测试估算内存需求,或直接选用大内存服务器配置。
6.5 软件授权:隐形成本
坑:只考虑了硬件成本,忽略了VASP商业授权费用。
教训:VASP学术授权约3000-5000欧元(视版本而定),商业授权更贵。如果课题组多人使用,还需考虑并行授权数量。
建议:预算紧张时,可先用Quantum ESPRESSO(开源)或ABACUS(国产开源)替代;如需VASP,提前与软件商沟通学术授权优惠。
6.6 存储I/O:被忽视的瓶颈
坑:配置了强大的CPU和内存,但使用机械硬盘存储,导致大型计算频繁等待I/O。
教训:DFT计算会产生大量临时文件(波函数、密度矩阵等)。对于100原子以上的体系,一次计算可能产生数百GB的中间文件。
建议:工作目录必须放在NVMe SSD上;定期清理WAVECAR、CHG等中间文件;考虑配置RAID 0提升并行I/O性能。
6.7 超算还是本地:算笔经济账
坑:盲目追求本地服务器,忽略了校超算或国家超算的性价比。
教训:一个双路EPYC专家级服务器成本约20-30万元,每年电费+维护约2-3万元。而国家超算(如天河、太湖之光)的机时费用约0.1-0.5元/核时。
建议:计算量<10万核时/年,本地工作站更划算;计算量>100万核时/年,超算更经济;中间地带需具体分析。
七、前沿展望:AI+DFT的新纪元
值得一提的是,清华大学徐勇、段文晖团队在2022-2024年间连续发表多篇Nature Computational Science论文,提出了**DeepH(Deep DFT Hamiltonian)**系列算法。
这套方法的核心思想是:利用深度学习模型,从小体系DFT数据中学习电子结构的局域规律,然后泛化到大规模体系。
根据公开报道,DeepH方法相比传统DFT加速了3-5个数量级,在保持亚毫电子伏精度的同时,可以处理包含上万原子的魔角石墨烯超胞。
这对拓扑材料研究意味着什么?
- 高通量筛选:可以遍历整个材料空间寻找拓扑不变量非零的候选
- 大尺寸超胞:可以研究拓扑表面态、缺陷态、摩尔超晶格等复杂体系
- 实时优化:结合主动学习,可以边计算边筛选最优结构
如果这类AI+DFT方法能够成熟普及,未来的拓扑材料计算或许不再需要动辄千万级的超算集群,一台配备高端GPU的工作站就能完成曾经需要国家级超算的任务。
八、结语:算力是探索量子世界的显微镜
回到2025年2月的那场突破。
薛其坤院士、陈卓昱副教授团队(第一作者周光地等)在《自然》发表的镍基超导成果,不仅是实验技术的胜利,更是计算物理与实验物理深度协同的典范。从候选材料的DFT预筛选,到电子结构的GW精确计算,再到强关联效应的DMFT分析——每一步都离不开强大的算力支撑。
对于正在规划课题组算力基建的研究者来说,记住几条原则:
- 先明确需求:是做小体系教学验证,还是大规模高通量筛选?
- 内存是刚需:DFT和GW都是内存密集型任务,宁大勿小
- 软件成本纳入预算:VASP授权、集群管理软件都是隐形成本
- 考虑超算选项:计算量大时,国家超算的性价比可能更高
- 关注AI+DFT进展:DeepH等方法可能在未来3-5年改变游戏规则
高温超导的”圣杯”还未完全到手,但镍基材料的常压突破让我们看到了曙光。而在这条探索之路上,算力基建就是研究者手中最可靠的显微镜——它帮我们看清电子的舞蹈,预测材料的未来,最终在量子迷宫中找到那条通往零电阻的道路。
免责声明:本文采用产业观察视角进行技术分析,文中提及的清华大学相关院系及研究成果均来自公开资料,不代表官方立场。文中硬件配置建议仅供参考,实际采购请根据具体需求评估。
分类标签:凝聚态物理、高温超导、拓扑材料、密度泛函理论、GW近似、计算材料学、硬件配置 技术标签:DFT、GW近似、VASP、Quantum ESPRESSO、拓扑绝缘体、镍基超导、Threadripper、EPYC、高性能计算、材料基因组、DeepH、AI for Science












