
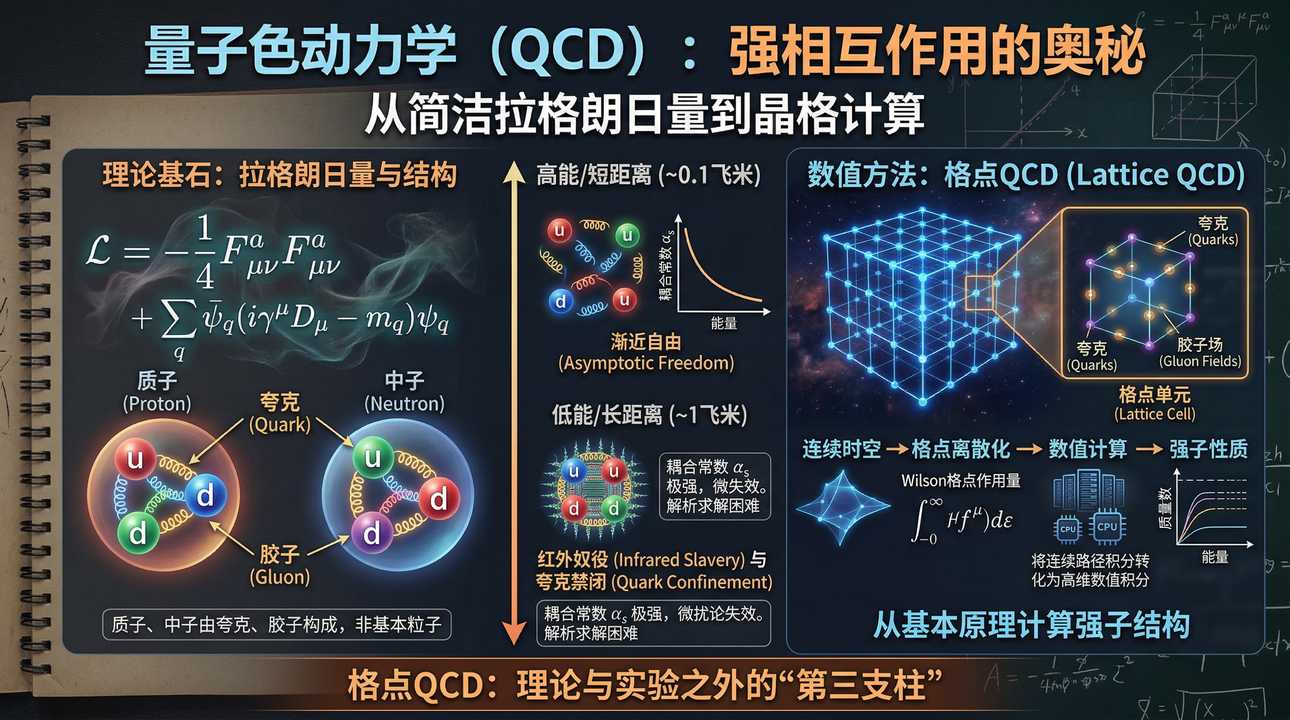
摘要:2025年7月,LHCb国际合作组(中国团队由北京大学、清华大学、中国科学院大学、华中师范大学等共同参与)首次发现重子衰变中的CP破坏现象,填补了粒子物理标准模型的关键拼图。这一突破不仅依赖于对撞机实验,更离不开格点QCD(量子色动力学)计算对强子矩阵元的精确预言。本文从这一重大成果切入,深入解析格点QCD的蒙特卡洛模拟与张量网络算法本质,梳理高能物理计算的硬件瓶颈,并提供从教学验证到E级计算的四级算力配置方案。
一、引言:当重子CP破坏照亮新物理之路
2025年7月16日,国际粒子物理界迎来了一个里程碑时刻。
LHCb中国研究团队(由北京大学、清华大学、中国科学院大学、华中师范大学等联合组成)与国际合作者一道,在大型强子对撞机底夸克实验(LHCb)中首次观测到重子衰变中的CP破坏现象。这一发现填补了CP破坏研究的关键空白,为理解宇宙中正反物质不对称性起源提供了重要线索。
CP破坏——即电荷共轭(C)与宇称(P)联合对称性的破坏——是粒子物理最核心的课题之一。1964年,科学家首次在中性K介子衰变中发现CP破坏;2001年,B介子中的CP破坏被观测到。但重子(由三个夸克组成的粒子,如质子、中子)中的CP破坏一直未被实验证实,成为标准模型检验的关键缺失环节。
该论文第一作者为北京大学博士研究生杨雪婷,核心研究团队包括北京大学张艳席助理教授、高原宁院士、杨振伟教授,以及清华大学工物系张黎明副教授课题组联合指导的博士后戴鑫琛等。戴鑫琛开展了先期信号筛选与本底研究,研究了该衰变的振幅模型,并参与撰写了成果论文。中国团队在这一发现中发挥了重要作用。
作为一个关注高能物理计算的研究者,我注意到一个深层事实:这一实验突破的背后,是海量格点QCD计算对强子衰变矩阵元的精确预言。从实验信号的本底估计,到理论预言的对比验证,格点QCD计算贯穿始终。
今天这篇,就从这一重大发现切入,聊聊支撑顶尖高能物理研究的算力基建——从蒙特卡洛模拟到张量网络算法,从台式工作站到E级超级计算机。
二、格点QCD:连接夸克与强子的计算桥梁
2.1 为什么需要格点QCD?
量子色动力学(QCD)是描述强相互作用的基本理论。它告诉我们,质子和中子并非基本粒子,而是由更基本的夸克和胶子构成。但有一个悖论:
QCD的拉格朗日量极其简洁,却无法在解析上求解低能强子性质。
原因在于渐近自由与红外奴役的反差:在高能区(短距离),夸克-胶子耦合常数很小,可以用微扰论;但在低能区(长距离,~1飞米),耦合常数变得极强,微扰论完全失效。夸克被”禁闭”在强子内部,永远无法被单独观测。
格点QCD是解决这个问题的基础方法。1974年,Kenneth Wilson提出将连续时空离散化为四维超立方体格点,用数值方法计算路径积分。经过近50年发展,格点QCD已成为与理论和实验并列的**”第三支柱”**。
2.2 格点QCD在LHC实验中的关键作用
回到2025年7月的CP破坏发现。为什么格点QCD如此重要?
在重子Λ_b⁰ → pK⁻π⁺π⁻衰变中,实验测量的是衰变振幅。这个振幅包含两部分:
- 弱相互作用部分:可以通过微扰计算
- 强相互作用部分:涉及非微扰QCD效应,必须从格点QCD获取
格点QCD计算提供的是强子矩阵元(form factors)、衰变常数、B介子混合参数等关键输入。没有这些计算,实验测得的CP破坏效应无法与标准模型预言进行精确对比,也就无法判断是否存在新物理。
三、算法本质:蒙特卡洛与张量网络的”双轨制”
3.1 蒙特卡洛模拟:格点QCD的”老黄牛”
格点QCD计算分为两个核心步骤:
第一步:组态生成(Configuration Generation)
通过蒙特卡洛方法生成服从玻尔兹曼分布的规范场组态:P[Uμ]=Z1exp(−SE[Uμ])detM[Uμ]
这是整个计算中最耗时的部分。**混合蒙特卡洛算法(HMC, Hybrid Monte Carlo)**是主流方法:
- 引入共轭动量:为每个规范场链变量引入虚构的动量场
- 分子动力学演化:按照哈密顿方程演化场和动量(蛙跳积分器)
- Metropolis接受-拒绝:根据能量变化决定是否接受新组态
关键难点:
- 费米子行列式计算:需要求解大型稀疏线性系统(Wilson-Dirac方程),使用CG(共轭梯度)或MG(多重网格)算法
- 临界慢化:在相变点附近,自关联时间急剧增加,需要更长的热化
- 连续极限外推:格点间距a→0时,计算成本按O(a⁻⁶)到O(a⁻⁸)增长
第二步:物理量测量(Measurement)
在生成的组态上计算关联函数,提取质量、衰变常数等物理量。
3.2 张量网络:突破符号问题的新希望
蒙特卡洛方法有一个致命弱点:符号问题(Sign Problem)。
当研究有限密度QCD(重子化学势μ≠0)或包含θ项的拓扑效应时,作用量出现虚部,概率分布不再是实数正定的。传统的Importance Sampling失效,计算复杂度指数爆炸。
**张量网络方法(Tensor Network)**提供了新的可能性:
Grassmann张量重整化群(GTRG):
- 将路径积分表示为张量网络形式
- 通过张量收缩(renormalization group)计算配分函数和可观测量
- 确定性算法,不受符号问题影响
高阶张量重整化群(GHOTRG):
- 适用于高维系统(3D/4D)
- 通过高阶正交迭代(HOOI)算法压缩张量维度
- 已应用于U(1)、SU(2)规范理论
当前局限:
- 4D非阿贝尔QCD的张量网络表示仍是开放问题
- 张量维数(bond dimension)随系统尺寸指数增长
- 计算成本集中在张量收缩,需要高度优化的并行算法
3.3 算法对比:精度、成本与适用域
| 方法 | 适用场景 | 计算成本 | 符号问题 | 并行性 |
|---|---|---|---|---|
| HMC蒙特卡洛 | 零密度QCD、热QCD | O(10⁶)核时/组态 | 有(μ≠0时) | 中等(需全局同步) |
| 张量重整化群(TRG) | 2D模型、统计物理 | O(D⁶)(D为bond维数) | 无 | 高(张量收缩可并行) |
| Grassmann TRG | 含费米子格点场论 | 更高 | 无 | 中高 |
| 机器学习采样 | 组态生成加速 | 训练成本高 | 研究阶段 | 高 |
四、行业痛点:为什么格点QCD如此”吃”算力?
4.1 规模诅咒:连续极限的昂贵代价
格点QCD计算必须在有限格点间距a下进行,然后外推到a→0的连续极限。
离散化误差:物理量展开为a的幂级数M(a)=M(0)+c1a+c2a2+⋯
为了得到可靠的连续极限外推,通常需要3-4个不同a值的计算(如a≈0.15, 0.10, 0.07, 0.05 fm)。
计算成本缩放(经验规律):
- 固定物理体积,格点间距减半 → 格点数量增加16倍(4D)
- 临界慢化导致自关联时间增加 → 需要更多HMC轨迹
- 费米子矩阵条件数恶化 → CG迭代次数增加
- 总成本约增加50-100倍
4.2 费米子挑战:海夸克的昂贵代价
早期格点QCD采用淬火近似(quenched approximation):忽略海夸克对(费米子行列式设为1)。但这与真实QCD有系统性偏差。
动态费米子计算必须考虑:
- 费米子行列式:det(M),其中M是Wilson-Dirac矩阵(数百万×数百万)
- 伪费米子场:引入辅助场将行列式表示为高斯积分
- 力计算:每个HMC步骤需要计算∂S/∂U,涉及M⁻¹与多个向量的乘法
计算资源消耗:
- 轻夸克(u/d)质量越小,条件数越差,CG迭代越多
- 物理点(physical pion mass)计算比非物理点昂贵10-100倍
- 2+1味(u/d+s)或2+1+1味(u/d+s+c)需要更多计算
4.3 数据洪流:组态存储与分析
一个典型的格点QCD计算会产生PB级数据:
- 原始组态:单个组态文件大小从几百MB到几十GB(取决于格点体积和精度)
- 组态数量:一个完整的研究可能需要数千到数万个组态
- 传播子计算:每个组态上计算多个夸克传播子,存储需求增加10-100倍
- ILDG(International Lattice Data Grid):全球格点合作组共享组态数据,需要高效的存储和网络基础设施
五、四级算力配置方案
基于与格点QCD研究者的交流,以及美国DOE核物理Exascale计算需求报告,我整理出以下四级配置方案:
5.1 入门级:教学验证与算法学习
适用场景:学习格点QCD基本原理,运行简化的2D U(1)模型或小规模3D Ising模型
| 部件 | 推荐配置 | 说明 |
|---|---|---|
| CPU | AMD Ryzen 9 9950X (16核32线程) 或 Intel Core i9-14900K | 高主频有利于标量代码 |
| 内存 | 64GB DDR5-5600 | 小规模计算足够 |
| 存储 | 1TB NVMe SSD | 快速I/O |
| 显卡 | RTX 4070 12GB(可选) | 部分代码支持CUDA加速 |
| 软件 | QCDLAB(教学用Octave/Matlab代码)、Chroma(简化编译) | 学习HMC算法原理 |
性能预期:
- 可运行8³×16格点的U(1)模型HMC模拟
- 适合理解算法流程,不适合科研级计算
5.2 进阶级:博士研究与中小规模计算
适用场景:32³×64或48³×96格点的2+1味QCD,热化与测量
| 部件 | 推荐配置 | 说明 |
|---|---|---|
| CPU | AMD Threadripper 7970X (32核64线程) | 四通道DDR5,大内存带宽 |
| 内存 | 256GB DDR5-4800 (ECC) | 中等规模组态存储与计算 |
| 存储 | 4TB NVMe SSD (企业级) + 16TB HDD | 组态缓存与归档 |
| 网络 | 万兆以太网 | 与校超算数据交换 |
| 软件 | Chroma、Grid、tmLQCD、MILC | 主流格点QCD代码 |
关键考量:
- 内存带宽:HMC算法中,CG求解器是内存密集型,需要高带宽
- 编译优化:使用AVX-512指令集可提升2-3倍性能
- 并行策略:OpenMP并行(单节点)或MPI(多节点)
性能预期:
- 可生成物理点2+1味组态(较粗格点)
- 单组态生成时间数小时到数天
- 适合中等规模科研项目
5.3 专家级:物理点计算与大规模分析
适用场景:64³×128或96³×192格点的大体积计算,接近连续极限
| 部件 | 推荐配置 | 说明 |
|---|---|---|
| CPU | 2× AMD EPYC 9755 (64核128线程) | 双路Zen 5,12通道/路 |
| 内存 | 1TB-2TB DDR5-4800 (ECC REG) | 大内存应对传播子计算 |
| 加速卡 | 2-4× NVIDIA A100 40GB/80GB | GPU加速CG求解器 |
| 存储 | 8TB NVMe SSD (U.2) + 40TB RAID6 | 大容量组态存储 |
| 网络 | 25GbE 或 InfiniBand HDR | 与超算集群互联 |
| 机箱 | 4U机架式 | 企业级电源与散热 |
关键考量:
- GPU加速:现代格点QCD代码(如Grid)支持CUDA,A100可加速CG求解5-10倍
- 内存容量:大体积计算中,传播子存储需要数百GB到TB级内存
- 网络:如需对接国家超算,建议配置InfiniBand
性能预期:
- 可参与国际格点合作组(如CLOCD)的物理点计算
- 支持μ子g-2、B介子衰变等精密计算
5.4 集群级:E级计算与国家级项目
适用场景:CLOCD合作组大规模组态生成,未来E级计算,量子模拟算法开发
| 部件 | 推荐配置 | 说明 |
|---|---|---|
| 计算节点 | 50-200× 双路EPYC 9965 (192核/节点) | 每节点384线程 |
| 内存/节点 | 2TB-4TB DDR5 | 应对大规模传播子计算 |
| GPU节点 | 20-50× 8×H100 SXM5 | GPU加速CG与机器学习采样 |
| 存储 | 并行文件系统 (Lustre/BeeGFS/GPFS) | PB级,带宽>100GB/s |
| 网络 | InfiniBand NDR 400Gbps | 低延迟MPI通信 |
| 作业调度 | Slurm + 工作流管理 | 自动化组态生成流程 |
软件栈:
- 格点QCD:Chroma、Grid、MILC、tmLQCD、QUDA(GPU库)
- 张量网络:ITensor、TenPy、PEPSKit
- 工作流:AiiDA、Snakemake
性能预期:
- 支持物理点2+1+1味大体积计算
- 可开展有限密度QCD、张量网络算法研究
- 符合美国DOE核物理Exascale计算需求
六、避坑指南:格点QCD计算的七条血泪教训
6.1 热化不足:被忽视的”隐形杀手”
坑:开始测量前热化不够,导致结果偏差。
教训:HMC轨迹存在自关联,初始组态可能远离平衡。热化长度应至少为10-20个自关联时间。
建议:
- 监控 plaquette、拓扑荷等量的历史图
- 使用自举法(bootstrap)正确估计误差
- 不同观测量可能有不同的自关联时间
6.2 有限尺寸效应:盒子太小会”骗”你
坑:格点体积太小,无法容纳物理过程(如重子-重子相互作用)。
教训:m_π·L > 4是经验法则(m_π是π介子质量,L是空间尺寸)。对于轻夸克,可能需要L > 6-8 fm。
建议:
- 在多个体积上计算,外推到热力学极限
- 使用有限体积修正公式(Lüscher公式)
6.3 连续极限外推:拟合函数的选择
坑:连续极限外推时选择错误的拟合函数,导致系统误差。
教训:不同作用量(Wilson、Staggered、DWF)有不同的离散化误差阶数。
建议:
- 了解所用费米子类型的O(a)或O(a²)误差
- 尝试多种拟合形式,检验稳定性
- 包含高阶项作为系统误差估计
6.4 软件配置:并行库版本冲突
坑:编译Chroma/Grid时,QMP、QDP++、LLVM版本不匹配,导致运行时崩溃或结果错误。
教训:格点QCD软件栈复杂,依赖关系严格。
建议:
- 使用Spack或Conda环境管理依赖
- 参考官方Docker镜像的配置
- 先在小规模测试通过,再扩展
6.5 存储I/O:组态写入拖慢整体效率
坑:HMC计算中,频繁写入组态到慢速磁盘,成为瓶颈。
教训:现代HMC可以接受率>80%,每个轨迹都写组态会产生大量I/O。
建议:
- 只在可接受的组态上写入(按接受率间隔)
- 使用ramdisk或fast SSD作为缓冲区
- 启用压缩(ILDG格式支持)
6.6 GPU加速:并非所有代码都适用
坑:盲目购买GPU,但主要使用的代码不支持CUDA/OpenCL。
教训:虽然Grid、QUDA支持GPU,但许多传统代码仍是CPU-only。
建议:
- 确认研究需要的代码是否支持GPU
- GPU在CG求解器上优势明显,但在其他部分可能不如CPU灵活
- 考虑CPU+GPU异构配置
6.7 超算vs本地:算笔经济账
坑:盲目建设本地集群,忽略了国家超算的性价比。
教训:格点QCD是典型的大规模并行应用,适合超算环境。
建议:
- 本地工作站用于测试、调试、中小规模计算
- 大规模组态生成使用国家超算(如天河、太湖之光)
- 申请科技部、基金委的超算机时
- 参与CLOCD合作组,共享组态资源
七、前沿展望:从蒙特卡洛到量子计算
格点QCD计算正处于范式转变的前夜。
7.1 机器学习采样:AI加速组态生成
流模型(Flow-based models):
- 使用归一化流(Normalizing Flow)学习玻尔兹曼分布的直接采样
- 相比HMC,可能减少自关联时间
- 2022年Lattice会议已有多个相关报告
自学习蒙特卡洛(Self-Learning MC):
- 用神经网络学习trivialization map,消除临界慢化
- 在二维模型中已显示数量级加速
7.2 量子计算:终极解决方案?
量子计算机天然适合模拟量子场论。近期进展包括:
- Schwinger模型(2D QED):已在离子阱、超导量子比特上实现实时演化
- 张量网络与量子模拟结合:用MPS/PEPS做状态准备,用量子电路做时间演化
- Roadmap:3D U(1)和4D SU(2)的量子模拟正在攻关
清华大学的布局:
- 2024年4月,清华大学成立人工智能学院,聚焦”AI+X”
- 量子信息与高能物理的交叉研究是潜在方向
7.3 张量网络:攻克符号问题的希望
对于有限密度QCD等存在符号问题的体系,张量网络可能是唯一出路。
Grassmann TRG(GTRG):
- 已证明在2D Schwinger模型中有效
- 挑战在于扩展到4D非阿贝尔规范理论
高阶张量重整化群(GHOTRG):
- 通过高阶SVD压缩张量维度
- 已在3D Z₂规范理论中实现高精度计算
八、结语:算力是探索微观世界的望远镜
回顾2025年7月的那个发现。
LHCb中国研究团队(北京大学、清华大学、中国科学院大学、华中师范大学等)参与的重子CP破坏观测,不仅体现了实验物理的精湛技艺,更离不开背后格点QCD计算对标准模型的精确检验。从夸克禁闭到强子衰变,从蒙特卡洛模拟到张量网络算法,计算物理正在改写高能物理的研究范式。
对于规划算力基建的研究者,记住几条原则:
- 先明确科学目标:是教学学习、中小规模研究,还是参与国际合作?
- 内存是刚需:格点QCD是内存密集型应用,宁大勿小
- 软件栈决定硬件选择:确认关键代码(Chroma、Grid、MILC)的优化方向
- 超算是重要选项:大规模计算应充分利用国家超算资源
- 关注新兴技术:机器学习采样、GPU加速、张量网络正在快速发展
从Wilson在1974年提出格点QCD,到2025年CP破坏的发现,人类对强相互动的理解走过了半个世纪的历程。而在这条探索之路上,算力基建就是研究者手中最可靠的望远镜——它帮我们看清夸克的舞蹈,预测强子的行为,最终在粒子物理的迷雾中找到通往新物理的道路。
正如参与CP破坏发现的戴鑫琛博士所说:”降低测量误差是发现CP破坏的关键突破口。”而在计算物理的世界里,降低统计误差、控制系统误差,同样需要强大的算力作为支撑。
免责声明:本文采用产业观察视角进行技术分析,文中提及的清华大学、北京大学等相关院系及研究成果均来自公开资料,不代表官方立场。文中硬件配置建议仅供参考,实际采购请根据具体需求评估。
分类标签:高能物理、粒子物理、格点QCD、蒙特卡洛模拟、张量网络、CP破坏、LHCb、硬件配置
技术标签:格点QCD、蒙特卡洛、HMC算法、张量网络、TRG、GTRG、Wilson费米子、 staggered费米子、Chroma、Grid、GPU加速、MPI并行、连续极限、符号问题












