
摘要:2025年8月,浙江大学物理学院王浩华教授、杭州国际科创中心郭秋江研究员团队联合清华大学邓东灵团队,在125比特超导量子芯片上首次实现稳定的新型有限温度拓扑边缘态,相关成果发表于《自然》杂志并入选清华年度十大亮点成果。这一突破不仅展示了量子计算的硬件进展,更凸显了经典计算在量子态层析、噪声建模和量子模拟中的关键支撑作用。本文从这一重大成果切入,深入解析精确对角化、量子蒙特卡洛等算法的本质,梳理量子-经典混合计算体系的硬件瓶颈,并提供从教学验证到大规模量子模拟的四级算力配置方案。
一、引言:当125比特量子芯片”看见”拓扑相变
2025年8月27日,国际量子计算领域迎来一个重要里程碑。
浙江大学物理学院王浩华教授、杭州国际科创中心郭秋江研究员团队联合清华大学交叉信息研究院邓东灵研究组,在浙江大学自主研制的125比特”天目2号”超导量子芯片上,首次实现了在非无序量子体系中稳定存在的新型有限温度拓扑边缘态。这项成果以《超导处理器上的拓扑预热强零模式》为题发表于《自然》杂志,并入选2025年清华大学最受师生关注十大亮点成果。
拓扑边缘态是凝聚态物理中最迷人的”景观”之一——它像一条神奇的”量子高速公路”,允许粒子在材料边缘无阻碍地流动,而不受杂质和缺陷的干扰。然而,传统拓扑边缘态有一个致命弱点:它只在绝对零度附近稳定存在,一旦环境温度升高,热激发就会破坏这种脆弱的量子保护。
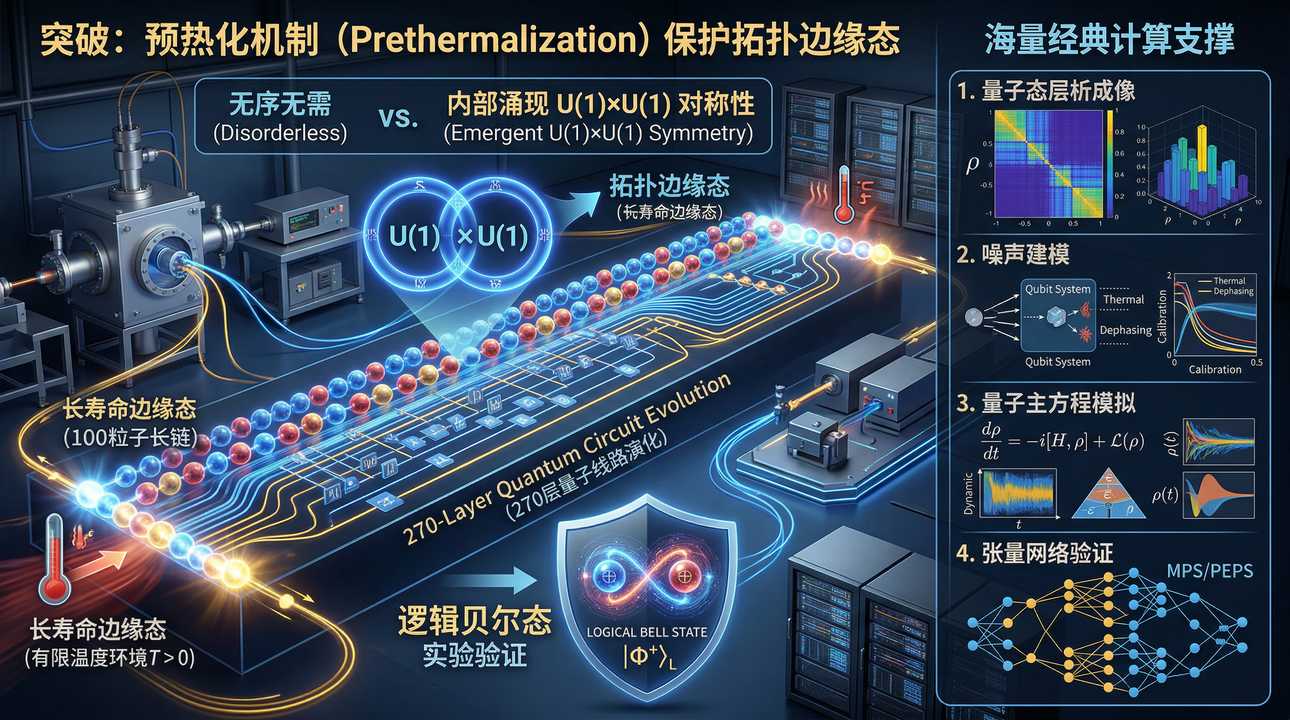
研究团队提出的突破在于**”预热化机制”**(prethermalization):无需引入无序,依靠系统内部涌现的U(1)×U(1)对称性,为拓扑边缘态提供额外保护,使其在有限温度下依然保持长寿命。实验中,团队利用100粒子长链、270层量子线路演化验证了这一机制,并基于此制备了逻辑贝尔态。
但鲜为人知的是,这一量子突破的背后,是海量经典计算的支撑——从量子态层析成像到噪声建模,从量子主方程模拟到张量网络验证,经典工作站和超算集群功不可没。
今天这篇,就从这一重大发现切入,聊聊支撑顶尖量子研究的经典算力基建。
二、量子模拟:当经典计算机成为”量子世界的翻译官”
2.1 为什么要用经典计算机模拟量子系统?
量子计算机的原理令人着迷:利用量子叠加和纠缠,它能在某些特定问题上实现指数级加速。但有一个悖论:在真正的量子优势到来之前,我们需要经典计算机来设计、验证和优化量子算法。
在邓东灵团队的实验中,经典计算至少扮演了以下角色:
量子态层析(Quantum State Tomography, QST):
实验完成后,团队需要重构百比特系统的量子态,验证拓扑边缘态确实存在。这相当于给量子世界拍一张”高清照片”。
噪声建模与参数提取:
超导量子芯片存在多种噪声源——T1/T2退相干、门操作误差、比特间串扰。团队需要建立精确的噪声模型,理解这些噪声如何影响拓扑态的寿命。
量子主方程模拟:
预热化机制的物理图像需要通过Lindblad主方程进行数值模拟验证,预测在特定参数下拓扑态的稳定时间。
张量网络验证:
对于可模拟的子系统,使用矩阵乘积态(MPS)进行经典模拟,与量子芯片实验结果进行交叉验证。
2.2 经典模拟的”指数墙”
量子系统的状态空间随量子比特数指数增长。一个n量子比特系统的状态空间维度是2ⁿ。
| 量子比特数 | 状态空间维度 | 存储需求(双精度复数) |
|---|---|---|
| 10 | 1,024 | 16 KB |
| 20 | 1,048,576 | 16 MB |
| 30 | ~10⁹ | 16 GB |
| 40 | ~10¹² | 16 TB |
| 50 | ~10¹⁵ | 16 PB |
| 100 | ~10³⁰ | 远超全球存储总量 |
这意味着什么?
- 模拟10-20量子比特:普通工作站可以胜任
- 模拟30-40量子比特:需要大型服务器或小型集群
- 模拟50+量子比特:超算也无法直接存储完整态矢量
- 研究团队的100比特实验:完全经典模拟在理论上是不可能的
但这并不意味着经典计算无能为力。张量网络方法和量子-经典混合算法提供了可行的近似方案。
三、算法本质:精确对角化、量子蒙特卡洛与张量网络
3.1 精确对角化(ED):小系统的”金标准”
精确对角化是量子多体计算的基准方法——它直接求解哈密顿量的全部本征值和本征态,结果可视为”精确解”。
算法流程:
- 构建哈密顿矩阵 H(维度 D×D,D=2ⁿ或更大)
- 对角化求解 H|ψ⟩ = E|ψ⟩
- 提取基态性质、能谱、关联函数等
计算复杂度:
- 存储哈密顿矩阵:O(D²) ~ O(4ⁿ)
- 对角化:O(D³) ~ O(8ⁿ)
- 对于n=20的量子比特:需要约1TB内存和数小时计算
在量子模拟中的应用:
- 小规模验证:验证量子芯片在小系统(n≤20)上的行为是否符合理论
- 噪声模型参数提取:通过拟合实验数据,提取T1、T2、门误差等参数
- 量子主方程模拟:求解Lindblad方程需要重复对角化超算符
3.2 量子蒙特卡洛(QMC):统计力学的利器
对于热力学性质和有限温度行为,量子蒙特卡洛是最强大的工具之一。
随机级数展开(SSE)算法:
将配分函数 Z = Tr(e^{-βH}) 展开为泰勒级数,通过蒙特卡洛采样计算热力学量。
行列式量子蒙特卡洛(DQMC):
对于费米子系统,将费米子路径积分转化为行列式形式,避免了符号问题。
计算特点:
- 内存需求相对较低(O(N)到O(N²))
- 计算密集型,需要大量采样
- 存在符号问题(费米子系统的负概率问题)
在量子模拟中的应用:
- 验证有限温度下的拓扑相变
- 计算热容、磁化率等热力学量
- 与量子芯片的有限温度实验进行对比
3.3 张量网络:突破指数墙的”压缩感知”
张量网络是近20年来量子多体物理最重要的数值方法突破。
矩阵乘积态(MPS)/密度矩阵重整化群(DMRG):
- 基于”面积定律”:一维系统的纠缠熵只与边界有关
- 用O(n×χ²)的参数近似表示2ⁿ维的量子态
- χ是键维度(bond dimension),控制精度
投影纠缠对态(PEPS):
- MPS向二维的推广
- 适用于二维量子系统
- 收缩计算更复杂,但仍在很多情况下可行
计算资源需求:
| 方法 | 系统尺寸 | 内存需求 | 适用场景 |
|---|---|---|---|
| ED | n≤20 | GB-TB级 | 小系统精确解 |
| DMRG | n~100-1000 | GB级 | 一维系统基态 |
| PEPS | 10×10到20×20 | 10-100GB | 二维系统 |
| 精确态矢量 | n≤30 | GB-PB级 | 通用量子模拟 |
在量子模拟中的应用:
- 量子态层析的替代方案:经典阴影(Classical Shadows)方法
- 验证量子芯片的子系统行为
- 量子纠错码的经典模拟
四、行业痛点:为什么量子模拟如此”吃”算力?
4.1 量子态层析的维度诅咒
量子态层析是实验量子计算的”标准动作”——它通过测量重构未知量子态的密度矩阵。
样本复杂度:
- 完整层析需要O(4ⁿ)次测量(Pauli算符完备集)
- 每个测量需要大量采样(统计误差控制)
- 对于n=100比特:需要约10⁶⁰次测量——物理上不可能
经典后处理复杂度:
- 线性反演:O(4ⁿ)计算,但可能产生非物理结果
- 最大似然估计(MLE):凸优化问题,O(8ⁿ)到O(16ⁿ)
- 对于n=20:MLE可能需要数小时到数天
解决方案:
- 经典阴影(Classical Shadows):只需O(poly(n))测量即可预测特定可观测量
- 张量网络层析:假设态具有低纠缠结构
- 压缩感知层析:利用态的稀疏性或低秩性
4.2 噪声建模的参数空间爆炸
真实量子芯片的噪声模型极其复杂。
噪声源分类:
- 退相干:T1(能量弛豫)、T2(相位退相干)
- 门误差:单比特门、双比特门的保真度
- 串扰:相邻比特间的非预期耦合
- 测量误差:读出错误率
- 校准漂移:参数随时间变化
噪声模型参数数量:
- 简单模型:O(n)参数(每个比特一个T1、T2)
- 完整模型:O(n²)参数(包含串扰)
- 含关联噪声:O(2ⁿ)参数——无法完整刻画
** Lindblad主方程模拟**:dtdρ=−i[H,ρ]+k∑γk(LkρLk†−21{Lk†Lk,ρ})
模拟100比特系统的开放量子动力学需要求解10⁶×10⁶维的密度矩阵演化——完全不可行。
实用策略:
- 简化噪声模型(只考虑主要噪声源)
- 使用蒙特卡洛波函数方法(随机演化纯态,避免密度矩阵)
- 张量网络模拟开放系统(TEDMRG、TEBD)
4.3 量子-经典混合算法的通信开销
变分量子本征求解器(VQE)、量子近似优化算法(QAOA)等混合算法需要量子处理器和经典计算机频繁交互。
计算流程:
- 经典优化器提出参数 θ
- 量子处理器执行电路,测量期望值 ⟨H(θ)⟩
- 经典优化器更新参数
- 重复数千到数百万次
通信瓶颈:
- 每次迭代需要传输测量结果
- 经典优化可能需要计算梯度(有限差分或参数平移)
- 对于大规模问题,通信延迟可能成为瓶颈
五、四级算力配置方案
基于与量子计算研究者的交流,以及量子模拟的特殊需求,我整理出以下四级配置方案:
5.1 入门级:教学验证与小规模模拟
适用场景:学习量子计算原理,模拟≤20量子比特系统,运行Qiskit/Qutip教学案例
| 部件 | 推荐配置 | 说明 |
|---|---|---|
| CPU | AMD Ryzen 9 9950X (16核32线程) | 高主频有利于Python数值计算 |
| 内存 | 64GB DDR5-5600 | 可模拟20-25量子比特的ED |
| 存储 | 2TB NVMe SSD | 快速I/O |
| 显卡 | RTX 4070 Ti 16GB | GPU加速张量运算(TensorNetwork库) |
| 软件 | Qiskit、Qutip、TensorNetwork、ITensor | 主流量子模拟框架 |
性能预期:
- 可模拟20量子比特的完整量子态层析
- 可运行100量子比特的DMRG计算(一维系统)
- 适合学习和算法原型验证
5.2 进阶级:中等规模模拟与噪声建模
适用场景:30-40量子比特的量子模拟,噪声参数提取,量子纠错码研究
| 部件 | 推荐配置 | 说明 |
|---|---|---|
| CPU | AMD Threadripper 7970X (32核64线程) | 四通道DDR5,大内存带宽 |
| 内存 | 256GB DDR5-4800 (ECC) | 可模拟30-35量子比特 |
| 存储 | 4TB NVMe SSD (企业级) + 20TB HDD | 存储大量测量数据 |
| 显卡 | RTX 4090 24GB 或 A100 40GB | GPU加速矩阵运算 |
| 网络 | 万兆以太网 | 与量子计算云平台数据交换 |
| 软件 | Qiskit Aer、CuQuantum、Julia(Yao.jl) | 高性能模拟库 |
关键考量:
- 内存容量:30量子比特需要约128GB内存存储态矢量
- 并行策略:OpenMP并行ED,MPI并行QMC采样
- GPU加速:CuQuantum可加速量子电路模拟10-100倍
性能预期:
- 可模拟30量子比特的噪声量子电路
- 可运行中等规模的量子蒙特卡洛计算
- 支持量子纠错码的完整模拟(表面码距离d≤10)
5.3 专家级:大规模量子模拟与量子-经典混合计算
适用场景:40-50量子比特近似模拟,大规模VQE/QAOA优化,张量网络方法研究
| 部件 | 推荐配置 | 说明 |
|---|---|---|
| CPU | 2× AMD EPYC 9755 (64核128线程) | 双路Zen 5,高内存带宽 |
| 内存 | 1TB-2TB DDR5-4800 (ECC REG) | 支持大规模张量网络计算 |
| 加速卡 | 2-4× NVIDIA A100 80GB | GPU集群加速 |
| 存储 | 8TB NVMe SSD (U.2) + 50TB RAID6 | 存储海量模拟数据 |
| 网络 | 25GbE 或 InfiniBand HDR | 低延迟通信 |
| 机箱 | 4U机架式 | 企业级散热 |
关键考量:
- 张量网络优化:GPU可加速张量收缩运算
- 混合算法:与量子计算云平台(如IBM Quantum、阿里量子云)高速连接
- 数据管理:大规模模拟产生TB级数据,需要高效存储和管理
性能预期:
- 可运行50+量子比特的MPS/DMRG计算
- 支持大规模变分量子算法的经典优化
- 可模拟表面码距离d≤15的量子纠错
5.4 集群级:超大规模模拟与量子计算生态支撑
适用场景:量子计算算法研发、大规模量子-经典混合计算、量子软件栈开发
| 部件 | 推荐配置 | 说明 |
|---|---|---|
| 计算节点 | 20-50× 双路EPYC 9965 (192核/节点) | 每节点384线程 |
| 内存/节点 | 2TB-4TB DDR5 | 大规模并行计算 |
| GPU节点 | 10-20× 8×A100/H100 SXM5 | GPU加速张量网络 |
| 存储 | 并行文件系统 (Lustre/BeeGFS) | PB级,带宽>100GB/s |
| 网络 | InfiniBand NDR 400Gbps | 低延迟MPI通信 |
| 量子云接口 | 专用光纤连接量子计算云平台 | 低延迟量子-经典通信 |
软件栈:
- 量子模拟:Qiskit、Cirq、Yao.jl、PennyLane、QuTiP
- 张量网络:ITensor、TenPy、TensorNetwork、quimb
- 量子-经典混合:Qiskit Runtime、Amazon Braket SDK
- 工作流管理:Snakemake、AiiDA
性能预期:
- 支持大规模量子蒙特卡洛计算(DQMC、AFQMC)
- 可运行二维PEPS计算(20×20格点)
- 支持实时量子纠错解码算法研发
- 可对接百比特级量子处理器进行混合计算
六、避坑指南:量子模拟计算的七条血泪教训
6.1 内存预估不足:ED的维度爆炸
坑:以为能模拟30量子比特,结果内存不足程序崩溃。
教训:态矢量存储需要2ⁿ×16字节(双精度复数)。
- 25比特:512MB
- 30比特:16GB
- 35比特:512GB
- 40比特:16TB
建议:
- 使用稀疏矩阵存储哈密顿量
- 采用Lanczos算法只求基态(避免完整对角化)
- 考虑张量网络方法替代ED
6.2 忽视数值精度:累积误差毁了结果
坑:长时间演化后,量子态不再归一化,结果完全错误。
教训:量子演化是酉变换,但数值积分会引入误差。长时间演化后,误差累积可能导致态矢量”漂移”。
建议:
- 定期重新归一化态矢量
- 使用辛积分器(保持酉性)
- 对于长时间演化,使用Trotter分解并控制步长
6.3 噪声模型过于简化:仿真与实验脱节
坑:只考虑T1/T2,忽视门误差和串扰,模拟结果与实验完全不符。
教训:真实量子芯片的噪声复杂得多。简单模型可能遗漏关键物理。
建议:
- 使用量子过程层析(QPT)提取完整噪声模型
- 采用随机基准测试(RB)标定门误差
- 考虑时空变化的噪声(非静态噪声)
6.4 量子态层析的样本复杂度陷阱
坑:试图对30比特系统进行完整层析,需要天文数字的测量次数。
教训:完整层析需要3ⁿ个Pauli算符测量,每个测量需要大量采样。
建议:
- 使用经典阴影方法只预测需要的可观测量
- 采用压缩感知层析(如果态是稀疏的)
- 利用张量网络假设降低复杂度
6.5 张量网络的键维度选择不当
坑:DMRG计算中键维度χ太小,结果不收敛;χ太大,计算太慢。
教训:χ控制精度与效率的权衡。一维有能隙系统通常χ=100-1000足够;临界系统需要更大χ。
建议:
- 进行χ外推(计算多个χ值,外推到∞)
- 监控纠缠熵,确保χ足够捕捉纠缠
- 对于二维系统,考虑PEPS的优化算法选择
6.6 忽视量子-经典通信延迟
坑:VQE优化循环中,每次迭代需要等待量子处理器,经典优化器长时间空闲。
教训:混合算法的瓶颈往往在通信,而非计算。
建议:
- 批量传输参数和结果
- 使用异步优化策略
- 考虑在经典端做代理模型(surrogate model)
6.7 存储I/O拖慢整体效率
坑:大规模QMC计算中,频繁写入中间结果到慢速磁盘。
教训:量子蒙特卡洛产生大量样本数据,I/O可能成为瓶颈。
建议:
- 使用ramdisk缓存中间结果
- 批量写入,减少I/O次数
- 启用压缩(HDF5支持)
七、前沿展望:从量子模拟到量子优势
研究团队的125比特实验展示了量子计算的硬件进展,但经典模拟仍在可预见的未来扮演关键角色。
7.1 经典阴影与随机测量
**经典阴影(Classical Shadows)**是一种突破性的量子态学习技术:
- 仅需O(log(n))次测量即可预测多个可观测量
- 避免了完整层析的指数复杂度
- 已集成到Qiskit、PennyLane等框架
7.2 神经网络量子态
**神经量子态(Neural Quantum States)**使用神经网络参数化量子态:
- 变分蒙特卡洛结合神经网络(如RBM、Transformer)
- 可表示高纠缠态(超出MPS的范围)
- 需要GPU加速训练
7.3 量子纠错解码的经典计算
表面码等量子纠错码需要实时解码:
- **最小权重完美匹配(MWPM)**解码器
- 基于神经网络的解码器
- 需要低延迟经典计算支持
7.4 量子-经典混合算法优化
VQE、QAOA等算法的经典优化部分:
- 梯度-free优化(COBYLA、SPSA)
- 基于梯度的优化(参数平移法则)
- 需要高效的经典优化库
八、结语:经典与量子的协奏曲
回顾2025年8月的那个《自然》封面。
浙江大学与清华大学合作团队(王浩华、郭秋江、邓东灵等)在125比特超导芯片上实现的有限温度拓扑边缘态,不仅解决了量子信息领域的一个核心难题,更揭示了经典计算与量子计算的深层协作关系。
在这场量子革命的征程中,经典计算机不是被取代的对象,而是量子世界的”翻译官”和”设计师”——它帮助我们理解量子现象、优化量子算法、验证量子结果。从精确对角化到张量网络,从量子蒙特卡洛到神经网络量子态,经典算法的发展与量子硬件的进步相辅相成。
对于规划算力基建的研究者,记住几条原则:
- 明确模拟目标:是完整态矢量模拟、张量网络近似,还是噪声建模?
- 内存是刚需:量子模拟是内存密集型应用,宁大勿小
- GPU加速越来越重要:张量网络、神经网络量子态都需要GPU
- 量子-经典接口是关键:低延迟网络连接量子云平台
- 关注新兴方法:经典阴影、神经量子态正在快速发展
从费曼提出量子计算机的构想,到研究团队的125比特突破,人类对量子世界的探索已经走过了近40年。而在这条道路上,经典算力基建始终是研究者手中最可靠的工具——它帮我们设计量子算法、验证量子结果、理解量子现象,最终在量子与经典的协奏中,奏响科技进步的新篇章。
正如该成果所展示的:量子计算的未来,不是经典与量子的零和博弈,而是两者的深度融合与协同创新。
免责声明:本文采用产业观察视角进行技术分析,文中提及的清华大学、浙江大学等相关院系及研究成果均来自公开资料,不代表官方立场。文中硬件配置建议仅供参考,实际采购请根据具体需求评估。
分类标签:量子计算、量子模拟、超导量子芯片、拓扑边缘态、预热化机制、经典-量子混合计算、硬件配置
技术标签:精确对角化、量子蒙特卡洛、DMRG、张量网络、MPS、PEPS、量子态层析、经典阴影、Lindblad主方程、噪声建模、Qiskit、Qutip、VQE、量子纠错












