
一、引言:当”开拓1000″点亮算力新基建
2024年对清华高性能计算领域而言,是承前启后的一年。
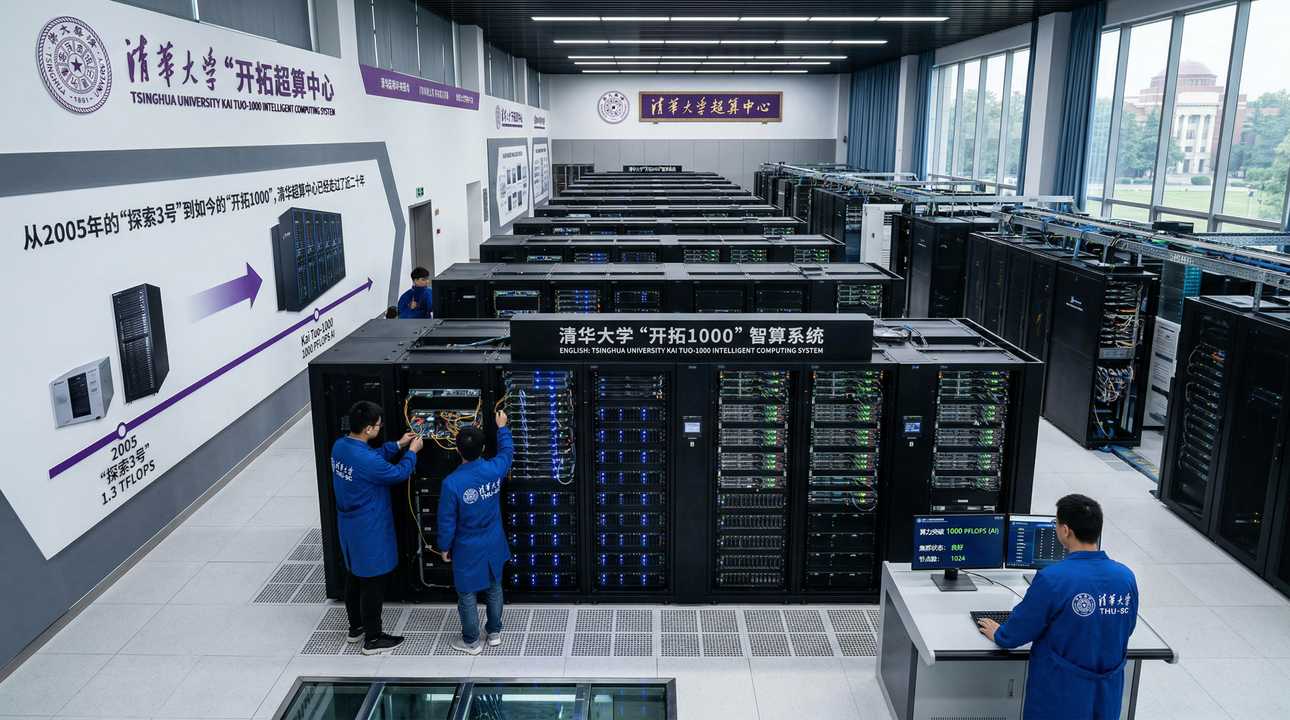
这一年,清华高性能计算平台完成了**”开拓1000″智算系统**的建设。从2005年的”探索3号”到如今的”开拓1000″,清华超算中心已经走过了近二十年。官方数据显示,平台累计服务46个院系、312个课题组,用户发表SCI论文1231篇,其中CNS(Cell/Nature/Science)论文51篇。
这一年,计算机系李国良教授当选ACM Fellow,表彰其在”人机协同数据集成与基于学习的数据库系统”领域的贡献。作为并行计算与数据管理的交叉学者,李老师的当选标志着清华在异构计算软件栈层面的国际影响力。
这一年,源自清华微电子所的清微智能宣布完成超20亿元C轮融资(2025年12月公布),其TX81可重构芯片已在多地落地千卡规模智算集群,累计获得可重构算力卡订单超2万张。
作为带了十几年并行计算课题的PI,我每年都要回答同一个问题:“老师,咱们组要买什么机器?”
这个问题看似简单,实则涉及三层决策:
- 第一层是算法本质——你的并行模式是计算密集型还是通信密集型?
- 第二层是软件生态——CUDA闭墙还是OpenCL开源?MPI拓扑如何设计?
- 第三层是成本边界——单卡预算还是集群预算?三年折旧还是五年规划?
今天这篇,就从一个”既要带学生写CUDA核函数、又要申请超算机时、还要考虑国产替代”的课题组负责人视角,聊聊异构计算硬件配置的那些门道。
二、算法本质:CUDA、MPI、OpenMP到底在算什么?
做硬件配置之前,必须先搞清楚你跑的是什么算法。很多学生一上来就问”买几张4090″,但问他们”你的算法是compute-bound还是memory-bound”,往往一脸茫然。
2.1 CUDA:数据并行的极致表达
CUDA(Compute Unified Device Architecture)的本质是**SIMT(Single Instruction Multiple Threads)**执行模型。简单来说,就是成千上万的线程同时执行同样的指令,只是操作不同的数据。
核心概念:
- Grid/Block/Thread三级结构:一个Kernel启动一个Grid,Grid里分Block,Block里分Thread
- Shared Memory:同Block内线程共享的高速缓存(比Global Memory快两个数量级)
- Warp调度:32个线程为一组Warp,由Warp Scheduler统一调度,隐藏内存延迟
硬件瓶颈:
- 显存带宽:H100的显存带宽超过3TB/s,但你的算法能不能吃满这个带宽?
- 显存容量:大模型训练动不动就要几十GB显存,单卡24GB的4090根本扛不住
- PCIe瓶颈:CPU到GPU的数据搬运速度,往往决定了你能不能用GPU
清华实践:
据平台运行观察,使用GPU加速的作业占比持续增长,主要集中在深度学习、分子动力学、计算流体力学等领域。但令人头疼的是,相当一部分GPU作业存在明显的PCIe带宽瓶颈——CPU预处理太慢,GPU大部分时间都在等数据。
2.2 MPI:分布式内存并行的标准答案
MPI(Message Passing Interface)是分布式内存系统的标准编程模型。当你的计算规模超过单机极限,MPI是唯一的出路。
核心概念:
- 进程间通信:通过
MPI_Send/MPI_Recv显式传递消息 - 集合通信:
MPI_Allreduce、MPI_Bcast等集体操作 - 拓扑映射:进程到物理节点的映射策略,直接影响通信延迟
硬件瓶颈:
- 网络延迟:InfiniBand的延迟能做到1μs以内,以太网则在10μs以上
- 带宽利用率:理论带宽和实际有效带宽往往差一个数量级
- 进程扩展性:很多算法在8节点能跑,到128节点就崩溃(通信开销指数级增长)
行业痛点:
MPI编程门槛高,调试困难。”死锁”和”数据竞争”是永恒的主题。很多课题组花了大量时间优化MPI通信模式,最后发现瓶颈其实在网络交换机的配置。
2.3 OpenMP:共享内存并行的轻量选择
OpenMP通过编译指令(#pragma omp parallel)实现线程级并行,适合多核CPU上的共享内存编程。
核心概念:
- Fork-Join模型:主线程fork出多个子线程,并行区结束后join回主线程
- 负载均衡:
schedule(static/dynamic/guided)决定任务分配策略 - 数据作用域:
private/shared/reduction控制数据可见性
与CUDA/MPI的关系:
- OpenMP + CUDA:CPU端用OpenMP并行预处理,GPU端用CUDA加速核心计算
- OpenMP + MPI:MPI负责节点间通信,OpenMP负责节点内多线程并行(Hybrid编程)
- 三者的融合:现代异构系统通常是”MPI跨节点 + OpenMP跨核心 + CUDA跨GPU”的三级并行
三、行业痛点:从”算不动”到”买不起”
3.1 软件生态的闭源陷阱
CUDA是异构计算的事实标准,但它是闭源的。这意味着:
- 你写的CUDA代码只能在NVIDIA GPU上跑
- AMD的ROCm、Intel的oneAPI虽然在追赶,但生态差距至少5年
- 国产AI芯片(昇腾、寒武纪、昆仑芯)需要额外的适配工作
清华超算中心2024年推出了九源智能基础软件栈,完成了与国产硬件(飞腾、鲲鹏处理器以及昇腾、寒武纪、昆仑芯等加速芯片)的适配。这是一个积极的信号,但距离真正好用还有很长的路。
3.2 通信开销的隐性成本
很多课题组买了很多GPU,但发现并行效率惨不忍睹。问题往往出在:
- PCIe拓扑不合理:CPU直连的GPU和通过PCIe Switch连接的GPU,通信延迟差一个数量级
- 网络配置不当:InfiniBand网卡插错槽位,实际跑在PCIe 3.0 x8上
- MPI进程映射错误:相邻rank的进程跑到不同节点上,所有通信都走网络
3.3 显存容量的硬约束
大模型时代,显存比算力更稀缺。
- GPT-3级别的模型需要数百GB显存,单卡根本装不下
- 模型并行(Model Parallelism)和流水线并行(Pipeline Parallelism)成为必选项
- 但并行策略越复杂,通信开销越大,扩展效率越低
3.4 国产替代的阵痛期
清微智能的TX81芯片已经落地千卡集群,但坦白说,从CUDA迁移到可重构计算架构,代码改造量是巨大的。很多课题组面临的现实是:
- 学生都会写CUDA,但不会写可重构计算的代码
- 国产芯片的编译器、调试工具链还不够成熟
- “能用”和”好用”之间,隔着大量的工程实践
四、硬件配置方案:从入门到千卡集群
以下是我课题组这些年迭代出来的配置思路,按计算规模和预算分为四级。
4.1 入门级:本科生教学/算法验证
适用场景:
- 学生学CUDA编程,写第一个核函数
- 小规模MPI程序验证(4-8进程)
- 单卡深度学习实验
重点配件:
| 组件 | 推荐规格 | 说明 |
|---|---|---|
| CPU | AMD Ryzen 9 9950X 或 Intel Core i9-14900K | 16核32线程,满足编译和预处理需求 |
| GPU | NVIDIA RTX 4090 24GB | 显存够大,支持CUDA 12.x |
| 内存 | 64GB DDR5-5600 | 四通道,满足大部分CPU-bound任务 |
| 存储 | 2TB NVMe SSD (PCIe 4.0) | 编译和模型加载速度关键 |
| 主板 | 支持PCIe 4.0 x16的B650/Z790 | 确保GPU带宽不受限 |
避坑提示:
- RTX 4090是游戏卡,不支持ECC显存,长时间计算有静默错误风险
- 单电源建议850W以上,双4090需要1600W+
- 机箱散热要够,涡轮版散热更好但噪音大
4.2 进阶级:博士生主力/组内共享
适用场景:
- 中等规模深度学习训练(单卡/双卡)
- MPI程序扩展到4-8节点
- 多物理场耦合仿真
重点配件:
| 组件 | 推荐规格 | 说明 |
|---|---|---|
| CPU | AMD Threadripper 7970X (32核) 或 Pro 7995WX (96核) | 7000系列四通道/Pro系列八通道DDR5,内存带宽关键 |
| GPU | 2× NVIDIA RTX Pro 6000 Blackwell (96GB, 2025年3月发布) | 专业卡带ECC,双卡NVLink互联 |
| 内存 | 256GB DDR5-4800 ECC RDIMM | 大模型训练刚需 |
| 存储 | 4TB NVMe SSD + 8TB HDD | 热数据SSD,冷数据机械盘 |
| 网络 | 双口25GbE 或单口100GbE | 为MPI扩展预留 |
避坑提示:
- Threadripper 7000系列(如7970X)支持四通道DDR5内存,Threadripper Pro 7000系列(如7995WX)支持八通道DDR5内存
- RTX Pro 6000 Blackwell是新一代专业卡(2025年3月GTC大会发布),显存96GB,比RTX 6000 Ada翻倍
- 双卡之间尽量用NVLink Bridge互联,PCIe P2P带宽受限
4.3 专家级:组内服务器/多GPU节点
适用场景:
- 大规模深度学习训练(4-8卡)
- 多节点MPI并行(16-32进程)
- 计算流体力学、分子动力学等HPC应用
重点配件:
| 组件 | 推荐规格 | 说明 |
|---|---|---|
| CPU | 2× AMD EPYC 9655 (96核) | 双路192核,每CPU 12通道内存 |
| GPU | 4-8× NVIDIA H100 80GB SXM5 | SXM5模组带宽更高,支持NVLink全互联 |
| 内存 | 1.5TB DDR5-4800 ECC (24×64GB) | 匹配H100的显存容量 |
| 存储 | 8TB NVMe SSD (U.2/U.3) + 20TB HDD | 企业级SSD,支持热插拔 |
| 网络 | 2× 200GbE InfiniBand HDR | MPI通信刚需 |
| 电源 | 4× 3000W钛金级冗余电源 | N+1冗余 |
| 散热 | 机房精密空调 + 液冷CDU | 整机功耗可能超过10kW |
避坑提示:
- H100 SXM5和PCIe版性能差距明显,有条件尽量上SXM5
- 8卡H100需要专用8GPU服务器机箱(如Supermicro SYS-821GE-TNHR)
- InfiniBand需要配置子网管理器(Subnet Manager),否则跑不起来
- 电源务必冗余,单点故障会导致整个节点下线
4.4 集群级:校级超算/千卡智算中心
适用场景:
- 千卡级大模型训练
- 国家级科研项目
- 对外提供算力服务
重点配件:
| 组件 | 推荐规格 | 说明 |
|---|---|---|
| 计算节点 | 多台8× H100/H200节点 | H200显存升级到141GB |
| 登录/管理节点 | 2× EPYC 9655 + 1TB内存 | 编译、调试、作业调度 |
| 存储系统 | 并行文件系统 (Lustre/IBM Spectrum Scale) | 容量PB级,带宽TB/s级 |
| 网络 | NVIDIA Quantum-2 InfiniBand NDR (400Gb/s) | 全胖树拓扑 |
| 调度系统 | Slurm + Kubernetes | 传统HPC与云原生融合 |
清华实践参考:
清华”开拓1000″智算系统就是这一级别的配置。根据公开信息,系统采用异构架构,CPU+GPU混合部署,支持传统HPC作业和AI大模型训练。平台配备了专业的运维团队,7×24小时监控。
五、避坑指南:课题组PI的血泪教训
5.1 软件授权陷阱
很多课题组买硬件不眨眼,但软件授权费一算就傻眼。
- NVIDIA AI Enterprise:如果用容器化部署,可能需要商业授权
- Intel MPI vs OpenMPI:OpenMPI免费,Intel MPI需要授权但性能更好
- 编译器:PGI/NVHPC编译器商业授权,GCC免费但优化程度有限
建议:买硬件之前先列软件清单,把授权费算进总预算。
5.2 网络拓扑盲区
MPI程序最怕的就是网络拓扑不合理。
- 胖树拓扑 vs 线性拓扑:胖树成本更高但扩展性更好
- 节点内通信 vs 节点间通信:同节点内用Shared Memory,跨节点走InfiniBand
- 进程映射策略:用
--map-by ppr:4:node还是--map-by core,性能可能差一倍
建议:集群部署时找网络工程师一起规划,别自己瞎连。
5.3 存储性能瓶颈
很多GPU集群的瓶颈其实在存储。
- 并行文件系统:Lustre需要Metadata Server和OSS分离,配置复杂
- 小文件性能:深度学习训练加载数据集,往往是几百万个小文件,传统NAS扛不住
- ** Burst Buffer**:用NVMe SSD做缓存层,缓解并行文件系统压力
建议:存储预算至少占总预算的20%,别只买算力不买存储。
5.4 国产适配的时间成本
如果考虑国产芯片,务必预留充足的适配时间。
- 代码迁移:CUDA代码迁移到昇腾CANN或寒武纪CNML,工作量可能以月计
- 性能调优:国产芯片的调优工具和文档还在完善中,需要更多试错
- 人才培养:学生会CUDA不一定会国产芯片编程,需要额外培训
建议:国产芯片适合长期规划,短期项目还是NVIDIA生态更稳。
5.5 散热和功耗的现实
高性能计算是电老虎。
- 单机功耗:8卡H100节点满载可能超过10kW,普通办公室插座根本带不动
- 机房要求:需要精密空调、UPS、消防系统,成本可能超过机器本身
- 电费:千卡集群跑一年,电费可能是硬件成本的30-50%
建议:买机器之前先确认机房条件,别买了机器没地方放。
六、前沿展望:异构计算的下一个十年
6.1 CXL:内存池化的革命
CXL(Compute Express Link)正在改变异构计算的内存架构。通过CXL,CPU、GPU、FPGA可以共享同一个内存池,打破传统的NUMA边界。
清华计算机系在CXL相关领域有深入研究,李国良教授团队的数据库系统研究就涉及异构内存管理。未来3-5年,CXL可能成为高端HPC系统的标配。
6.2 国产芯片的生态突破
清微智能的TX81已经证明了国产可重构计算的可行性。随着九源软件栈的完善,国产AI芯片的可用性正在快速提升。
对课题组而言,建议采取”NVIDIA为主、国产为辅“的策略:主力业务用CUDA生态保证稳定,边缘场景用国产芯片做适配储备。
6.3 云原生HPC的兴起
Kubernetes正在进入HPC领域。Slurm + K8s的混合调度模式,可以让传统MPI作业和容器化AI训练共享同一套基础设施。
清华超算中心已经在探索这一方向,未来课题组可能不再需要自建机房,而是通过”云-边-端”混合架构获取算力。
七、结语:算力规划是一门工程艺术
回到开头的问题:”老师,咱们组要买什么机器?”
十年前的答案可能是”买台好点的服务器”。五年前的答案是”买几张1080Ti”。今天的答案变成了”取决于你的算法是compute-bound还是memory-bound,取决于你用CUDA还是MPI,取决于你打算用三年还是五年”。
算力规划从来不仅仅是硬件选型,它是算法理解、软件生态、成本预算、运维能力的综合博弈。作为课题组PI,我的职责不是买最贵的机器,而是买最合适的机器——既能支撑学生的科研需求,又不会在三年后变成一堆废铁。
清华”开拓1000″的建设让我看到,顶尖高校的算力基建正在进入新阶段。从千卡集群到国产替代,从传统HPC到AI智算,这个行业正在经历剧烈的范式转换。
希望这篇能帮到正在纠结硬件配置的同行。毕竟,算力是科研的杠杆,但杠杆本身不是目的——做出好东西才是。
分类标签:计算机科学、并行计算、异构计算、CUDA、MPI、OpenMP、课题组管理、硬件配置 技术标签:CUDA、MPI、OpenMP、H100、H200、EPYC、Threadripper、InfiniBand、NVLink、CXL、九源软件栈、清微智能、开拓1000、异构内存、混合编程












