
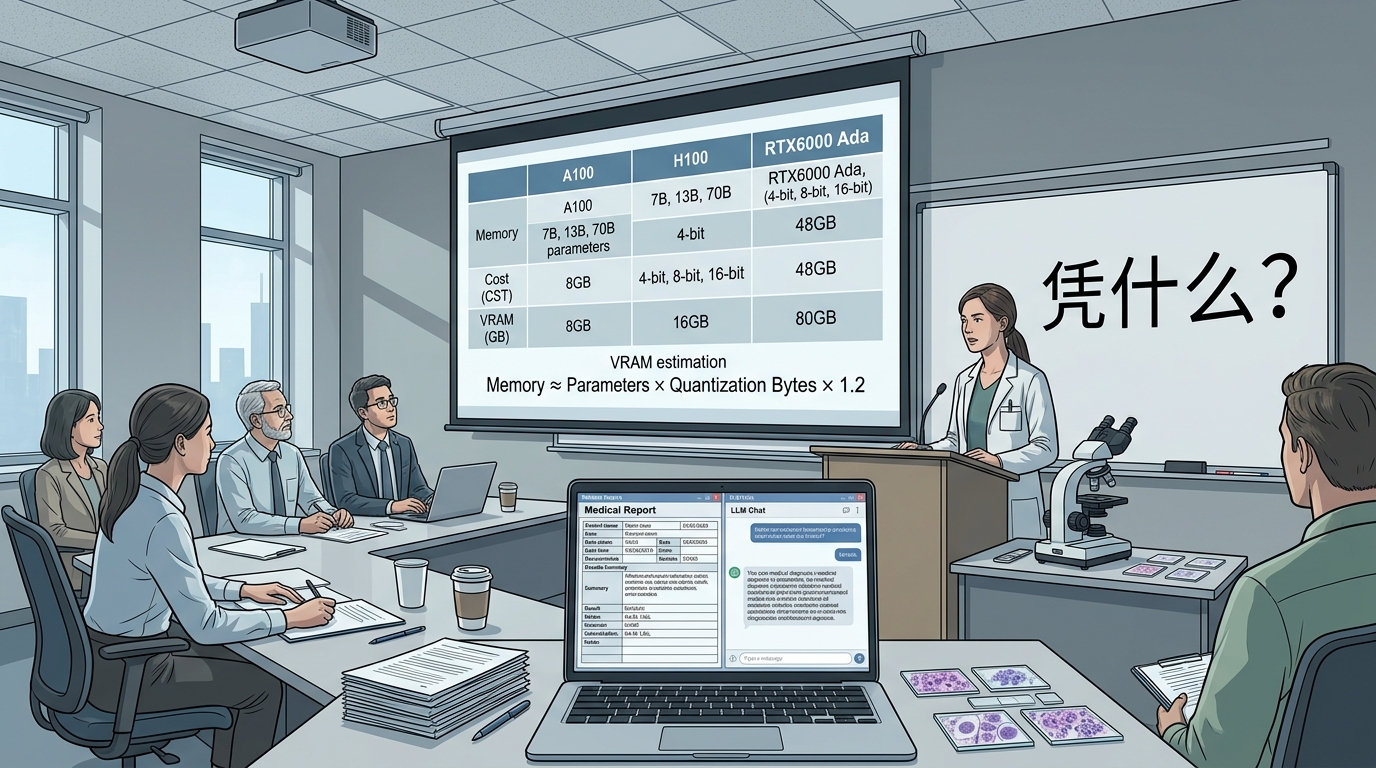
答辩现场:一台工作站凭什么要十几万
2026年的设备预算答辩会上,评审老师抛出一个直截了当的问题:医学检验技术专业的课题组,买一台十几万的图形工作站,理由是什么?
这个问题值得认真回答。华中科技大学同济医学院的医学检验技术专业是四年制理学专业,2020年度入选国家级一流本科专业建设点(据附属协和医院官网公布的名单)。今天的检验科正在变成数据工厂:生化、免疫、血液、微生物流水线每天产出成千上万条检验记录,细胞学室积攒的宫颈细胞学检查、血细胞形态图像以百万张计。2025年8月数博会期间,国家数据局公布首批高质量数据集典型案例,武汉兰丁的宫颈细胞AI辅助诊断高质量数据集入选——数据总量超1400TB,涵盖近1300万例宫颈细胞样本,标注细胞超10亿个。检验大数据遇上AI辅助诊断,已经是这个行业正在发生的事情。课题组要做的,是把这条技术路线搬进教学与科研。下面按答辩的逻辑,把这笔经费的账一笔一笔算清楚。
答辩一:旧电脑能跑,但跑掉的是博士生的时间
先说检验大数据负载的真实节奏。这个方向上有三类计算任务:检验指标数据的统计建模,对几十万到上百万条检验记录做清洗、特征工程和回归分析;细胞图像的智能识别,用卷积网络或视觉Transformer处理宫颈细胞学、血细胞形态图片;以及大模型辅助的文献调研、SOP问答和报告结构化。前两类吃内存容量和显存,第三类吃显存和推理速度。
一台多年前配置的普通台式机,能把这些活干成什么样?特征工程阶段,全量数据进不了16GB内存,只能切着样本跑,改一个变量重跑一次就是一下午;图像训练阶段,小显存显卡把批次压到个位数,一轮迭代按小时计,一个超参组合扫描过夜跑不完,而论文里的对照实验动辄几十组。换大内存加24GB以上显存的工作站,数据全量进内存、批次开满,单轮迭代压到分钟级。省下来的是博士生几个月的科研时间——延期一年的培养成本,远超两台机器的差价。
答辩二:这个方向要做五年,设备不能只撑两年
设备论证最容易被追问”为什么不能便宜点”。答案是课题周期。AI辅助诊断已进入国家数据基础设施的布局,国家数据局首批高质量数据集名单里医疗检验类赫然在列,这类课题至少按五年规划。五年里,数据规模会翻几番,模型会从14B级走向32B常驻,用法会从纯推理走向微调定制。
平台的生命周期由最短板决定。内存和硬盘后期可以加,显卡可以换,但主板支持的CPU平台、内存插槽数量、电源与散热余量,买定离手。按”眼下刚好够用”买,第二年就撞显存墙:32B级模型Q4量化后需要约24GB显存,16GB显存的机器连加载都做不到;按”超前一档”买,第五年还能给新入学的研究生当主力机。贵的机器用五年,便宜的机器用两年就闲置,平摊到每一年,前者反而便宜。
答辩三:一台机器,全组排队还是全组共享
课题组十几号人:本科毕设、硕士课题、博士课题、助教备课,都要算力。一台机器摆在实验室,默认就是多人共用平台。共享的痛点在排队:只有一台旧机器时,博士生的训练任务把机器占住,本科生只能等,等三天跑一组数据,一个学期做不了几轮实验。硬让多任务混跑,内存和显存互相挤占,谁都跑不快。
硬件余量加上容器化调度,能把”排队三天”变成”随时提交”。Docker把每个人的环境隔开,vLLM给大模型服务做显存配额,训练任务丢进队列按优先级执行。平台化之后,一台机器撑起整个课题组的日常计算,人均摊下来的成本反而低于每人一台低配机。这也是评审愿意听到的叙事:这笔钱买的是课题组公共平台,不是某个人的装备。
答辩四:检验数据出一次错,丢的不只是数据
医学检验数据属于敏感个人信息,包含与患者身份关联的检验结果,课题组受数据管理规定约束,脱敏数据也要求在内网环境处理。这决定了承载数据的机器必须稳定、可控、可审计:ECC内存纠正位翻转,避免连续十几小时的训练中一个静默错误毁掉整轮权重;冗余电源扛住供电波动;品牌整机的兼容性与质保让故障有人兜底。自攒机崩一次,丢的可能是一组无法复现的实验和学位论文的截止日期。
更深一层,数据不出内网这条红线,同时决定了课题组的大模型只能私有化部署。这笔显存账,下一节算清楚。
大模型私有化部署:检验数据的合规答案
课题组用大模型干什么?检验医学文献与指南的摘要问答、SOP操作规程咨询、检验报告结构化、课题申报书草稿、挂载本地知识库的科室资料查询——这类任务全天候高频使用。
为什么本地部署?三条理由都落在检验场景上。合规:检验数据含敏感个人信息,脱敏后按管理规定仍不出内网,文献问答和报告结构化又难免引用真实数据字段,公有云对话框过不了这一关。成本:高频API账单按月累积,两年抵得上一张高端显卡。离线可用:检验实验室内网环境决定模型服务必须本地常驻。
选型两款就够。GLM-4-32B-0414由智谱2025年4月开源,320亿参数,MIT协议,指令遵循与报告生成能力突出,适合检验报告结构化、SOP问答这类讲究格式严谨的任务。Qwen2.5-14B-Instruct出自阿里通义千问,约147亿参数,长文档处理均衡,适合指南与文献摘要、知识库挂载。
显存账统一估算:所需显存约等于参数量(B)乘量化字节数乘1.2预留系数,FP16每参数2字节,Q8为1字节,Q4为0.5字节。算例一:Qwen2.5-14B-Instruct按Q4量化,14乘0.5乘1.2约8.4GB,计入上下文约9GB,16GB显存从容运行。算例二:GLM-4-32B-0414按Q4量化,32乘0.5乘1.2约19.2GB,行业实测19到22GB,24GB显存是起步线,上下文拉长或多人并发建议往32GB走。
量化等级按精度需求选:FP16几乎无损,但32B模型要64GB;Q8损失约一到三个百分点,约33GB;Q4损失五到十个百分点,体积只有FP16的四分之一,是消费级默认选项——日常问答足够,报告结构化等关键任务可切Q8复核。
速度上,纯CPU内存推理只有个位数tokens/s,问一句等几十秒;单卡GPU能到几十到上百tokens/s,几分钟出一份摘要。这就是工作站与普通电脑的分水岭。
微调另算一笔:LoRA给14B模型做检验领域适配,显存增量约3到5GB,余量足以覆盖;全参数微调哪怕7B也要80GB以上。现阶段定位”推理加LoRA”,配置按此选档。
软件生态
检验大数据平台的软件栈分四层。数据层:关系库对接LIS导出的检验数据,ETL清洗与脱敏工具先行,统计建模用R或Python生态;图像层:PyTorch或PaddlePaddle承担细胞图像分类训练,OpenCV负责切片预处理;模型服务层:vLLM或Ollama对外提供OpenAI兼容接口,GLM-4-32B-0414与Qwen2.5-14B-Instruct双模型常驻,Docker做任务隔离;系统层:Ubuntu Server或Windows工作站版按需搭配,全部环境容器化,数据备份与权限审计制度化。授权合规提前规划,操作系统、数据库、统计软件按课题组正版口径走校内采购。
UltraLAB 配置怎么选
高校买设备跟企业不一样:钱要走采购流程、过资产验收,机器得撑过几届学生的培养周期。医学检验方向的负载有两条主线:检验大数据分析吃内存容量和存储IO,AI辅助诊断与大模型部署吃显存,两条线叠加,配置思路是”均衡偏显卡”。前面几道答辩把需求账算清了,下面按评审通过难度给四个参考档位,都是报价表里的实际机型,下单前可按课题组数据规模和并发人数微调内存与存储容量。
方案A:入门教学与推理档(最容易过审)
适用场景:本科教学与毕设、检验指标数据统计建模、Qwen2.5-14B-Instruct 常驻推理、GLM-4-32B-0414 轻量推理。
| 硬件类别 | 具体配置 | 说明 |
|---|---|---|
| CPU | Intel Ultra9 285K (24核, 8P核5.6GHz) +水冷 | 24核高频多线程,驱动检验数据清洗、特征工程与常规统计建模。 |
| GPU | RTX5090D v2 24GB+水冷 | 24GB显存正好是GLM-4-32B Q4量化的起步线,兼顾细胞图像训练入门。 |
| 显存 | 24 GB | 扣住文中显存账(32B Q4约19~22GB),上下文拉长后余量偏紧。 |
| 显存带宽 | 1.34 TB/s | 决定推理tokens/s,文献摘要与SOP问答的响应体验靠它。 |
| 内存 | 128GB DDR5 | 几十万到上百万条检验记录可全量进内存,避免切样本反复重跑。 |
| 存储 | 4TB NVME + 8TB SATA | NVME装系统与热数据,SATA盘存原始检验记录与图像库。 |
推荐机型:A350 153128-MCT
硬件解析:入门档的均衡解——CPU多核管数据管线,24GB显存卡住32B模型起步线,128GB内存让全量检验数据驻留。短板在显存余量:32B常驻后上下文与多人并发空间有限,任务混跑要排队,恰好匹配”教学与轻量推理”的定位,这也是它过审阻力最小的原因。
答辩话术:这一档解决”有没有”。一台机器同时覆盖教学实验、14B模型常驻和32B模型起步,单价最低,评审一眼看懂钱的去向,过审阻力最小。
方案B:课题主力与舒适推理档(平衡叙事)
适用场景:硕士课题与细胞图像AI训练、全量检验数据的内存级处理、GLM-4-32B-0414 常驻舒适推理与 LoRA 微调。
| 硬件类别 | 具体配置 | 说明 |
|---|---|---|
| CPU | AMD锐龙TR 7980X (64核4.8GHz) | 64核桌面旗舰,全量检验数据的特征工程与回归分析几乎无等待。 |
| GPU | RTX 5090D 32GB | 32GB显存让GLM-4-32B常驻从容,LoRA微调的3~5GB增量也装得下。 |
| 显存 | 32 GB | 覆盖32B Q4量化加上下文拉长、多人轮询的全部余量。 |
| 显存带宽 | 1.79 TB/s | 推理速度再提一档,摘要问答与报告结构化不必排队等。 |
| 性能指标 | C:4.9+G73 | CPU与GPU综合算力配比均衡,细胞图像训练可以开满批次。 |
| 内存 | 192GB DDR5 | 数据全量驻留之外还有富余,供Docker多环境与vLLM配额并行。 |
| 存储 | 系统盘 4TB NVME 数据盘 8TB NVME+20TB SATA | 双NVME分层,训练数据集读写与系统响应互不抢IO。 |
推荐机型:GR450P 148192-MDT
硬件解析:这档的核心是”互不抢资源”——64核CPU独立支撑数据管线,32GB显存独立覆盖32B常驻与LoRA微调,192GB内存同时喂两边,C:4.9+G73的综合指标说明算力配比均衡而非单点堆料。五年周期内数据规模翻番、模型从14B走向32B常驻,这套平台接得住,是”用得久”的那一档。
答辩话术:数据分析和大模型推理在这档配置上互不抢资源,是”用得久”的选择。预算允许时优先这档,五年生命周期内不用动平台。
方案C:共享平台与训练储备档(需要较强论证)
适用场景:课题组多人共享平台、多模型并发服务、细胞图像深度学习训练、未来全参数微调的算力储备。
| 硬件类别 | 具体配置 | 说明 |
|---|---|---|
| CPU | 2×Xeon金牌6530 (64核2.7~4GHz) | 双路服务器级64核,多人并发提交任务时有真正的调度底气。 |
| GPU | 4×RTX 4090 48G +水冷 | 4卡48G,多模型并发、大batch训练、全参数微调储备一步到位。 |
| 显存 | 4×48 GB | 合计192GB显存池,32B模型常驻加LoRA与图像训练并发互不挤占。 |
| 显存带宽 | 4×1.01 TB/s | 每卡独享约1TB/s带宽,多卡并行训练时单卡效率不塌陷。 |
| 性能指标 | FP32:288 Tflops | 288TFlops单精度算力,细胞图像卷积网络与深度学习训练的吞吐天花板。 |
| 内存 | 256GB DDR5 | 共享平台的内存底座,喂饱4卡训练的数据供给。 |
| 存储 | 系统盘 4TB NVMe 数据盘 20TB SATA | 20TB数据盘装得下百万张级细胞图像库与逐年累积的检验数据。 |
推荐机型:GX660M 227256-MC4T
硬件解析:共享平台档的底气在4×48G显存池——192GB显存把课题组从”排队用卡”变成”并发提交”,全参数微调的80GB门槛提前跨过;双路Xeon加256GB内存保证CPU侧数据供给不拖GPU后腿。一次把算力天花板抬到训练级,后面几年只需添内存,这正是论证报告里最好写、也最硬的一条理由。
答辩话术:这一档写进论证报告的理由很硬——国家数据局名单上的检验数据集已到千万例级、十亿标签级,数据规模按五年周期翻几番是保守估计。一次把算力天花板抬到训练级,后面几年只需添内存。
方案D:学院平台与机房部署档(需要强力论证)
适用场景:学院级共享算力平台、多课题组联合使用、机房集中部署、更大参数模型的长期储备。
| 硬件类别 | 具体配置 | 说明 |
|---|---|---|
| CPU | 2×Xeon金牌6530 64核2.7G | 服务器双路平台,学院多课题组并发时的CPU配额底座。 |
| GPU | 2×RTX 6000D 84G | 专业计算卡单卡84G,为70B级更大参数模型预留加载空间。 |
| 显存 | 2×84 GB | 合计168GB显存,32B模型FP16(约64GB)也能本地加载。 |
| 显存带宽 | 2×1.57 TB/s | 每卡1.57TB/s带宽,长上下文推理与高并发服务保持响应。 |
| 性能指标 | 半精度FP16:833Tflops,FP64:200Tflops | 半精度833TFlops,训练与推理的双料天花板,更大模型微调留足余量。 |
| 内存 | 320GB DDR5 | 学院级多课题数据并行的内存池。 |
| 存储 | 4TB NVMe | 机房集中部署形态,可挂存储阵列横向扩展。 |
推荐机型:GX660 227320-PC2E
硬件解析:学院平台档的核心是机架式进机房——4U服务器统一管理运维,双路Xeon加双专业计算卡把天花板抬到70B级模型与训练级负载,168GB显存池连32B模型的FP16精度档都能本地加载。它买的不是单台性能,而是多课题组分摊的公共算力资产:一次论证、统一运维、长期储备,资产利用率对得起这笔经费。
答辩话术:把眼光从单个课题组抬到学院公共平台:一次论证、多课题组分摊,资产利用率和论文产出都对得起这笔经费。机架式进机房,不占实验室工位,运维统一管理。
评审一定会问的四个刁钻问题
能不能用公有云,按量付费更省
短期看省,长期看贵。检验数据按管理规定不出内网,云上能跑的只有脱敏后的通用计算,而课题组的核心负载恰恰不宜出网。再算账:云端GPU实例按小时计费,全年高频使用累积的费用两年够买一张高端显卡,第三年云还在持续花钱,资产却不属于学校。
能不能先买台便宜的顶着,过两年再说
重复采购才是浪费。国有资产每次采购都要重新论证、重新走流程,”先买便宜的”意味着两年后同样的流程再走一遍,旧机器残值还极低。一次到位把平台生命买足,是设备经费的基本原则。
隔壁组才花了一半,你们为什么贵
负载不同。隔壁的机器若只做文档办公和轻度统计,一半预算足够;检验方向要跑细胞图像训练和大模型常驻推理,显存与内存的门槛是硬性的,压不下去。
学生毕业了,机器归谁用
平台归属课题组和学院,不按人头分配。教学实验、后续课题、公共课程会持续使用,资产折旧周期内一直在产出。这笔钱买的是方向上的公共能力。
结语
设备经费的本质,是把未来几年的科研时间和确定性一次性买断。医学检验技术正从镜下经验走向数据与模型双轮驱动,检验大数据与AI辅助诊断已写进国家数据基础设施的名单。一台经得起答辩的图形工作站,是给这个转向准备的硬件底座——答辩会上每一句”凭什么”,落成配置表上的每一个数字。
机型一句话点评
- A350 153128-MCT:预算敏感课题组的过审利器,一台打包14B常驻与32B起步。
- GR450P 148192-MDT:数据分析与GLM-4-32B-0414常驻互不打架的平衡手。
- GX660M 227256-MC4T:共享平台的底气所在,算力天花板直接抬到训练级。
- GX660 227320-PC2E:学院平台的答案,机房部署、统一运维、多组分摊。











