
本文采用技术分析视角,以清华大学地球系统模式研发为参照系探讨行业趋势。文中提及的学术成果均来自公开文献,不代表任何官方立场。硬件配置建议仅供参考。
一、写在前面:当气候模式遇上”算力墙”
2017年11月,美国丹佛SC17高性能计算大会上传来一个消息:由清华大学、北京师范大学与山东大学组成的联合研究团队,基于”神威·太湖之光”超级计算机,实现了千万核规模下25公里分辨率的全球气候模式模拟,计算性能达到3.4模拟年每天——这是当年戈登·贝尔奖(Gordon Bell Prize,全球超算应用最高奖)的入围项目。
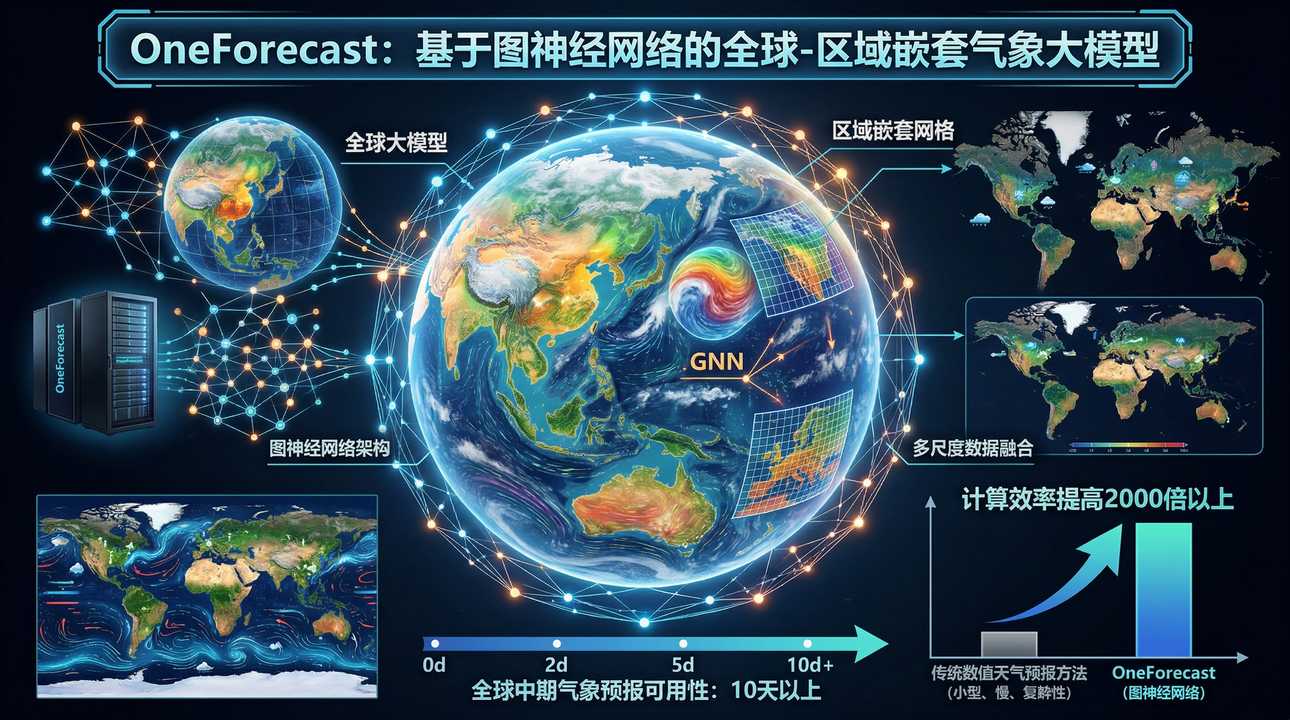
时间快进到2025年。清华大学地球系统科学系黄小猛教授团队联合多家机构,发布了基于图神经网络的全球-区域嵌套气象大模型OneForecast,将全球中期气象预报可用性提高到10天以上,计算效率较传统数值天气预报方法提高2000倍以上。
从千万核并行优化到AI大模型重构,气候模式开发正在经历一场静默的革命。本文从算法本质、前沿技术、行业痛点三个维度,聊聊气候模式动力核心的演进与硬件配置逻辑。
二、算法本质:三大动力框架的精度-效率权衡
1. 有限差分法(Finite Difference):WRF的”务实之选”
核心思想:在离散网格点上用差分近似微分,将偏微分方程转化为代数方程组。
WRF(Weather Research and Forecasting)的选择:
- 采用Arakawa C网格(交错网格):水平风速定义在面心,垂直速度定义在层间,质量变量定义在格点中心
- 时间积分:Runge-Kutta 3阶或分裂显式方案
- 空间精度:通常5阶水平差分、3阶垂直差分
计算特性:
- 局部性:每个格点的计算只依赖邻居,通信模式规则(stencil计算)
- 稀疏矩阵:线性系统稀疏,适合迭代求解
- 内存需求:相对较低,N个格点约需O(N)内存
硬件适配:
- CPU并行友好(OpenMP/MPI混合)
- 缓存利用率高(空间局部性好)
- 适合大规模CPU集群
清华实践:
- 清华乔泽宇等利用WRF 3DVar系统,研究了自动气象站数据同化密度对降雨预报的影响,发现当站点密度达到1个/500km²时,同化效果达到”饱和”
- 青藏高原陆面资料同化研究表明,通过同化春季积雪覆盖数据,可显著提升对欧洲夏季热浪的预测能力
2. 谱方法(Spectral Method):全球守恒的”数学之美”
核心思想:将场变量展开为全球球谐函数(Spherical Harmonics),在谱空间求解。
数学表达:f(λ,θ)=n=0∑Nm=−n∑nfnmYnm(λ,θ)
其中 Ynm 是球谐函数,n 是总波数,m 是纬向波数。
优势:
- 指数收敛:光滑函数的误差随截断波数指数下降
- 全局守恒:自动保证质量、能量、角动量守恒
- 无数值扩散:不像差分法有离散误差导致的虚假扩散
劣势:
- 全局通信:球谐变换(Legendre变换)需要全球数据,通信密集
- 非线性项处理:乘积在谱空间是卷积,需变换回物理空间(伪谱法)
- 并行瓶颈:FFT和Legendre变换的全局性限制扩展性
硬件适配:
- 内存带宽敏感:大量数据重排(transpose)操作
- 通信密集型:All-to-all通信模式,对网络拓扑敏感
- 适合胖节点:单节点核心数多、内存大的系统
典型应用:
- ECMWF IFS(欧洲中期天气预报中心综合预报系统)
- 清华CIESM早期版本的有限体积动力框架对比研究
3. 谱元法(Spectral Element Method):”鱼和熊掌兼得”
核心思想:将全球划分为若干单元(element),每个单元内使用谱方法(高阶多项式)。
CESM/CAM的选择:
- 动力核心:CAM-SE(Spectral Element)
- 网格:立方球网格(cubed-sphere),6个面,每个面划分N×N单元
- 阶数:通常3-4阶(Np=4-5个高斯-洛巴托点),总自由度数为 6×N²×Np²
计算特性:
| 特性 | 有限差分 | 谱方法 | 谱元法 |
|---|---|---|---|
| 精度 | 代数收敛 | 指数收敛 | 谱收敛(单元内) |
| 通信 | 局部(stencil) | 全局(All-to-all) | 单元间边界交换 |
| 并行性 | 优秀 | 受限 | 优秀 |
| 守恒性 | 近似 | 精确 | 精确 |
| 复杂地形 | 好 | 差 | 好 |
硬件适配:
- 计算密集:高阶多项式求值计算量大
- 通信可预测:单元间边界交换,模式类似有限元
- 适合异构架构:GPU可加速单元内计算
清华实践:
- 清华CIESM 1.1版本采用谱元大气动力框架,在神威太湖之光上5400核运行速度达10模式年每天
- 实现了百万核规模全球25km高分辨率大气数值模拟
- 付昊桓参与团队(2016年)基于神威·太湖之光优化CAM-SE,实现千万核规模750米分辨率,性能达3.3 PFlops
三、资料同化:从3DVar到EnKF的算法演进
1. 三维变分同化(3DVar):业务系统的”主力军”
数学框架:J(x)=21(x−xb)TB−1(x−xb)+21(y−H(x))TR−1(y−H(x))
- x:分析场(待求)
- xb:背景场(模式预报)
- y:观测向量
- H:观测算子(将模式变量映射到观测空间)
- B:背景误差协方差矩阵
- R:观测误差协方差矩阵
计算特性:
- 矩阵规模:B矩阵维度为N×N,N是模式状态变量数(数千万到数亿)
- 简化假设:B通常假设为静态、各向同性,用控制变量变换(如NMC方法)降维
- 求解器:共轭梯度(CG)或预处理CG,通常需要50-100次迭代
硬件需求:
- 内存:大内存需求(存储B的简化表示、预处理矩阵)
- CPU:矩阵-向量乘计算密集
- 存储:需要访问大量观测数据、背景场
2. 四维变分同化(4DVar):时间维度的”最优控制”
核心思想:在同化窗口(通常6-12小时)内,通过调整初始状态,使模式轨迹与观测最佳拟合。
数学框架:J(x0)=21(x0−xb)TB−1(x0−xb)+21t∑(yt−H(xt))TR−1(yt−H(xt))
其中 xt=M0→t(x0) 是模式从初始时刻到t的积分。
关键技术:伴随模式(Adjoint Model)
- 需要开发原模式的伴随代码(反向传播)
- 计算代价:一次4DVar迭代 = 1次正向积分 + 1次伴随积分
- 通常需要20-50次迭代收敛
计算特性:
- 计算成本高:是3DVar的10-50倍
- 内存开销大:需要存储或重新计算窗口内的模式状态
- 伴随模式开发:复杂且易出错(需要手动编写或自动微分)
硬件需求:
- 高内存带宽:伴随模式有大量数据流反向操作
- 大容量存储:保存中间状态(checkpointing策略)
- CPU核心数:并行效率取决于模式本身的并行度
3. 集合卡尔曼滤波(EnKF):蒙特卡洛的”分布式智慧”
核心思想:用有限个集合成员(ensemble,通常20-100个)代表概率分布,通过集合统计估计背景误差协方差。
算法步骤:
- 初始化N个集合成员(扰动初始场或参数)
- 每个成员独立向前积分到观测时刻
- 计算集合平均和集合协方差
- 根据Kalman增益更新每个成员
- 重复步骤2-4
计算特性:
| 特性 | 3DVar | 4DVar | EnKF |
|---|---|---|---|
| 背景误差协方差 | 静态假设 | 由伴随模式隐式定义 | 集合动态估计 |
| 计算成本 | 低 | 极高 | 中等(可并行) |
| 并行性 | 好 | 有限 | 极好( embarrassingly parallel) |
| 不确定性估计 | 无 | 有限 | 自然提供 |
| 非线性处理 | 弱 | 强 | 中等 |
硬件适配:
- ** embarrassingly parallel**:集合成员间无通信,适合大规模集群
- 内存需求:存储N个成员状态(N×单成员内存)
- IO密集:频繁读写成员状态
清华实践:
- 乔泽宇等基于WRF 3DVar评估AWS数据同化密度
- 地球系统数值模拟装置”寰”建立了基于”寰”的短期气候预测平台,集成9个自研数值模式+2个动力-统计方法+4个统计模型
四、前沿技术:AI大模型重构天气气候预测
1. OneForecast:清华的”图神经网络气象大模型”
2025年,清华大学黄小猛教授团队发布OneForecast:
技术突破:
- 多尺度图结构:受多重网格启发,引入区域细化的多尺度图结构
- 多相流消息传递(MSM):动态门控单元,缓解过度平滑,捕获高频信息
- 神经嵌套网格(NNG):结合边界条件和全球未来信息,实现区域高分辨率预报
性能对比:
| 模型 | 参数量 | 10天预报RMSE | 极端事件预报 |
|---|---|---|---|
| Pangu | ~1亿 | 基线 | 一般 |
| GraphCast | ~3600万 | 略优 | 一般 |
| OneForecast | 420万(仅12%) | 更优 | 准确预报台风路径 |
计算效率:
- 相比传统NWP,计算效率提高2000倍以上
- 全球10天预报可用性超过10天
- 支持100天长期稳定推理(其他模型在100天时出现物理场崩溃)
硬件启示:
- AI大模型将天气预报从”CPU密集型”转向”GPU密集型”
- 传统资料同化+AI预测形成混合架构,需要异构计算资源
2. CIESM:清华的”自主地球系统模式”
清华大学自2009年起发展CIESM(Community Integrated Earth System Model):
技术路线:
- 基于NCAR CESM 1.2.1,重点改进物理参数化方案
- 1.1版本采用谱元动力框架,参加CMIP6国际耦合模式比较计划
- 在神威太湖之光上实现百万核规模全球25km高分辨率模拟
核心创新:
- 单冰云微物理方案:被CESM2、CIESM、GRIST采纳为默认方案
- 诊断统计云宏物理方案:改善海洋低云模拟
- C-Coupler耦合器:刘利教授团队研发,实现国产耦合器从无到自主可控的突破
五、行业痛点:气候模式开发的四大”拦路虎”
痛点1:时间步长的”紧箍咒”
CFL条件限制:
- 显式时间积分要求:Δt<cmaxΔx
- 对于全球1km分辨率,若最大波速cmax=300m/s(声速),则Δt<3秒
- 模拟1年需要超过1000万步!
缓解策略:
- 时间分裂:慢过程(平流)用大步长,快过程(声波)用小步长
- 隐式或半隐式:牺牲部分并行性换取大时间步
- 水平-垂直解耦:垂直方向通常用隐式(垂直声波更快)
痛点2:并行扩展的”天花板”
强扩展限制:
- 有限差分:受stencil宽度限制,单分区不能太小
- 谱方法:全局FFT/Legendre变换的All-to-all通信限制
- 谱元法:单元间边界通信开销随分区数增加
弱扩展瓶颈:
- 固定每核网格数时,总问题规模随核数增加
- 但IO、通信、负载均衡开销随规模增长
神威太湖之光的启示:
- 从进程到线程的一整套优化方案
- 利用OpenACC/Athread众核编程接口
- 150万行代码,修改20万行,新编从核代码10万行
痛点3:物理参数化的”暗物质”
次网格过程:
- 对流、云微物理、边界层湍流等过程发生在比网格更小的尺度
- 需要用参数化方案”参数化”这些过程的影响
不确定性来源:
- 参数化方案选择(不同方案差异巨大)
- 参数调优(tuning,常被称为”黑暗艺术”)
- 方案间的耦合(如对流与云的相互作用)
痛点4:资料同化的”维度诅咒”
状态空间维度:
- 全球1°分辨率,60层,5个变量(u,v,w,T,q)
- 状态向量维度:360×180×60×5 ≈ 2000万
- B矩阵存储需要 1014 个元素(约100TB)——不可能!
简化策略:
- 控制变量变换:将物理变量转换为平衡变量(如涡度、散度)
- 谱空间截断:在谱空间只保留大尺度相关
- 局地化:假设远距离点不相关(EnKF常用)
六、硬件配置分级:从教学演示到千万核集群的四级跃迁
Level 1:教学演示级——个人工作站
定位:气候模式入门学习、理想化实验、参数敏感性测试
核心配置:
| 配件 | 推荐规格 | 说明 |
|---|---|---|
| CPU | AMD Threadripper 7970X (32核64线程) | 编译和小规模运行 |
| 内存 | 128GB DDR5-4800 ECC | 低分辨率(2-4°)全球模式 |
| 存储 | 2TB NVMe SSD | 模式源代码、输入数据 |
| 显卡 | RTX 4090 24GB | WRF-GPU版本、AI模型推理 |
| 网络 | 千兆以太网 | 单机运行,网络非瓶颈 |
可运行案例:
- WRF 30km分辨率,100×100格点,单层嵌套
- CESM/CAM 2°分辨率,短期(1-10年)积分
- OneForecast推理(全球1.5°,10天预报)
Level 2:科研进阶级——小型服务器
定位:区域气候模拟、中期天气预报、资料同化实验
核心配置:
| 配件 | 推荐规格 | 说明 |
|---|---|---|
| CPU | 双路 AMD EPYC 9655 (2×96核192线程) | 中等规模并行 |
| 内存 | 1TB DDR5-4800 ECC REG | 高分辨率区域模式 |
| 存储 | 8TB NVMe SSD + 50TB HDD | 快速IO+大容量存储 |
| 网络 | 25GbE 以太网 | MPI通信 |
| 加速卡 | 可选2× RTX Pro 6000 Blackwell | AI模型训练 |
可运行案例:
- WRF 10km分辨率,3层嵌套,京津冀区域
- WRF 3DVar同化系统,同化AWS站点数据
- CAM-SE 1°分辨率,百年尺度气候模拟
Level 3:专家级——部门级HPC集群
定位:全球高分辨率模拟、集合预报、长期气候预测
核心配置:
| 组件 | 配置要点 |
|---|---|
| 计算节点 | 64-128节点,每节点2× EPYC 9655,512GB内存 |
| 存储系统 | 1PB Lustre/GPFS并行文件系统,200GB/s带宽 |
| 网络 | 100GbE InfiniBand HDR,全 fat-tree拓扑 |
| 登录/管理节点 | 胖节点,大内存(2TB+),用于资料同化 |
| GPU节点 | 8× H100 80GB,用于AI模型训练 |
可运行案例:
- 全球25km分辨率,百年气候模拟(CIESM/CESM)
- EnKF集合预报,50个成员,10天预报
- 4DVar同化系统,6小时同化窗口
Level 4:集群级——国家级超算中心
定位:公里级全球模拟、年代际预测、多模式集合
核心配置(以神威·太湖之光为参照):
| 组件 | 配置要点 |
|---|---|
| 计算系统 | 千万核级国产众核处理器(如申威26010) |
| 峰值性能 | >100 PFlops |
| 内存 | >1 PB 分布式内存 |
| 存储 | 100PB+ 并行文件系统 |
| 网络 | 定制高速互连(如神威网) |
| 功耗 | >10MW |
运行能力:
- 全球750米分辨率大气模拟(动力框架)
- 全球5公里分辨率海气耦合(未来目标)
- 多模式CMIP6规模实验(CIESM)
清华成就:
- 2017年戈登·贝尔奖入围:千万核25km分辨率,3.4 SYPD
- 2022年IEEE TC论文:25km分辨率7.2 SYPD,100km分辨率25.6 SYPD
七、避坑指南:气候模式开发的五大陷阱
陷阱1:盲目追求高分辨率
误区:”分辨率越高,结果越好”
现实:
- 1km分辨率需要10亿+格点,计算量是10km的1000倍
- 次网格物理过程更复杂,参数化不确定性可能抵消分辨率收益
- 观测数据分辨率有限(卫星通常几十公里),资料同化困难
建议:
- 自适应网格:只在感兴趣区域加密(如WRF嵌套)
- 多尺度耦合:全球粗分辨率+区域高分辨率(OneForecast的NNG方法)
- 先验证后扩展:在低分辨率验证物理方案,再逐步加密
陷阱2:忽视编译优化和并行效率
误区:”代码能跑就行,性能优化是后期的事”
现实:
- 气候模式代码量巨大(CAM 150万行),优化困难
- 默认编译选项通常只能发挥硬件30-50%性能
- 并行负载不均衡会导致严重性能损失
建议:
- 性能分析先行:使用Intel VTune、CrayPat等工具找出热点
- 向量化:确保关键循环被SIMD向量化(AVX-512)
- 通信优化:减少MPI通信次数,合并小消息
- 清华经验:神威移植时,从核代码优化使性能提升数倍
陷阱3:资料同化系统选型失误
误区:”4DVar一定比3DVar好”
现实:
- 4DVar需要开发伴随模式,成本极高
- 对于非线性强的过程(如对流),4DVar优势不明显
- EnKF提供自然的不确定性估计,对集合预报有利
建议:
| 场景 | 推荐方案 |
|---|---|
| 业务预报,追求稳定 | 3DVar + 循环更新背景误差协方差 |
| 研究性实验,强非线性 | EnKF,50-100个成员 |
| 长期再分析,高精度 | 4DVar(如有资源开发伴随模式) |
| 混合系统 | EnVar(集合-变分混合,如WRF-Hybrid) |
陷阱4:物理参数化方案”混搭”
误区:”每个物理过程选最好的方案,组合起来一定最好”
现实:
- 不同方案可能来自不同模式,耦合时存在能量/质量不平衡
- 参数化方案之间存在复杂相互作用(如对流触发与云微物理)
- 参数调优是系统性工作,不能孤立调整
建议:
- 方案一致性:尽量使用同一套物理方案族(如CAM全套)
- 能量守恒检查:运行中监控全球能量、质量守恒
- 敏感性实验:单参数扰动实验,识别关键参数
陷阱5:IO和存储规划不足
误区:”先跑起来,存储不够再加”
现实:
- 高分辨率模式输出频率高时,一天可产生TB级数据
- 并行文件系统带宽有限,可能成为瓶颈
- 长期模拟(百年、千年)数据管理是巨大挑战
建议:
- 输出精简:只输出分析需要的变量,使用压缩(netCDF4/HDF5)
- 分级存储:热数据SSD,温数据HDD,冷数据磁带/云存储
- 诊断在线计算:尽可能在运行时计算诊断量,减少IO
八、写在最后:气候模式的未来图景
气候模式正在经历从”物理驱动”到”物理+数据双驱动”的范式转变。
短期趋势(1-3年):
- AI+物理混合模式:OneForecast这类模型将成为业务预报的有益补充
- 公里级全球模拟:5km分辨率海气耦合进入实用阶段
- 异构计算优化:国产超算(神威、曙光、天河)上的深度优化
中期趋势(3-10年):
- 数字孪生地球:高分辨率(1km)全球实时模拟
- 概率预报普及:集合预报从几十个成员扩展到数百个
- AI辅助参数化:用神经网络替代传统参数化方案
长期愿景:
- 次季节-季节(S2S)预测:将可预报性从2周延长到数月
- 气候-天气无缝预测:统一框架处理从分钟到世纪的所有时间尺度
- 地球系统全耦合:大气-海洋-陆面-海冰-生物地球化学-人类活动完整耦合
正如清华地球系统科学系在新年贺词中所言:
“遐陟艰途,砺本守初”——在艰难的科研道路上,坚守本源,砥砺前行。
从千万核并行优化到AI大模型创新,清华人在气候模式领域的探索,展现了中国地球系统科学的蓬勃生机。当算力不再成为瓶颈,当AI与物理深度融合,我们离”准确预测地球未来”的梦想,又近了一步。
文章关键词:气候模式、地球系统模式、WRF、CESM、CIESM、有限差分、谱方法、谱元法、资料同化、3DVar、4DVar、EnKF、OneForecast、黄小猛、刘利、神威太湖之光、千万核并行、戈登·贝尔奖
相关阅读推荐:
- 黄小猛 et al., arXiv 2025, OneForecast: Global-Regional Nested Weather Forecasting Framework
- 付昊桓 et al., SC17 Gordon Bell Finalist, Global Climate Model High-Performance Simulation on Sunway TaihuLight
- 刘利 et al., 北京市科学技术进步奖 2023, 地球系统模式公共耦合器平台及其应用
- 林岩銮 et al., 气候变化研究进展 2019, 清华大学CIESM模式及其参与CMIP6的方案












