
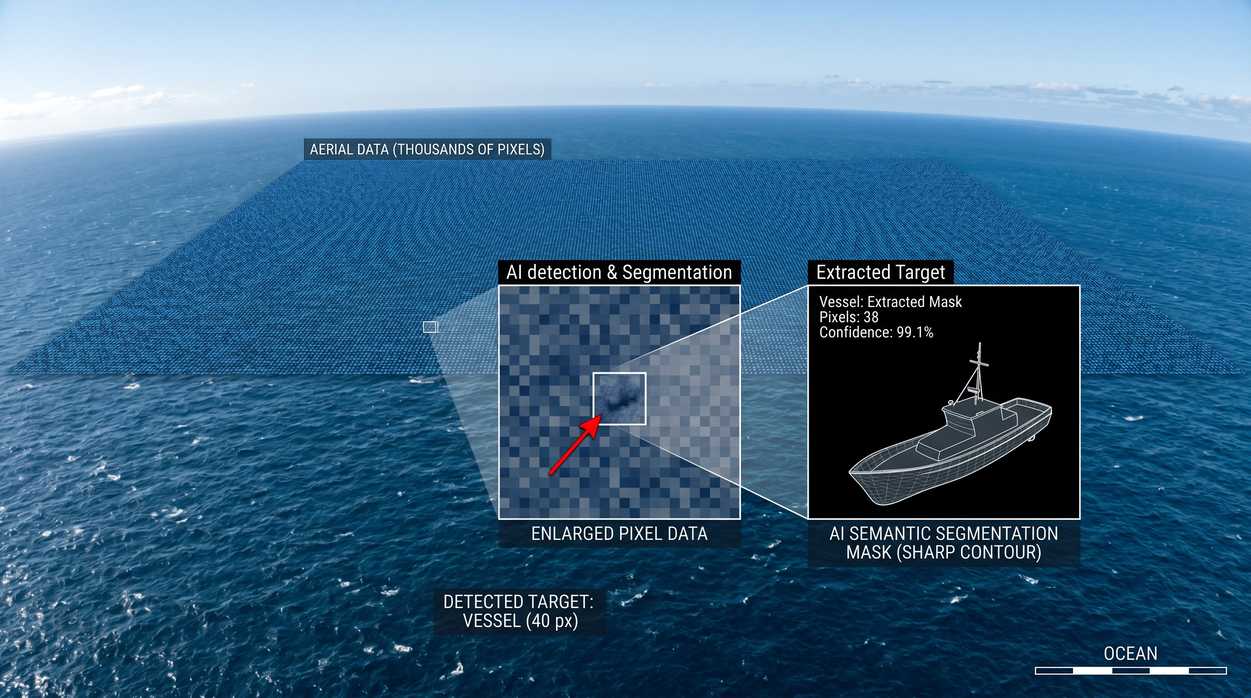
2018年,北航在国内高校中率先成立人工智能研究院(2020年1月正式挂牌),郑志明院士出任院长。七年后,研究院孵化的一个细分方向——无人机视觉目标检测——已经成了国内最活跃的研究领域之一。李露团队来自北航宇航学院,在《北京航空航天大学学报》发了无锚旋转框遥感图像船只检测的新方法,蒲良和张学军(北京航空航天大学学报,2022年第48卷第5期)更早之前就系统性地用深度学习做了无人机视角下的目标检测与跟踪。这些工作看起来是算法创新,但背后都藏着一个共同的硬件瓶颈:训练用的航拍图像分辨率动辄数千像素,一张图里要检测的目标可能只有几十个像素,这种”大图小目标”场景对显存和CPU的联合压榨远超普通图像分类。
买贵的工作站,往往是AI课题组最省钱的决定。这个说法刺耳,但算过账的人基本都认同。
8GB显存真的不够跑CV模型吗?
能跑——前提是你只跑MNIST或者CIFAR-10。无人机航拍图像的分辨率通常是1920×1080起步,遥感图像更是达到4000×3000甚至更高。YOLOv8n在输入640×640、batch=4时显存占用约4-5GB,但原图降采样到这个分辨率,小目标检测精度显著下降。
保持原图分辨率输入?单张图像的 feature map 在骨干网络里逐层膨胀,batch
size=2就能把8GB显存吃满。李露团队的无锚旋转框方法在遥感船只检测里用了多尺度特征融合,不同尺度的特征图同时驻留显存,峰值占用轻松过12GB。
更隐蔽的消耗在数据加载阶段。高分辨率图像的解码、归一化、随机裁剪和
mosaic augmentation
都在CPU上完成,然后才送入GPU。如果CPU预处理速度跟不上,GPU利用率就会忽高忽低——GPU利用率偏低可能是由于CPU预处理速度跟不上数据加载需求。
数据集存在云端,本地要什么大硬盘?
VisDrone2019-DET训练集约13GB,DOTA-v1.0约8GB(含增强和预处理后数据规模更大),再加上你自己采集的无人机航拍数据、标注结果、增强后的训练样本、多折交叉验证的子集——一个CV课题的本地数据池增长迅速。
云存储的带宽瓶颈不在下载,而在随机读取。CV训练不是顺序加载整个数据集,而是每个epoch开始前做shuffle,然后从任意位置随机抽取图像。机械硬盘的随机读取性能可能成为数据加载瓶颈,显著延长epoch启动时间。NVMe
SSD的随机读取能到每秒数百MB,数据加载流水线才不会拖后腿。
还有中间结果的累积。训练过程中每个epoch保存checkpoint、每轮验证保存预测结果、调参时保留不同超参数组合的输出——这些文件一个不漏地存在本地,方便回溯对比。长期训练会产生大量中间结果,需根据项目规模规划存储容量。
推理和训练能用同一台机器吗?
能,但会很痛苦。CV研究的workflow通常分成三段:数据预处理(CPU密集)、模型训练(GPU密集)、推理验证(GPU+IO混合)。一台机器同时承担三段任务时,资源争抢严重——你正在训练一个epoch,突然需要跑一批验证推理,训练进程就被抢占显存,要么报错OOM,要么暂停等待。
更实际的问题是,训练通常需要几天甚至几周不间断运行,推理验证却是频繁交互的——调参、看结果、改代码、再验证。让训练进程占着整台机器,其他人就什么也干不了。课题组通常将训练任务部署在高性能服务器上,同时保留中等配置设备用于快速迭代,以提高整体研究效率。
CPU在深度学习里是不是摆设?
CV训练的CPU负载比NLP高得多。文本数据是轻量的——一个batch的token序列占不了多少内存,预处理主要是embedding查找。图像数据是重型的——高分辨率图像的解码、随机裁剪、颜色抖动、mosaic拼接、归一化,每一步都在CPU上串行执行。
北航无人机视觉检测的pipeline里,原始航拍视频要先抽帧、去模糊、筛选有效帧,然后做标注格式转换和数据增强。这些前处理步骤在单线程模式下耗时较长,万张量级数据集的预处理可能成为瓶颈。高主频多核CPU配合大内存,能让预处理流水线并行化,把GPU从等待中解放出来。
另外,模型压缩和部署也是CPU活。训练好的YOLO模型要转成ONNX、做INT8量化、验证精度损失——这些操作不依赖GPU,但内存和CPU单核性能直接决定转换速度。
UltraLAB工作站配置推荐
第一档:本科/硕士课题级(5-10万)
适合跑小规模图像分类、目标检测入门(CIFAR-10/VisDrone子集)、课程设计和本科毕业设计。
- 机型:UltraLAB A350 15696-MCE
- CPU:Intel Ultra
285K(24核,8性能核全核5.5GHz/16能效核全核3.8GHz)——高主频加速图像解码和数据增强流水线 - GPU:RTX Pro 5000
48GB/1TB/s——单卡48GB显存支持中等分辨率(如1920×1080)输入的YOLOv8n
batch=4训练 - 内存:96GB DDR5——高分辨率图像批量加载+数据增强缓存
- 存储:4TB NVMe
SSD——数据集本地驻留、多版本checkpoint、增强样本缓存 - 适合课题:图像分类入门、VisDrone子集检测、课程设计、本科毕业论文
这档配置的核心价值在单卡大显存+高主频CPU。CV训练的显存消耗不是线性的——原图分辨率输入时,batch
size从2提到4,显存占用增长超过线性比例(因高分辨率下激活张量呈平方级膨胀)。48GB显存给了”大图小目标”场景足够的余量,不用被迫降分辨率牺牲精度。高主频CPU配合多线程数据加载可显著提升GPU利用率。
第二档:博士研究/进阶课题级(10-30万)
适合跑大规模遥感检测、多尺度目标跟踪、视频行为分析、多任务联合训练、硕士/博士论文。
- 机型:UltraLAB AX430 127384-MC2E
- CPU:单Xeon
金牌6530(32核,全核2.7GHz/最高4.0GHz)——32核并行数据预处理、多fold交叉验证 - GPU:双RTX 6000D
84GB(2×1.6TB/s)——双卡168GB显存,支持大分辨率输入+多尺度特征融合 - 内存:384GB
DDR5——多数据集同时驻留内存、大batch数据增强全缓存 - 存储:4TB NVMe
SSD——完整DOTA/VisDrone、视频帧序列、多版本模型权重、实验日志 - 适合课题:遥感图像全分辨率检测、视频目标跟踪、多任务联合训练、硕士/博士论文
这档配置的升级逻辑在双卡显存叠加+CPU并行。遥感图像检测有一个算力陷阱:你以为瓶颈在模型训练,实际上当你同时加载RGB影像、高程数据和语义标注做多模态融合时,三种模态的batch
tensor各自需要独立的显存空间,再加上去耦电容模型的频变参数,单卡48GB显存在同时加载多模态数据时可能不足。双6000D的168GB显存允许你在同一设备上跑多模态联合训练,不用把数据拆成两半分别训练再手工合并。
第三档:课题组公用/AI平台级(30-100万+)
适合跑大规模视频分析、多课题组共享、承接视觉AI项目、支持多人并行训练与推理。
GX660M 227512-MD4E:
- CPU:双Xeon
金牌6530(64核128线程,全核2.7GHz/最高4.0GHz)——多用户同时提交训练、推理、数据预处理任务 - GPU:4块RTX 6000D
84GB(4×1.6TB/s)——总计336GB显存,多分辨率模型并行训练 - 内存:512GB DDR5——课题组级数据集全内存驻留;视频帧序列全缓存
- 存储:8TB NVMe
SSD——多人共用长期项目,原始数据+增强数据+模型库+实验历史 - 适合课题:课题组视觉AI平台、大规模视频分析、遥感AI项目、多人并行训练
GX660M 227768-MD6E(顶配版):
- CPU:双Xeon
金牌6530(64核128线程,全核2.7GHz/最高4.0GHz)——同上 - GPU:6块RTX 6000D
84GB(6×1.6TB/s)——总计504GB显存,超大规模模型或多课题组共享 - 内存:768GB DDR5——超大内存,支持最复杂视频分析全缓存
- 存储:8TB NVMe SSD——同上
- 适合课题:国家级视觉AI平台、超大规模遥感分析、多课题组共享、跨域视频理解
这档配置的定位是课题组CV算力的中枢节点。计算机视觉方向的课题组通常同时推进多个子方向:有人做目标检测、有人做语义分割、有人做视频跟踪、有人做三维重建——每个方向都需要独立的训练进程。GX660M的多GPU允许不同课题独立运行;512GB内存支撑最大规模数据集的全内存分析;冗余电源设计可在单一电源模块故障时维持系统运行,降低长时间训练的中断风险。
选工作站别踩这些坑
误区一:只看GPU型号,忽视显存对CV训练的重要制约。 RTX
4090的游戏性能很强,但24GB显存跑4K分辨率输入的检测模型,batch
size=1就报警。CV训练的batch
size直接影响收敛稳定性,显存不够被迫降分辨率或降batch,精度损失和训练时间增加都是隐性成本。
误区二:用消费级显卡跑长期训练。
CV模型的训练周期通常以天为单位,消费级显卡的散热设计和驱动稳定性不适合7×24小时满载运行。Pro系列的ECC纠错能捕获显存中的静默错误,对数值敏感的梯度计算很关键——静默错误可能在训练后期才表现为精度异常,追踪调试成本高昂。
误区三:存储容量规划不足。
CV项目的本地数据池(原始数据+增强数据+多版本模型+实验日志)增长迅速,需根据项目规模规划存储容量。视觉AI研究中,早期基线模型可能在后续对比实验中需要回溯调用。8TB起步是刚需。
误区四:用笔记本电脑做CV训练。
笔记本的散热设计让GPU无法持续满载,长时间训练会触发降频保护,实际算力低于标称值。屏幕尺寸也限制了可视化调试的效率——4K图像里的几十像素小目标,在15寸屏幕上根本看不清标注质量。本地塔式工作站是CV研究的刚需。
误区五:忽视数据预处理对CPU的压榨。
CV训练不是GPU独角戏,高分辨率图像的解码、增强、格式转换在CPU上串行执行。低主频CPU配高端GPU的组合,GPU利用率会长期在50%以下波动——低主频CPU可能无法及时完成数据预处理,导致GPU利用率偏低。
结语
北航人工智能研究院从2018年成立走到今天的无人机视觉检测和遥感图像识别,八年里CV技术从手工特征走到了端到端深度学习。学生在本科阶段接触图像处理和经典算法,到了研究生阶段就需要处理高分辨率航拍图像、多模态遥感数据和大规模视频序列——这些环节的算力需求,普通笔记本撑不住。
从配置合适的工作站开始,在本地完成4K航拍图像小目标检测精度优化、多模态遥感数据融合模型训练和视频跟踪实时性评估——再把验证好的模型部署到无人机或卫星平台上——这是计算机视觉研究的正常节奏。建议CV方向的师生优先选择显存充足、CPU高主频、存储容量大且数据读取速度快的塔式工作站,以支撑高分辨率图像训练、多模态数据融合和大规模视频分析的需求。
微信号:maxftxwx












