
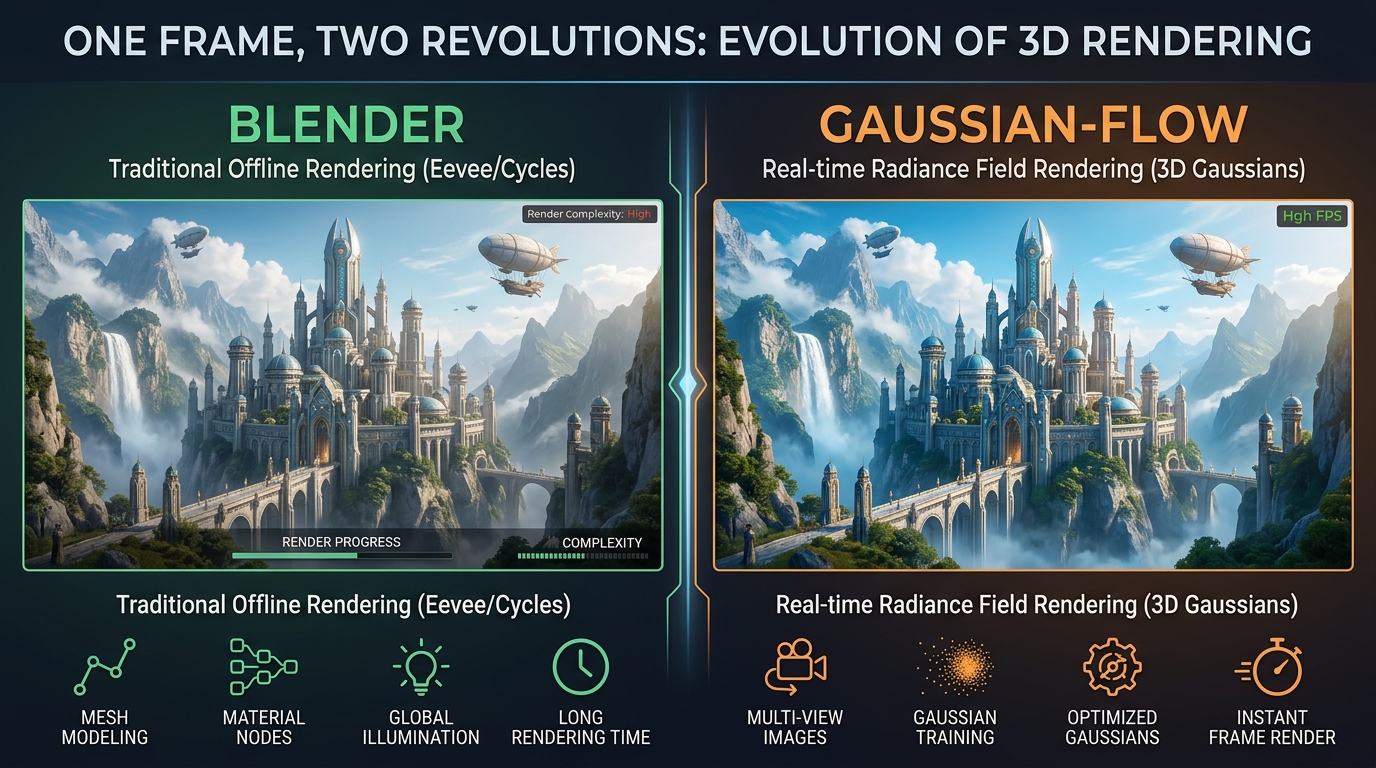
引子:一帧画面的两次革命
2025年7月,开源三维创作软件Blender发布4.5 LTS长期支持版,继续改进Cycles渲染引擎,自适应细分的多线程性能最高提升14倍,凹凸映射也得到了增强,官方承诺维护至2027年;仅仅四个月后,Blender 5.0正式亮相,带来全新色彩管理管线,同时收紧硬件门槛——Cycles的GPU渲染不再支持GeForce 900系列之前的显卡。几乎同一时期,南京大学智能科学与技术学院姚遥副教授团队提出的Gaussian-Flow方法被CVPR 2024接收并遴选为大会亮点工作(Highlight,接受率2.8%),该方法将动态场景四维渲染的时间从每帧2秒大幅缩短至0.008秒。
一个是软件生态的转向,一个是研究前沿的突破,指向同一个事实:三维渲染已经全面进入GPU主导的时代。对工业设计专业的学生和从业者来说,这场变革直接改写了一台电脑该有的样子。
第一章 研一:游戏本上的第一个模型
2023年9月,小李背着一台游戏本走进设计学院的机房。 Rhino里拉曲面、KeyShot里打灯光,课程作业不过是一个水杯、一把椅子,几十万面数的模型,游戏本还能从容应付。渲染一张产品效果图要十来分钟,他泡杯咖啡回来看结果,觉得三维世界的大门不过如此。
这个阶段的需求很诚实:CPU主频决定建模时视口的顺滑程度,入门级显卡足以应付简单场景的实时预览。绝大多数人的第一台机器,确实可以是笔记本。
第二章 硕士中期:第一次扩容——先膨胀的是模型
转折出现在导师的项目里。一套概念交通工具的设计方案,车体曲面加上内饰细节,模型面数从几十万涨到两千多万,贴图从2K升到4K,场景里还要摆环境道具。游戏本开始力不从心:视口旋转像幻灯片,渲染时直接提示显存溢出。
技术上,这对应两个明确的分工。建模与编辑阶段吃的是CPU单核性能和内存容量,曲面求值、布尔运算都依赖高频处理器;渲染阶段吃的是GPU,路径追踪要模拟海量光线在场景中的弹射,天然适合GPU的并行架构。OctaneRender官方给出的数据是,同等画质下GPU渲染速度可达CPU渲染的10~50倍。Blender 5.0敢于放弃老显卡,底气正在于此——GPU渲染已经是默认答案,老硬件留着也没有意义。
第一次扩容的结论很朴素:建模渲染工作站,GPU权重必须排在CPU之前,但CPU主频不能塌、内存不能小。一台桌面级图形工作站,是硕士阶段最务实的选择。
第三章 博士开题后:第二次扩容——光线追踪与AI渲染
博士课题的方向是数字化设计与人机交互评审,需要把设计方案放进虚拟展厅,用全局光照呈现材质在真实光照下的质感。这时瓶颈从”快慢”变成了”真假”。
真实感渲染的核心是路径追踪:从相机出发,每像素发射数百至数千条光线,模拟它们在金属、玻璃、织物表面的反射、折射与散射,直到能量收敛。这种计算的复杂度与材质反射率、光源数量成正比,玻璃和抛光金属是最耗算力的材质。现代GPU用专门的RT Core硬件加速光线与场景加速结构的求交,用Tensor Core运行AI降噪模型——只渲染少量采样,再靠神经网络把噪点抹平,画质无损、时间大减。
另一个变量来自研究前沿。南京大学姚遥副教授团队的Gaussian-Flow把三维高斯泼溅从静态场景推进到动态场景,用结合时域与频域的三维高斯粒子运动模型描述复杂运动,四维渲染做到0.008秒每帧,这意味着从视频直接重建可实时漫游的真实场景正在成为现实。对工业设计而言,这类神经渲染技术的落地路径清晰可见:产品还没开模,真实感数字孪生已经能让客户在虚拟空间里转着看了。
博士阶段的工作站要兼顾两条线:一条是 GPU 渲染的大场景、高采样,一条是本地跑AI推理与轻量训练。显存容量第一次成为硬指标——场景上限由显存决定,显卡算力只决定渲染快慢。
第四章 课题组公用平台:第三次扩容——从单机到渲染队列
师弟师妹加入后,实验室出现了典型的资源争抢:有人要渲动画序列,有人要跑AI模型,还有人要开评审会实时演示。一台机器再强,也只能排队。
课题组的解法是平台化。多卡并行渲染时,每张卡独立完成一部分帧或一部分像素再合成,显存无法跨卡堆叠,单卡显存仍要装得下整个场景——所以大场景的门槛并没有因为多卡而消失,每张卡的显存都得够。与此同时,AI辅助设计的负载也来了:文生图草图、材质生成、渲染参数推荐,这些任务要长期占用GPU。课题组级平台的价值在于把这些负载统一调度,再配合大容量内存与高速存储,让渲染队列、建模工位、AI推理服务各得其所。
如果他们一开始就知道
回头看这条升级路线,几乎每个节点都有本可以避开的弯路。
- 别把预算全砸在CPU上。渲染时代GPU是主角,但建模阶段CPU主频也不能塌,均衡比偏科重要。
- 显存买大不买小。性能不足只影响快慢,显存不足直接让场景打不开,这是”能不能”和”快不快”的区别。
- 内存与存储是隐形瓶颈。4K贴图、多软件并行、素材库随机读写,64GB内存是底线,固态硬盘容量决定素材库能有多大。
- 显示器是专业设备。设计评审看的是颜色,色域覆盖与色准不合格,渲染再好也会被打回。
- 给AI负载留余量。本地大模型正在变成设计流程的标配,买机器时就要想好这块算力放哪。
AI大模型本地部署:让工作站兼做设计大脑
设计行业对本地大模型有一个天然的理由:保密。未发布的产品外观、甲方资料、竞赛方案,上传到公有云模型服务存在泄密风险,而本地部署的数据不出机房。离线可用与长期成本是另外两个现实考量——按次调用的API费用随团队规模累积,远不如一次投入。
结合三维建模与渲染场景,两类开源模型值得关注。一是稠密模型的代表 Qwen2.5-32B-Instruct,参数量32.5B,支持128K长上下文,适合做渲染参数问答、设计素材库检索、方案文案生成;二是混合专家架构的 Qwen3-30B-A3B,总参数30.5B、每次推理仅激活约3.3B参数,128个专家按需调用,同等显存下推理吞吐量更高,适合多人共用的课题组平台。
显存估算遵循一个简单公式:所需显存约等于参数量(B)乘以量化字节数再乘以1.2(KV cache与系统开销预留)。FP16每参数2字节,Q8每参数1字节,Q4每参数0.5字节。两个具体算例:Qwen2.5-32B-Instruct做Q4量化,32乘以0.5乘以1.2约等于19.2GB,24GB显存可以从容运行;若用FP16全精度,则需要约77GB显存,只有大显存专业卡才能装下。Qwen3-30B-A3B要特别注意一点:MoE模型显存按总参数30.5B计算,不按激活参数,Q4量化同样需要约18GB起步,激活参数小省的是算力,省不了显存。
量化等级的取舍很实际:FP16无损但体积翻倍,Q8损失微小、体积减半,Q4体积只有四分之一、是消费级显卡的默认选择,多数问答场景下精度损失可感知度很低。速度量级上,CPU纯内存推理通常只有个位数tokens/s,单卡GPU推理可达几十到上百tokens/s,这正是工作站与普通电脑的分水岭。推理之外还有微调:用LoRA对32B级模型做领域适配,显存增量约3~5GB,单张24GB显卡仍有空间;而全参数微调7B模型就需要80GB以上显存,那是另一个量级的投入,选购机器时必须想清楚自己停在推理还是走向训练。
主要软件
三维建模与渲染的工具链分四层,各层对硬件的诉求不同。
建模层,Rhino是工业设计NURBS曲面的主流选择,常与Grasshopper参数化插件搭配;SolidWorks、CATIA偏工程曲面与结构设计;Blender、Cinema 4D、3ds Max覆盖多边形建模与视觉表现。
渲染层,KeyShot以快速产品渲染著称,CPU与GPU双模式,上手门槛低;Blender Cycles是免费的路径追踪方案,借助OptiX在NVIDIA显卡上效率出色;V-Ray、Octane、Redshift在建筑与影视领域根基深厚,其中Redshift官方称GPU渲染比CPU渲染器快数倍;D5渲染器是国内团队开发的实时光线追踪渲染器,面向建筑与室内表现;Unreal Engine 5的Nanite与Lumen则把千万面级场景的实时漫游变成常规操作。
AI辅助层,Stable Diffusion类文生图工具用于概念草图发散,ComfyUI作为节点式工作流把生成流程工业化,这部分负载独占GPU,最好与渲染时段错开。
后期层,Photoshop处理贴图与修图,After Effects做动画合成,DaVinci Resolve负责调色与剪辑,这类软件吃内存带宽与存储速度。
算力工作站配置推荐
从软件清单能看明白一件事:三维建模与渲染的负载横跨CPU单核性能、GPU并行算力、显存容量、内存带宽与存储IO五个维度,任何一项短腿都会让整机体验失衡。而工业设计的算力需求又有一个残酷规律——它随项目复杂度跳变,今天够用不代表明年够用。下面按学习与研究的时间线整理四档配置,从个人桌面到课题组平台,各档对应的正是前文每一章的痛点,你可以对号入座,也可以把它当作采购申请里的预算框架。
方案A:本科毕设与研一入门
适用场景:课程作业级建模、小型产品渲染、简单动画,顺带体验7B~14B级大模型推理。
推荐机型:A350 15064-MBX
- CPU:Intel Ultra7 265K(20核,8P核5.1GHz)+水冷(5.1GHz为全核超频实测优化频率)
- GPU:RTX5060Ti 16GB
- 内存:64GB DDR5
- 系统盘:4TB NVMe
- 数据盘:8TB SATA
- 显存:16GB
- 显存带宽:448.0 GB/s
方案B:硕士课题主力
适用场景:中大型场景GPU渲染、4K贴图项目、KeyShot与Blender Cycles日常出图,32B级大模型Q4量化本地推理的入门线。
推荐机型:A350 153128-MCT
- CPU:Intel Ultra9 285K(24核,8P核5.6GHz)+水冷(5.6GHz为全核超频实测优化频率)
- GPU:RTX5090D v2 24GB+水冷
- 内存:128GB DDR5
- 系统盘:4TB NVMe
- 数据盘:8TB SATA
- 显存:24GB
- 显存带宽:1.34 TB/s
方案C:博士课题与AI渲染方向
适用场景:路径追踪高采样渲染、神经渲染实验、本地部署Qwen2.5-32B-Instruct与Qwen3-30B-A3B做设计助手,兼顾LoRA轻量微调。
推荐机型:AR350 148192-MCT
- CPU:AMD锐龙9950X3D(16核,4.8~5.7GHz)+水冷(5.7GHz为全核超频实测优化频率)
- GPU:RTX 4090 48G+水冷
- 内存:192GB DDR5
- 系统盘:4TB NVMe
- 数据盘:8TB SATA
- 显存:48GB
- 显存带宽:1.01 TB/s
方案D:课题组共享平台
适用场景:多人渲染队列、多卡并行出图、AI推理服务常驻,建模工位与渲染任务统一调度,支撑一届又一届学生的毕业周期。
推荐机型:GX660M 227384-MD4T
- CPU:2×Xeon金牌6530(64核,2.7~4GHz)(4GHz为全核超频实测优化频率)
- GPU:4×RTX 4090 48G 水冷
- 内存:384GB DDR5
- 存储:8TB NVMe
- 显存:192GB
- 显存带宽:4×1.01 TB/s
常见FAQ
建模和渲染,哪个更吃显卡?
建模编辑阶段主要依赖CPU主频与内存,显卡负责视口预览;渲染阶段GPU是绝对主角,尤其是路径追踪类渲染器。如果预算有限只能倾斜一处,渲染占比高的工作流优先保显卡。
游戏卡和专业卡用于渲染差距大吗?
同代架构下,纯渲染速度差距没有价格差距那么悬殊,专业卡的优势在大显存、ECC显存纠错、多卡稳定性与专业驱动认证。学生与个人创作者用高端游戏卡性价比更高,企业与课题组长时间满载渲染,专业卡的稳定性价值会体现出来。
内存64GB够不够?
只做单模型渲染勉强够,一旦贴上4K贴图、开多软件并行、跑AI生成,64GB就是底线。博士课题与课题组平台建议直接128GB起步,内存不足导致的卡顿比CPU慢更难忍受。
笔记本外接显卡坞能替代图形工作站吗?
临时救急可以,长期主力不行。雷电接口带宽会限制显卡性能释放,供电与散热也压不住长时间满载渲染,外设成本累积下来接近一台入门级工作站。
本地部署大模型对设计学习有什么实际帮助?
三类用法已经比较成熟:渲染参数与软件操作的问答助手、设计素材与论文库的本地检索问答、方案说明与展示文案的初稿生成。涉密项目资料全程不出本机,这是云端服务替代不了的价值。
课题组有一台服务器了,还需要图形工作站吗?
需要,两者分工不同。服务器适合排队批渲与模型服务,但没有专业图形驱动的桌面交互体验,不适合建模与实时评审。一台共享服务器加若干台个人图形工作站,是多数设计课题组的高效组合。
结语
从游戏本到桌面工作站,从单卡到课题组平台,这条升级路线里没有一步是白走的——每一轮扩容都对应着模型规模、画质要求与协作人数的跳变。算力需求从不会线性增长,它总是指数级地扑过来。能提前看清下一站在哪的人,至少不会在毕业季排队等渲染。
欢迎咨询~
微信号:maxftxwx
fuyiqin@xasun.com












