
1998年,西安交通大学在机械工程一级学科下设立工业设计系。五年后,这个专业成为中国大陆首个加入世界设计组织WDO(原国际工业设计协会ICSID)的成员。ICSID在2004年前来考察时的评语是:这里的工业设计教育”符合世界上最现代的工业设计教育计划”。2022年,这个专业获批国家级一流本科专业建设点。二十五年间,西安交大工业设计从一棵幼苗长成了中国工业设计教育版图里的一棵大树。
但2025年的工业设计课堂正在发生一场静悄悄的革命。学生打开Grasshopper参数化设计面板,输入一组约束条件——材料类型、载荷上限、制造工艺——然后点击”生成”。几秒钟后,屏幕上出现几十个形态各异的产品外壳,有的像骨骼,有的像蜂窝,有的像树枝分叉。这不是设计师一笔一画画出来的,是算法在材料与力学的边界上自动探索出来的。这就是生成式设计(Generative Design),也叫创成式设计。西安交大工业设计系与米兰理工大学合办的联合设计与创新学院里,参数化设计和数字化设计早已是核心课程。蒋维乐教授在2025年5月的青年艺术家沙龙上谈到:AI已经不再是单纯的执行者,而是变成了灵感激发者。设计的主导权仍然在人类手里,但算法打开的搜索空间,远比一个设计师的直觉要大得多。
西安交大工业设计系的学生在国际竞赛中表现抢眼。联合设计与创新学院的师生团队获得过红点奖、iF设计奖、戴森设计奖等28项国家级奖。2025年展出的作品《MWRQ-R》是一款模块化轮腿式四足机器人,获得德国iF设计奖。另一件作品《MarAIne Guitar》则直接展示了从AI生成式概念到仿生设计的完整流程——算法先根据海洋灵感生成概念形态,设计师再从中筛选并优化。这种”人机协作”模式,正在重新定义工业设计的工作方式。
这场革命的底层不是审美,而是算力。生成式设计的本质是把拓扑优化、多目标遗传算法和CAD几何重建堆在一起,让计算机在参数空间里自动搜索满足力学性能、制造工艺和美学约束的最优形态。每一个候选方案的背后,都是一次有限元分析。几十上百个方案同时评估,意味着几十上百次FEA求解。这不是一台普通笔记本能扛得住的活。
拓扑优化:从猜形状到让材料自己找路
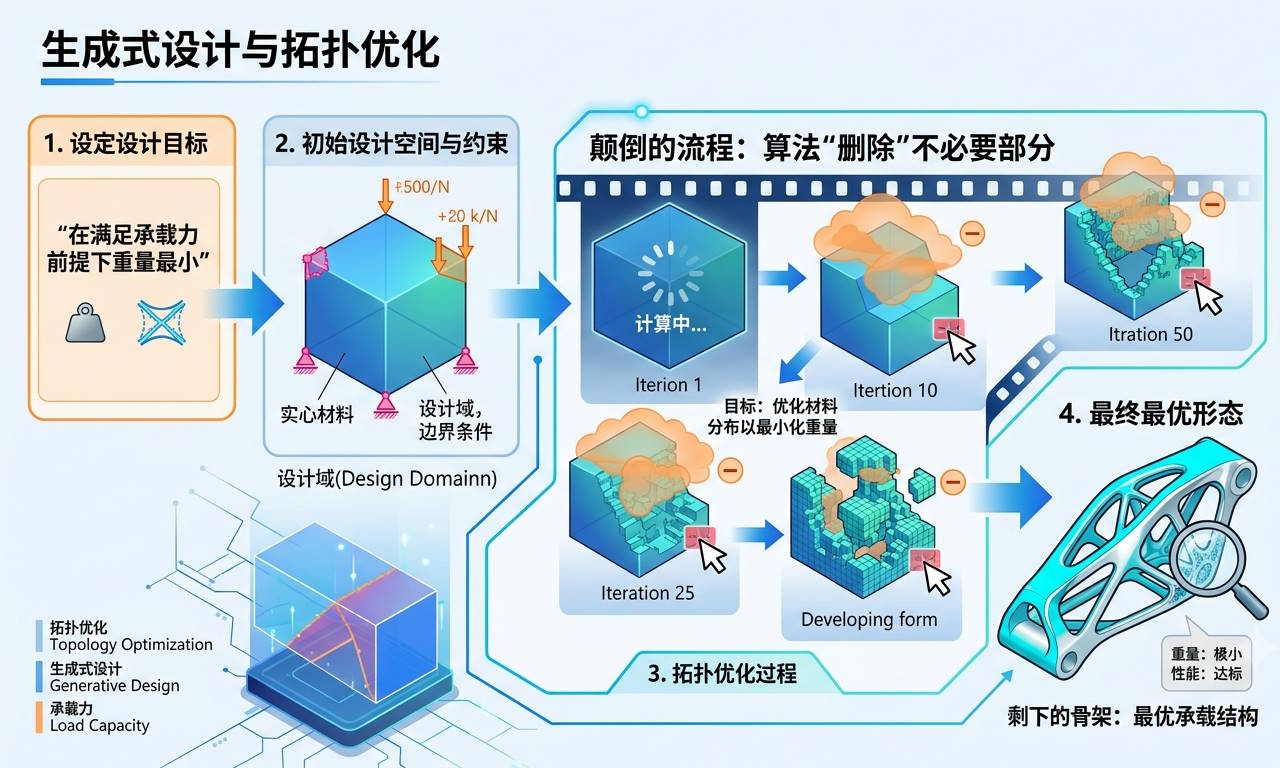
传统产品设计的流程是反的。工程师先凭经验画出一个形状,然后扔到CAE软件里做仿真,看应力是否超标,看变形是否在允许范围内,然后返回CAD修改,再仿真,再修改。这个循环可能跑几十轮。生成式设计把这个流程颠倒过来:你先告诉计算机设计目标——比如”在满足承载力的前提下重量最小”——然后让算法从一块实心材料里”删除”不必要的部分,最终剩下的骨架就是最优形态。
这个方法叫拓扑优化(Topology Optimization),最早追溯到1988年Bendsøe和Kikuchi提出的均匀化方法。后来演化出了SIMP(Solid Isotropic Material with Penalization)方法,也就是目前绝大多数商业软件采用的密度法。核心思路很简单:把设计域划分成成千上万个有限元网格,每个单元赋予一个密度变量(0到1之间)。0表示该处没有材料,1表示实心材料。优化算法通过迭代调整每个单元的密度,在满足应力、位移等约束的前提下,让总体重量最小化。乍一听很直观,实际算起来却是一场浩大的数值工程。
一个中等复杂度的产品外壳,如果网格剖分到毫米级,轻易就能达到百万级别单元数。每一次迭代都需要求解一次大型有限元方程组。SIMP算法通常需要跑几百甚至上千次迭代才能收敛。这背后是几百上千次百万阶稀疏矩阵的求解。如果再加多目标约束——比如同时要求最小重量、最小变形、一阶固有频率避开某个区间——问题就从单目标优化变成了多目标遗传算法的搜索,计算量呈指数级增长。
SIMP算法的数学本质是密度法。它在每个有限元单元上定义一个伪密度变量ρ,取值范围0到1。优化目标通常是最小化柔度(即最大化刚度)或最小化重量。约束条件包括体积分数上限、最大应力、最大位移等。算法通过灵敏度分析计算目标函数对每个单元密度的偏导数,然后用优化求解器(如MMA移动渐近线法或OC优化准则法)更新密度场。为了避免棋盘格现象和网格依赖性,需要引入过滤技术——比如密度过滤或灵敏度过滤——对密度场进行平滑处理。这些过滤操作本身就需要在整个网格上做卷积运算,进一步增加了计算量。
2015年,空客公司借助Autodesk的生成式设计工具,为A320客机开发了一款仿生隔板。传统隔板是铝制框架加铆接板,重量不轻。算法在约束条件下生成了一个仿生结构,像鸟类的骨骼一样中空分叉,最终减重45%。这个案例被写进了几乎所有生成式设计教科书。但它没有告诉你的是:这个隔板的几何形状无法直接加工。拓扑优化出来的结果是一团多面体网格,没有光滑曲面,没有可编辑的CAD边界。工程师花了大量时间把它重新拟合成B-Rep(Boundary Representation)模型,才能送进加工车间。
从多面体到可制造:B-Rep重建的算力黑洞
SIMP算法输出的是一堆带密度值的六面体或四面体网格。密度值接近1的保留,接近0的删除。结果像一块被虫蛀过的木头,表面粗糙,充满锯齿。这个模型不能直接进入数控加工,也不能直接用于后续的工程制图或装配检查。拓扑优化的后处理环节,才是整个流程中最啃硬件的部分。
传统做法是靠工程师手动在CAD软件里重新描线、建面、做圆角。一个复杂结构可能要花数周时间。2017年,西门子在NX平台引入了”收敛建模”(Convergent Modeling)技术,把多边形网格(Facet)和精确B-Rep几何融合在一个统一的数据结构里,允许用户直接对拓扑优化结果进行布尔运算、倒角和偏移。这意味着拓扑优化的网格可以直接被后续设计流程使用,而不需要完全重建。Autodesk在Fusion 360里走的是另一条路:把拓扑优化结果送到云端,通过云端算力做自动平滑和拟合,然后返回一个近似可编辑的实体模型。
但无论哪种路线,几何重建都是计算密集型任务。网格平滑需要求解拉普拉斯方程或进行最小二乘拟合。把百万级多面体转换成NURBS曲面,涉及到曲面片分割、参数域展开、边界连续性的全局优化。这些操作在CPU上是单线程或轻量级多线程的,对主频敏感,但对核心数并不完全线性扩展。一个八核高频处理器可能比三十二核低频处理器完成得更快。
2024年,Autodesk提出了一种叫BrepGen的方法,首次用深度生成模型直接输出闭合的B-Rep CAD模型。它基于扩散模型,在隐空间中联合建模几何与拓扑信息,最终生成水密的三维实体。这听起来很美好,但训练这样的模型需要数百万条CAD建模语料。Onshape发布的公共CAD语料库包含超过470万条草图样本和建模操作记录。把这些序列喂给Transformer模型,本身就是一场算力消耗。推理阶段虽然比训练快,但生成一个复杂零件的几何结构仍然需要数秒到数十秒,而且通常需要多次采样才能找到一个满足制造约束的结果。
实时渲染与交互反馈:设计师关注的不是数值本身,而是形态特征
生成式设计不能脱离人的判断。算法可以生成一百个候选方案,但哪个好看、哪个好加工、哪个符合品牌设计语言,最终还是要设计师来定。这就意味着系统必须提供实时、高质量的渲染预览,让设计师在参数调整的同时立即看到形态变化。
KeyShot是工业设计领域最常用的渲染器之一。2025年发布的KeyShot Studio 2025.2引入了AI背景生成和风格转换,同时支持AMD GPU的实验性渲染加速。工业设计里最吃性能的阶段,往往发生在交互过程中的实时预览。设计师拖动一个参数滑块,Grasshopper里的几何模型立即重建,然后送入实时渲染管线。这个链条上的每一个环节都在消耗资源:参数化几何重建(CPU)、曲面细分和网格化(CPU/GPU)、光线追踪或光栅化渲染(GPU)、材质和纹理计算(GPU显存)。
Grasshopper作为Rhino的参数化插件,其数据流是节点式的。每个节点执行一个几何操作——布尔运算、曲面偏移、网格重构、阵列复制——然后把结果传递给下游节点。当节点数量达到数百个,或者处理复杂NURBS曲面时, Grasshopper的求解器会明显变慢。很多核心几何操作(如曲面求交、布尔并集)在底层调用的是Rhino的C++几何内核,但Grasshopper的节点调度和数据类型转换开销是用C#管理的。这意味着单个复杂节点的计算时间可能从几秒延长到几十秒,而设计师在调参时通常希望响应时间控制在毫秒级。
当产品形态变得复杂——比如一个带内部加强筋的无人机机架,或者一个仿生结构的自行车把立——实时渲染的网格面数可能达到数百万甚至上千万。RTX显卡的硬件加速光线追踪(OptiX)可以分担一部分负担,但显存容量直接决定了能加载多大的场景。24GB显存可以应付大多数单体产品,但如果要做整机装配的可视化,或者同时对比十几个候选方案的渲染阵列,显存压力会急剧上升。
虚幻引擎5的Nanite虚拟几何技术声称可以处理”亿级面片”,但那是针对游戏场景优化的技术路线。工业设计里的高精度NURBS曲面转换成三角形网格时,对曲率变化大的区域需要极高的细分密度,否则反光边缘会出现锯齿。KeyShot和V-Ray这类工业级渲染器对几何精度要求更苛刻,直接决定了最终产品评审图能不能让客户签字。
算力账单:生成式设计到底在烧什么硬件
把上面这些环节放在一起,生成式设计的硬件需求画像就清晰了。
CPU:拓扑优化的有限元求解是稀疏线性方程组的迭代解法。每个时间步(或优化步)需要组装刚度矩阵、求解位移场、计算应力。百万级网格的刚度矩阵是稀疏的,但非零元素分布不规则。直接求解器(如PARDISO、MUMPS)适合中小型问题,大型问题通常用迭代求解器(如CG、GMRES)配合AMG预处理。这些操作的多线程扩展性中等,通常在8到16核之间达到拐点。核心数再多,边际收益递减。但频率直接影响单步求解时间,所以高频处理器有明显优势。对于参数化设计和CAD几何操作,单线程性能更为关键。Rhino和Grasshopper的很多操作是单线程的,主频高低直接决定拖动参数时的响应速度。
对于多目标遗传算法,情况更复杂。NSGA-II或MOEA/D这类算法需要维护一个种群,每个个体对应一套设计方案。评估每个个体时都要运行一次完整的FEA求解。如果种群大小设为50,代数设为100,那就是5000次独立的FEA求解。这些求解之间是独立的,可以完全并行。但并行度受限于处理器核心数和内存容量。50个个体同时求解,意味着50份网格数据、50个刚度矩阵、50组位移场同时驻留内存。如果单个模型占用8GB,50个并行实例就需要400GB内存。这就是内存成为瓶颈的原因。
GPU:GPU的作用在三个环节。一是拓扑优化的加速求解。有些商业软件(如Altair、ANSYS Discovery)支持GPU加速有限元求解,提升最高可达10倍。二是实时渲染预览。显存容量决定了能加载的模型规模,显存带宽决定了纹理和几何数据进出GPU的速度。三是AI生成模型的推理。BrepGen这类深度学习模型,如果要在本地运行,需要CUDA加速。训练这类模型几乎一定需要多卡集群,但本地推理一张高端消费级或专业卡就能应付。
内存:拓扑优化对内存的消耗经常被低估。百万网格的3D实体模型,每个节点6个自由度,刚度矩阵的非零元素存储在CSR格式下,占用内存轻易达到几十GB。如果跑多目标遗传算法,需要同时维护几十个个体的种群,每个个体都要保存一套几何和物理场数据,内存占用成倍增长。128GB是起步线,256GB到512GB才能处理大型装配体的生成式设计。另外,内存带宽影响稀疏矩阵向量乘法的速度,DDR5的高带宽在这里有价值。
存储:生成式设计的一个特性是版本爆炸。一次优化可能产生上百个候选方案,每个方案都保存为独立的CAD文件或网格文件。加上迭代过程中的中间状态,一个项目的文件总量可能达到数百GB。NVMe SSD的读写速度决定了加载和保存大文件时的等待时间。如果项目涉及多物理场耦合(比如同时优化结构性能和散热性能),还需要存储温度场、流场等结果数据,对存储容量的需求更高。对于需要频繁迭代的设计团队,配置一块高速NVMe SSD作为工作盘,再另配大容量SATA硬盘做归档存储,是更务实的方案。
为什么现在要聊配置
写到这里,你可能已经看明白了:生成式设计不是”用AI代替设计师”那么简单。它是一个把拓扑优化、几何重建、实时渲染和AI推理串在一起的复杂流水线。每个环节都有自己的硬件瓶颈,而且这些瓶颈会随着模型规模增大而急剧恶化。一个学生在课程作业里用几万个网格跑拓扑优化,一台普通工作站就能应付。但当他进入毕业设计或企业项目,面对百万级网格、多目标约束、多物理场耦合,硬件天花板就会撞上来。
西安交大工业设计系的学生在设计竞赛里拿过红点奖、iF奖、戴森奖。这些竞赛项目里的概念产品,很多已经用上了参数化生成和拓扑优化。当你在凌晨两点调参,希望赶在截止日期前生成最后一组候选方案,工作站能不能在十分钟内给出结果,而不是让你等到天亮——这直接决定了设计竞赛的名次,也决定了你拿到大厂offer的机会。
下面这几套配置,从入门级课程作业到企业级大型装配体优化,覆盖生成式设计的主要算力场景。所有硬件参数均来自UltraLAB产品目录和基准报价表,不凭记忆编造。
方案A:入门级——课程作业与参数化设计
适用场景:Grasshopper参数化建模、小规模拓扑优化(10万网格以下)、KeyShot基础渲染、课程项目与毕业设计前期探索。
推荐机型:UltraLAB A350 15364-MBT
- CPU:Intel Core Ultra 7 265K,20核(8P全核5.3GHz/12E全核3.8GHz),产品手册标注为全核超频实测优化频率,Intel官方标称P核基础3.7GHz/TVB最高5.5GHz
- GPU:NVIDIA RTX 5090D v2 24GB 水冷,显存带宽1.3TB/s
- 内存:64GB DDR5
- 存储:2TB NVMe SSD(产品目录标称14GB/s读取带宽)
- 显存带宽:1.3TB/s
这套配置的核心优势是单核高频。Grasshopper和Rhino的操作响应高度依赖主频,20核中的8个P核在5.3GHz下运行,拖动参数滑块时几乎无延迟。RTX 5090D v2的24GB显存可以加载中等复杂度的产品模型,KeyShot实时渲染和GPU加速求解都能获得不错的体验。64GB内存对十万级网格的拓扑优化够用,但跑多目标遗传算法时可能需要关掉其他程序释放内存。适合工业设计本科阶段的大部分生成式设计实验。
方案B:进阶型——中型产品优化与实时渲染
适用场景:50万网格级别的产品拓扑优化、B-Rep几何重建、多方案并行渲染评估、设计竞赛项目全流程。
推荐机型:UltraLAB A350 15696-MCE
- CPU:Intel Core Ultra 9 285K,24核(8P全核5.5GHz/16E全核3.8GHz),产品手册标注为全核超频实测优化频率,Intel官方标称单核最高5.7GHz
- GPU:NVIDIA RTX Pro 5000 48GB,显存带宽1.3TB/s
- 内存:96GB DDR5
- 存储:4TB NVMe SSD(产品目录标称14GB/s读取带宽)
- 显存带宽:1.3TB/s
24核处理器和96GB内存的组合,让这套配置可以处理中等规模的多目标优化。RTX Pro 5000的48GB显存是一个关键升级——在同时加载多个候选方案进行并排渲染对比时,24GB显存容易触顶,48GB则宽裕得多。专业卡的驱动稳定性也优于消费级,长时间运行拓扑优化求解器时更不容易出现显存溢出导致的崩溃。4TB存储可以容纳多个大型项目的版本历史,不需要频繁清理文件。适合已经接触过生成式设计、需要处理完整产品形态优化的研究生或初级工程师。
方案C:专家级——大型装配体与多物理场耦合
适用场景:百万级网格的拓扑优化、整机装配体生成式设计、多物理场耦合优化(结构+热+流体)、BrepGen类AI模型本地推理与微调。
推荐机型:UltraLAB AX430 127384-MC2E
- CPU:Intel Xeon金牌6530,32核2.7-4.0GHz,Intel官方基础频率2.1GHz/最大4.0GHz
- GPU:双NVIDIA RTX 6000D 84GB,单卡显存带宽1.6TB/s,双卡合计3.2TB/s
- 内存:384GB DDR5
- 存储:4TB NVMe SSD(产品目录标称14GB/s读取带宽)
- 显存带宽:双卡1.6TB/s×2
Xeon金牌6530的32核在并行有限元求解中提供了良好的扩展性,384GB内存是这套配置的杀手锏。百万级网格的刚度矩阵加上多目标遗传算法的种群存储,内存占用轻易突破128GB。384GB不仅够用,还留出了余量给其他后台程序。双RTX 6000D 84GB的专业卡组合,显存总量达到168GB,可以加载整机装配体进行实时渲染,也可以把多组候选方案同时送进GPU做并行评估。对于需要在本地运行BrepGen或类似AI几何生成模型的团队,这套配置提供了足够的CUDA算力和显存空间。适合工业设计企业里的资深工程师、研发主管,以及高校课题组里承担复杂装备项目的博士生。
方案D:集群级——企业级生成式设计平台
适用场景:超大规模装配体优化(数百万网格)、多物理场全耦合生成式设计、云端协同设计平台、AI生成模型分布式训练与推理、多项目并发。
推荐机型:UltraLAB GX660M 227512-MD4E
- CPU:双Intel Xeon金牌6530,64核(2.7-4.0GHz),Intel官方基础频率2.1GHz/最大4.0GHz
- GPU:四NVIDIA RTX 6000D 84GB,单卡显存带宽1.6TB/s,四卡合计6.4TB/s
- 内存:512GB DDR5
- 存储:8TB NVMe SSD(产品目录标称14GB/s读取带宽)
- 显存带宽:四卡1.6TB/s×4
64核处理器和512GB内存,把单机求解能力推到了工作站范畴的天花板。四张RTX 6000D 84GB的显存总量达到336GB,可以同时加载多个超大型装配体,或者在四块GPU上并行跑不同参数的拓扑优化任务。对于需要批量生成候选方案的企业级设计平台,这种多卡并行架构能把原本需要通宵的优化任务压缩到几小时完成。8TB存储足以容纳一个设计团队数月的项目文件和版本历史。如果需要处理更大的AI模型训练任务,可以升级到GX660M 227640-MD4E(四张RTX Pro 6000 96GB,640GB内存)或GX660M 227768-MD6E(六张RTX 6000D 84GB,768GB内存)。适合大型工业设计企业、汽车或航空航天领域的产品开发部门,以及高校里承担国家级重大装备项目的研究团队。
产品形态的生成式设计是一个复杂的工程流程。它把力学约束、制造工艺和美学判断同时编码进算法搜索空间,让计算机在参数空间里自动搜索最优形态。西安交大工业设计系从1998年起步,二十五年后站在WDO成员和国家级一流专业的位置上,正在把AI生成式设计引入课堂。这个转变需要的不仅是新的课程大纲,更是新的算力基础设施。当设计师从”画形状”变成”定义约束”,工作站的配置逻辑也随之改变:CPU主频决定交互响应,内存容量决定优化规模,GPU显存决定渲染边界,存储速度决定迭代效率。这四个维度里任何一个出现短板,生成式设计的流水线就会卡住。
算法已经能够识别在材料与力学的边界上自动搜索最优形态。问题变成:你的工作站,能不能跟上算法的搜索速度?
微信号:maxftxwx












