
2025年全国大学生数字媒体科技作品及创意竞赛的获奖名单里,哈尔滨工业大学的学生拿了两个国赛一等奖。其中一个作品叫《基于VR辅助的熔岩管智能勘探系统设计》,把月球科考和虚拟现实绑在了一起。另一个叫《薪火八十年——传承不息的精神密码》,用AIGC做了动画。这两个作品看起来方向完全不同,但底层吃的同一套硬件:实时渲染、大场景承载、沉浸式交互。这恰好是哈工大数字媒体技术专业的看家方向。
软科2024年专业排名,哈工大数字媒体技术全国A+。在有的榜单里排第一,有的排第二,反正都在最前面。不同评价体系排名差异较大,软科评为A+前三,但部分榜单排名不同。这个专业依托的是计算机科学与技术国家一级重点学科,实验室配置直接拉满:智能机器数控影像创意实验室、全方位虚拟动态建构实验室、智能交互视觉创意实验室、大空间VR多人交互实验室。四个实验室里,大空间VR实验室配了动作捕捉和头戴VR显示器,沉浸式影像实验室配了三折式LED屏幕和CAVE投影。这些设备不是摆着看的,学生用它们在全国大学生广告艺术大赛、中国大学生计算机设计大赛里拿了一百多项国家级奖。
但实验室设备和学生工作站是两回事。学生练手可以借实验室设备,真要独立做一个项目、跑一个引擎、训一个模型,还是得有自己的工作站。而实时图形渲染、计算机视觉、虚拟现实仿真这三个方向,对硬件的要求完全不一样,又诡异地指向同一个瓶颈:GPU。
一、实时渲染引擎:亿级面片不是吓唬人的
2023年工信部发过一份”揭榜挂帅”任务书,目标很具体:2025年前做出支持亿级三角形、8K分辨率、60帧每秒的实时三维引擎。这个指标不是随便写的。虚幻引擎5的Nanite虚拟几何系统已经能处理数十亿个原始多边形,但它不是真的把十亿个面片同时塞进显存。Nanite的核心思路是:只渲染屏幕上看得见的部分,把看不见的自动剔除。
听起来很省资源?实际上更吃配置了。因为剔除本身需要计算。Nanite把场景拆成簇(Cluster),每个簇根据屏幕占比动态调整精度。离摄像机远的地方用低精度模型,近的地方用高精度。这个动态切换过程需要GPU在每一帧做大量的可见性计算和纹理流送。如果显存不够,纹理流送就会卡顿,画面直接出现马赛克或者闪烁。
虚幻引擎5的另一个杀手是Lumen全局光照。传统的实时渲染用烘焙光照贴图,预先把光影效果烤死在贴图里,运行时直接采样。Lumen不一样,它用光线追踪实时计算间接光照。每一帧都要发射探测射线、计算反弹、更新光照缓存。这意味着RT核心(光线追踪核心)必须够强,显存带宽必须够高,否则帧率直接崩塌。
一个中等规模的场景,用Nanite + Lumen + 虚拟阴影贴图,显存占用轻松突破16GB。如果场景里还有大量4K纹理、动态天气系统、水体反射,24GB显存也只是勉强够用。8K分辨率下的渲染目标缓冲区本身就要占用大量显存。8K × 8K × 4字节(RGBA32)= 256MB,一个帧缓冲区的开销。如果加上深度缓冲、法线缓冲、中间计算缓冲,光是G-Buffer就要吃掉好几个GB。
这就是为什么工信部那个”亿级三角形8K60FPS”的目标这么难。它考验的不是单一指标,而是GPU的显存容量、显存带宽、RT核心性能、几何处理单元吞吐量的同时输出。任何一项掉队,帧率就上不去。
二、计算机视觉与图像合成:显存的另一条消耗路径
数字媒体技术专业里,计算机视觉和图像合成通常跑在另一条线上。OpenCV做传统图像处理,PyTorch或TensorFlow跑深度学习模型。实时图像合成(比如把虚拟角色实时合成到真实背景里)需要同时做分割、跟踪、光照估计、颜色校正。每一步都可能是一个独立的神经网络。
Stable Diffusion这类扩散模型生成一张512×512的图像,推理过程需要在显存里维护一个噪声潜在空间和UNet的中间激活。单张图生成需要约8GB显存。如果要生成2048×2048的高分辨率图像,或者做批量生成,显存需求直接翻倍。ControlNet加上去,再翻一倍。如果还想实时预览(比如每调一个参数就立即生成预览图),GPU必须持续满载运行。
图像合成里的Matting(抠像)算法也是显存杀手。高分辨率视频帧的Matting需要在像素级别做前景/背景分类,计算每个像素的Alpha值。分辨率越高,显存占用呈平方增长。4K视频的Matting,单帧处理就可能需要10GB以上显存。如果做视频序列(比如连续30帧),还要在时间维度上做一致性约束,显存里得同时缓存多个帧的特征图。
计算机视觉的”实时”要求比静态渲染更苛刻。渲染引擎掉一帧,观众可能只是觉得轻微卡顿。视觉跟踪算法掉一帧,虚拟物体的位置就会跳一下,直接穿帮。所以视觉pipeline通常要求稳定的帧率,而不是平均帧率。这意味着GPU不能有任何波动性的负载峰值。
三、虚拟现实仿真:90帧只是及格线,不是高分线
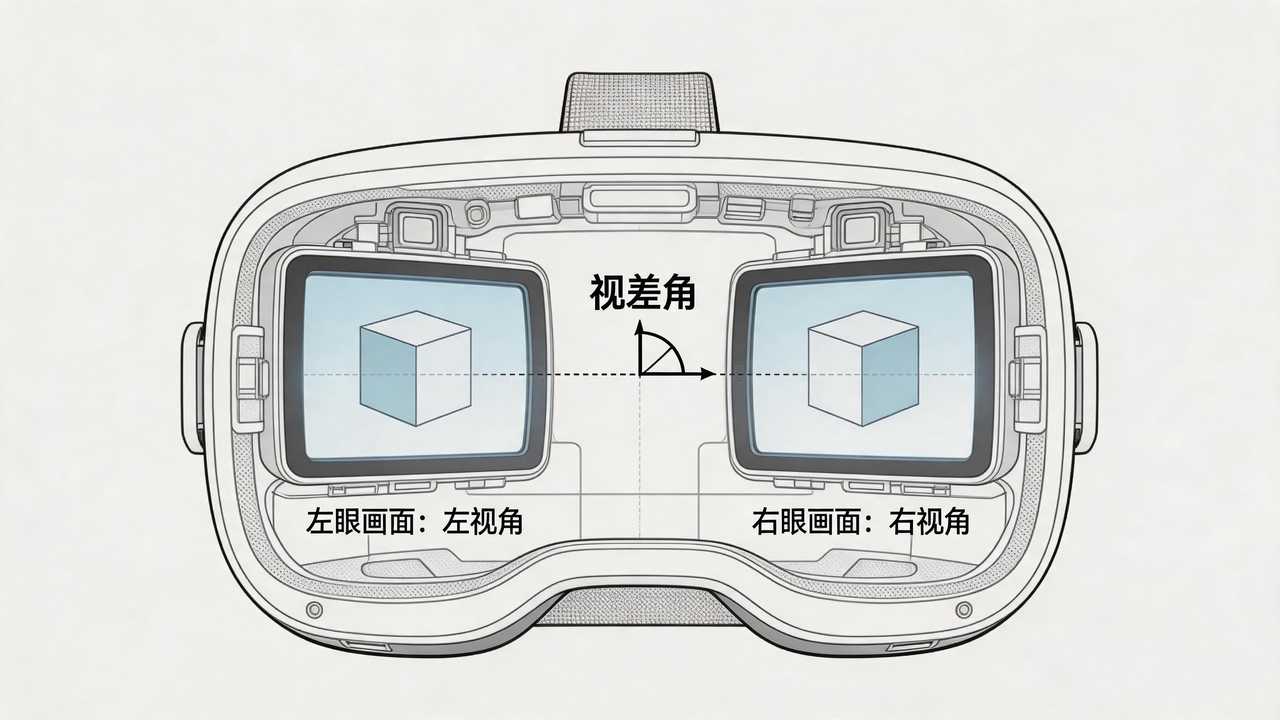
VR的渲染逻辑和显示器完全不同。普通显示器60帧就能用,电竞显示器144帧是顶配。VR不一样,人眼戴着头盔,头部转动时画面必须同步更新,否则大脑会感知到延迟,轻则眩晕,重则呕吐。业界把90帧作为VR的最低及格线,120帧是舒适线,200帧是理想线。
但这只是单眼的数字。VR需要为左右眼分别渲染两幅画面,而且两幅画面有视差(双眼看到的场景略有不同)。所以实际渲染负载是普通单屏渲染的2倍以上。如果再算上镜头畸变校正、时间扭曲(Timewarp,用最后一帧的图像做头部追踪补偿)、空间扭曲(Spacewarp,用运动向量插帧),GPU的实际负载可能达到单屏的3倍。
一个VR场景如果在显示器上能跑120帧,放进VR头盔里可能只剩下40帧。这还不够及格。所以VR项目的开发工作站,GPU性能必须大幅冗余。开发者通常需要一个比目标设备强得多的GPU,才能在开发阶段跑流畅。
哈工大那个大空间VR多人交互实验室,支持多人同时在CAVE环境里走动。多用户意味着多视角,每个用户看到的场景都是独立渲染的。服务器端需要为每个用户维护一个渲染上下文,显存和算力的消耗随用户数线性增长。三个用户同时在线,渲染负载就是三倍。
四、硬件瓶颈到底卡在哪里
把这三条技术线放在一起看,硬件瓶颈的画像就很清晰了。
GPU显存容量是第一道门槛。 16GB显存在2024年还是主流配置,但面对虚幻引擎5的Nanite + Lumen + 4K纹理组合,16GB已经捉襟见肘。24GB是中等项目的起步线,32GB到48GB才能算宽裕。如果做AI图像合成或高分辨率Matting,48GB到96GB是常态需求。
显存带宽是第二道门槛。 显存容量够大,但读写速度不够,GPU还是会在纹理流送和光线追踪缓冲时卡住。显存带宽决定了GPU能以多快的速度把数据搬进搬出。现代高端GPU的显存带宽在1TB/s到2TB/s之间,但带宽和显存容量是配套的。低端卡容量小、带宽也低,高端卡容量大、带宽也高。这是一个打包升级的过程,没法单独补短板。
CPU的单核性能是第三道瓶颈。 很多人以为渲染就是GPU的事,CPU无所谓。错了。实时渲染引擎的CPU负责场景图管理、物理模拟、动画更新、剔除计算、 draw call 批处理。这些工作单线程性能敏感,多核优化有限。一个复杂的场景可能有数万个 draw call,CPU需要每帧把它们分拣、排序、合并,然后提交给GPU。CPU单核弱了,GPU会空等,帧率一样上不去。
内存容量是第四道瓶颈。 64GB系统内存可以应付大多数游戏引擎开发。但如果同时开着虚幻引擎编辑器、Blender、Photoshop、Substance Painter、一个IDE、几个浏览器标签,内存占用会轻松突破64GB。工程场景里,一个未压缩的8K纹理就是256MB,一百张纹理就是25GB。系统内存不够,操作系统开始交换,整个工作站变得卡顿,跟渲染无关的操作也受影响。
存储速度是第五道瓶颈。 纹理流送、模型加载、场景序列化,每一步都在读硬盘。NVMe SSD的顺序读取速度在14GB/s级别(产品目录标称),SATA SSD只有0.5GB/s。打开一个大场景,SATA SSD可能加载两分钟,NVMe SSD十几秒。开发阶段频繁保存、加载、迭代,硬盘速度直接决定工作效率。
五、为什么学生工作站和实验室设备不是一回事
哈工大的数字媒体技术实验室配了动作捕捉、CAVE投影、三折LED屏。这些设备是专业级的,造价高、维护贵,不可能给每个学生配一套。学生平时在实验室做最终展示和调试,但日常的模型制作、材质绘制、代码编写、引擎调试,都需要在自己的工作站上完成。
实验室设备通常是展示终端,不是开发终端。开发工作站需要在本地跑完整的DCC(数字内容创作)工具链:3ds Max或Blender做建模,ZBrush做雕刻,Substance Painter或Marmoset做材质,Unreal Engine或Unity做引擎开发,Photoshop或After Effects做后期。这些软件同时开,资源消耗巨大。展示终端只需要跑一个播放器,开发终端需要跑整个生产线。
另外,实验室设备通常不能安装学生自己的软件或插件。引擎开发需要频繁的版本切换、插件调试、代码编译,这些操作在共享实验室设备上既不安全也不方便。学生必须有自己的工作站,才能自由地折腾。
六、配置推荐:从学习到工程的四个台阶
以下推荐基于UltraLAB产品目录速查表2026和UltraLAB基准报价表2026v1,按应用场景从入门到专家分四档。所有硬件参数严格对应速查表中的具体型号,不做虚构。
方案A:入门级(学习场景/轻量VR原型开发)
适用场景:大一到大三课程作业、虚幻引擎/Unity入门学习、小型VR原型、OpenCV基础实验、1080p视频编辑。
推荐机型:A350 15064-MBX
- CPU:Intel Core Ultra 7 265K,20核(8P 5.3GHz + 12E 3.8GHz)。8个性能核跑引擎主线程和物理模拟,12个能效核跑后台编译和浏览器,20核在入门级里算充裕。Intel官方标称单核最高睿频5.5GHz,产品手册标注5.3GHz为全核实测优化频率。
- GPU:NVIDIA RTX 5060Ti 16GB。16GB显存可以运行Nanite + Lumen的中等场景,1080p下跑60帧。RTX 5060Ti支持光线追踪和DLSS,做VR原型也够用。显存带宽对标产品目录速查表中的中端定位。
- 内存:64GB DDR5。64GB可以同时开虚幻引擎编辑器、Blender、Substance Painter和Photoshop,多软件并行不紧张。
- 存储:4TB NVMe SSD(产品目录标称14GB/s读取带宽)。4TB可以装操作系统、引擎、多个项目工程。做4K视频编辑时,素材库空间也更宽裕。
- 推荐理由:这款是UltraLAB A350系列的入门款,CPU和GPU平衡,适合学生从0到1学习数字媒体技术全栈。16GB显存是2026年跑虚幻引擎5的最低入门线,低于这个数,Nanite和Lumen只能二选一。
方案B:进阶款(引擎开发/中型场景/1080p VR)
适用场景:毕业设计级项目、虚幻引擎5完整功能开发、中型开放世界场景、1080p VR体验、Stable Diffusion批量生成、4K视频合成。
推荐机型:A350 153128-MCT
- CPU:Intel Core Ultra 7 265K,20核(8P 5.3GHz + 12E 3.8GHz)。8个性能核全核超频到5.3GHz,跑引擎主线程和物理模拟绰绰有余。20核总线程数可以支撑后台编译和Lightmass烘焙并行。Intel官方标称单核最高睿频5.5GHz,产品手册标注5.3GHz为全核实测优化频率。
- GPU:NVIDIA RTX 5090 v2 24GB(水冷)。24GB显存可以跑Nanite + Lumen + 虚拟阴影贴图的完整组合,4K纹理无压力。RTX 5090的RT Core和Tensor Core比50系列更强,Lumen的光线追踪和DLSS 4的帧生成都能吃满。显存带宽1.3TB/s(产品目录标称),纹理流送不卡顿。水冷散热保证长时间满载不降频。
- 内存:128GB DDR5。128GB可以同时开虚幻引擎编辑器、Blender、Substance Painter、Photoshop、VS Code、Chrome,每个软件都能分到足够的内存。Lightmass烘焙和AI推理的中间缓存也能在内存里充足存放。
- 存储:4TB NVMe SSD(14GB/s读取带宽)。4TB可以装多个引擎版本、多个项目、素材库。NVMe的高速读取保证大型场景的加载不等待。
- 推荐理由:这款是A350系列的中高配,CPU单核和GPU显存都上了台阶。24GB显存是2026年虚幻引擎5开发者的舒适配置线,低于这个数,开发阶段总要关特效、降纹理。128GB内存则是多软件并行的刚需。
方案C:专家级(大型场景/2K VR/AI生成管线)
适用场景:商业化级实时渲染项目、大型开放世界场景、2K分辨率VR体验、Stable Diffusion XL/Flux高分辨率生成、4K视频Matting、多软件并行工作流。
推荐机型:AR350 148192-MCT
- CPU:AMD锐龙9950X3D,16核(4.8~5.7GHz)+ 水冷。3D V-Cache技术把L3缓存堆到128MB,对游戏引擎和实时渲染的帧率提升显著。16核全核超频实测4.8~5.7GHz,单核性能强劲。AMD官方标称单核最高加速频率5.7GHz,产品手册标注的区间对应全核实测优化频率。
- GPU:NVIDIA RTX 4090 48GB(水冷)。48GB显存可以承载超大型Nanite场景,8K纹理贴图无压力。RTX 4090的CUDA核心数和张量核心规模是消费级天花板,做AI图像生成、视频Matting、实时合成都能跑满。水冷散热保证持续高负载。产品目录标注48GB,对应水冷版超频配置,标准版RTX 4090为24GB。
- 内存:192GB DDR5。192GB可以支持超大型场景的Lightmass烘焙、AI模型的全精度推理、多轨道4K视频的实时预览。内存冗余意味着不需要频繁关闭软件来释放资源。
- 存储:4TB NVMe SSD(14GB/s读取带宽)。4TB对单个项目可能不够,但可以通过外接存储扩展。NVMe的高速读取保证大型资产包的导入导出不等待。
- 推荐理由:9950X3D的超大缓存对实时渲染的帧率提升是实打实的。48GB显存是2026年数字媒体技术专业研究生的毕业设计无压力配置,什么场景都能直接加载,不需要手动拆分。
方案D:集群级(多用户VR/电影级渲染/AI训练推理)
适用场景:多用户VR系统服务器、虚幻引擎多GPU分布式渲染、电影级实时虚拟制片、Stable Diffusion/Flux大规模批量生成、视频Matting流水线、数字孪生实时可视化。
推荐机型:GX660M 227256-MC4T
- CPU:2×Intel Xeon金牌6530,64核(2.7~4.0GHz)。双路共64核,多线程编译、多实例引擎运行、服务器级负载都能扛。产品手册标注2.7~4.0GHz为全核实测优化频率,Intel官方标称基础频率2.1GHz/最大睿频4.0GHz。
- GPU:4×NVIDIA RTX 5090D 32GB(水冷)。四卡并联,总显存128GB。RTX 5090D 32GB每张卡带宽1.8TB/s(产品目录标称),四卡总带宽超过7TB/s。多卡可以通过虚幻引擎的nDisplay做分布式渲染,也可以把四块卡分配给四个独立的渲染实例,支持多用户VR。水冷散热对四卡系统是必须的,否则机箱内热堆积会导致降频。
- 内存:256GB DDR5。256GB在多GPU环境下可以缓存多个场景的纹理、模型、光照数据。AI推理时,大模型和批量数据的中间结果也能在内存里缓冲。
- 存储:4TB NVMe + 20TB SATA。NVMe装操作系统和活跃项目,SATA做素材库和归档存储。20TB可以容纳数年的项目资产和素材积累。
- 推荐理由:四卡系统是虚拟制片和多用户VR的标配。虚幻引擎的nDisplay支持把渲染负载拆到多块GPU,每块卡负责一个视角或一个屏幕区域。哈工大那个大空间VR实验室,底层服务器可能就是类似的配置。这款GX660M是塔式工作站,不是机架服务器,适合放在工作室或实验室角落,不需要机房环境。
七、选型时容易忽略的几个细节
显存和内存不是一回事,也不能互相替代。 有人以为系统内存够大,就可以弥补显存不足。不行。GPU只能直接访问自己的显存,系统内存里的数据需要经过PCIe总线搬运,延迟高、带宽低。显存满了就是满了,不会因为内存有剩就多给你一点。
CPU散热器必须认真选。 虚幻引擎编辑器编译着色器、烘焙光照、启动项目时,CPU会长时间满载。原装散热器在满载下可能触发温度墙,导致降频。A350和AR350系列配水冷,就是为了压住超频后的持续高负载。风冷不是不能用,但长时间编译后的稳定性不如水冷。
NVMe SSD的容量规划要留余量。 一个虚幻引擎5项目,工程文件、缓存、烘焙光照、构建输出加起来可能轻松超过100GB。加上引擎本身(50GB+)、多个DCC软件、操作系统,2TB系统盘留给项目空间其实不多。4TB是更合理的起点,有条件的上8TB。
多GPU系统不是插满就行。 四卡系统的电源、散热、机箱风道都是专门设计的。普通主板插四块卡,供电可能不稳,机箱内部热量堆积。GX660M的塔式结构配独立风道,每块卡都有独立的进气空间。自己组装四卡系统,散热和电源往往成为隐性瓶颈。
显示器不是工作站的核心,但别太差。 数字媒体开发需要准确的颜色还原。方案A和B建议配一台至少覆盖sRGB 100%的显示器,方案C和D建议覆盖DCI-P3 90%以上。HDR内容的开发需要HDR显示器,否则调色时无法预览真实效果。UltraLAB的配置里没有包含显示器,但开发者在预算里需要单独留一块。
哈工大数字媒体技术专业的学生,从《四时·五行》的CAVE空间体感交互,到《基于VR辅助的熔岩管智能勘探》的虚拟现实模拟,再到AIGC动画生成,底层都是同一套技术栈:实时渲染、大场景管理、沉浸式交互。实验室的设备给了他们展示的舞台,但日常的开发、迭代、试错,需要一台足够强的工作站。配置够用且有余量即可。因为数字媒体技术这个领域,软件和场景的复杂度永远在升级,今天够用的配置,明年可能就成了瓶颈。预留20%到30%的性能冗余,是这个行业的老规矩。
来源:
- 哈尔滨工业大学数字媒体技术省级实验教学示范中心(2023年)
- 软科2024年中国大学专业排名(数字媒体技术)
- 工业和信息化部2023年未来产业创新任务揭榜挂帅通知(实时三维引擎)
- 2025年全国大学生数字媒体科技作品及创意竞赛获奖公示
- UltraLAB产品目录速查表2026 / UltraLAB基准报价表速查2026v1
微信号:maxftxwx












