
2010年前后,哈工大材料学院某团队在UG平台上开发了一套复杂曲面件模具设计的计算机辅助系统。系统用UG/Open API和Visual C++搭建,核心任务是解决一个让工程师头疼了几十年的问题:怎么让计算机又快又准地处理NURBS(非均匀有理B样条)曲面。成果发表在《航天制造技术》,论文里一句话很有分量——借助该系统,复杂曲面零件及模具设计工作变得直观、方便、快捷。同年,哈工大威海校区完成了另一项更底层的突破:一套NURBS曲面快速拟合与简化软件,相比传统方法提速一个数量级,拟合误差控制在0.003以内,控制点数量却能大幅减少。
两个项目看起来一个是应用、一个是算法,但指向的是同一件事:复杂曲面建模的本质,是数学和工程的拉锯战。曲面越光滑,控制点越多;控制点越多,计算量越重;计算量越重,工作站就越容易在关键时刻掉链子。十五年过去,工业设计专业的建模对象从单个模具零件变成了整车外饰、整机外形,面片数量从几万飙到千万级,渲染从离线出图变成了实时光追预览。这场拉锯战从未停止,只是战场换到了每台工作站的CPU、GPU和内存总线上。
一、复杂曲面建模:数学的优雅,工程的沉重
工业设计的核心语言是曲面。汽车A柱的倒角、吹风机手柄的握持弧度、医疗器械外壳的无缝接缝——这些都不是简单拉伸或旋转能生成的几何体。NURBS曲面之所以成为工业设计的标准,是因为它用数学上的”连续性”(Continuity)精确描述了现实世界的光滑过渡:G0是位置连续,G1是切线连续,G2是曲率连续,G3是曲率变化率连续。一辆豪华轿车车身表面要求G2甚至G3连续,这意味着每一寸曲面都经过严密的数学约束。
但数学的优雅落到计算机里,就变成了沉重的计算负担。NURBS曲面用一个二维参数域(u, v)和一组控制点、权重、节点向量来定义三维空间中的曲面。当你拖动一个控制点,整个曲面都会重新计算。Rhino里的Grasshopper做参数化设计时,一个遗传算法优化可能同时调整上千个控制点的位置,每次迭代都要重新生成曲面、评估曲率、检测干涉。这哪里是”建模”,分明是在解一个带几何约束的高维优化问题。
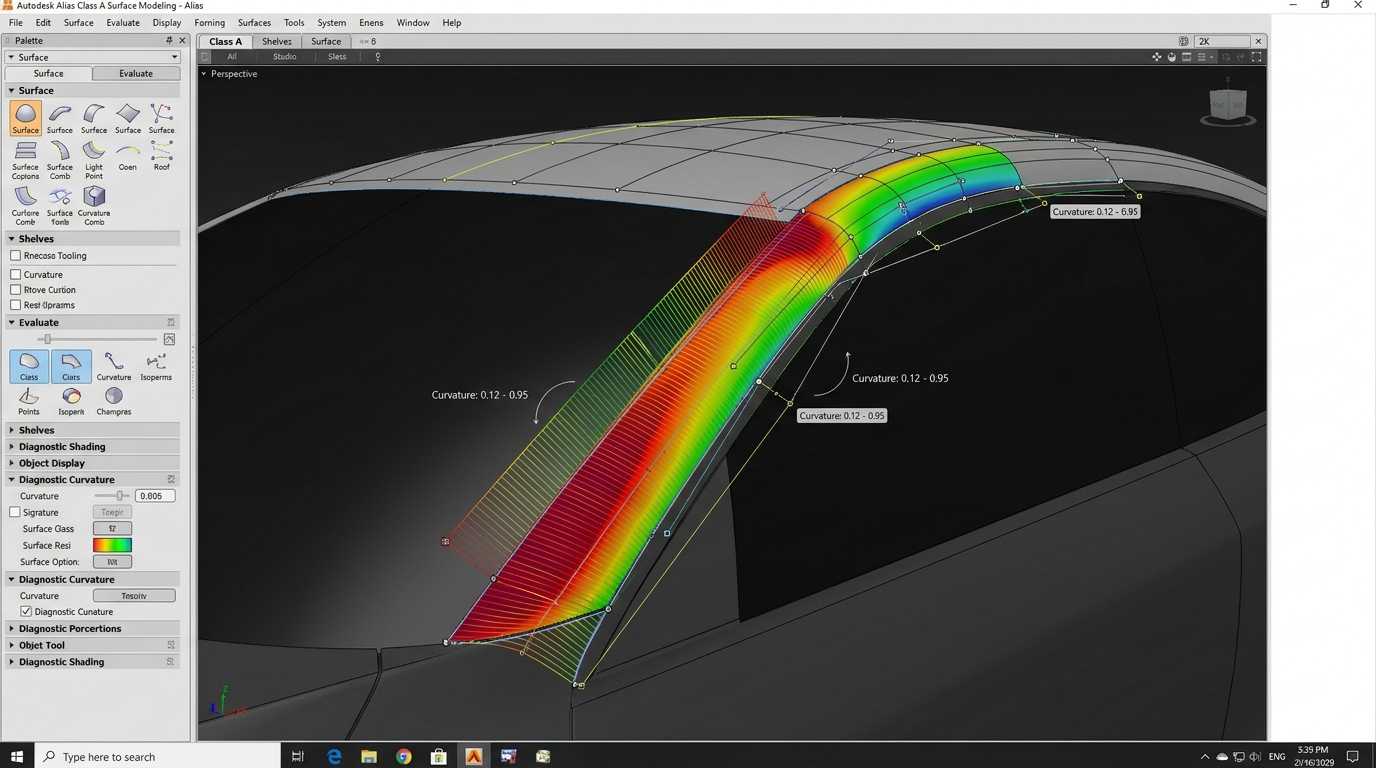
Alias和CATIA这类航空汽车级建模软件走得更远。汽车外饰建模动辄千万级面片,Alias的Class A曲面要求反射纹均匀、高光锐利、曲率梳平滑。建模师调整一条特征线,软件要在后台实时解算整条曲面的高斯曲率和平均曲率分布。这种计算对单线程性能极度敏感——NURBS求值算法里有大量递归和矩阵运算,核心频率每提升100MHz,建模操作的响应延迟都能被肉眼察觉。
SolidWorks和Creo的参数化建模则是另一种压力模式。特征树(Feature Tree)里的每一个拉伸、倒角、抽壳、阵列都是一棵依赖关系树。修改一个底层草图尺寸,软件要遍历整棵树重新生成所有后续特征。复杂装配体有成千上万个配合关系,每次重建都要解一个大规模约束方程组。内存不够大,重建到一半就会弹出”内存不足”;CPU核心数不够,多实体操作就只能串行排队。
二、工业级渲染:从离线出图到实时光追
模型建完只是前半场。工业设计需要把数字模型变成客户能看懂的视觉语言——产品效果图、CMF(颜色/材料/工艺)展示、虚拟现实评审。这条流水线里,渲染是吃硬件的大户。
KeyShot是工业设计领域最常用的渲染器之一,它的核心是光线追踪(Ray Tracing)和全局光照(Global Illumination)。KeyShot从6.0版本开始支持GPU加速,利用NVIDIA OptiX框架把光线追踪放到显卡上跑。一个4K分辨率的产品场景,开启焦散(Caustics)和半透明材质(Subsurface Scattering)后,每帧可能需要数百万条光线迭代。GPU显存直接决定了能载入多少纹理贴图和几何体:8GB显存放一套4K PBR材质(颜色、法线、粗糙度、金属度、AO五张贴图)就占掉几百MB,一个带环境HDR的产品场景再加几何缓存,16GB显存很容易触顶。
V-Ray和Blender Cycles走的是另一条路——基于路径追踪(Path Tracing)的无偏渲染。它们对GPU的利用更激进,支持多卡并联。但多卡渲染有个隐性门槛:显存不能叠加。两张24GB显卡并联,每张卡都要载入完整场景,实际可用显存还是24GB。这意味着复杂场景的显存瓶颈不会因为加卡而消失,除非用渲染农场拆分镜头。Blender的OptiX后端和HIP后端在NVIDIA和AMD显卡上都有不错的表现,但显存带宽直接决定了每帧迭代速度——带宽越高,光线在BVH(包围体层次结构)加速结构中遍历得越快,像素收敛得越快。
实时光追是近年来的新战场。虚幻引擎5的Lumen全局光照和Nanite虚拟几何,让工业设计评审可以直接在引擎里走查。Nanite把千万级面片的几何体流式送进GPU,靠细节层次(LOD)和簇剔除(Cluster Culling)保持帧率。但Nanite的代价是显存和带宽:每个Nanite网格都要在GPU上维护一个软光栅化的微多边形缓冲区,显存占用比传统静态网格更高。工业设计团队用虚幻做VR评审时,两只眼睛各渲染一张图,再加上90Hz刷新率的硬约束,GPU负载直接翻倍。
三、人机交互仿真:从静态评审到动态体验
人机交互仿真评估是工业设计的另一个技术深水区。设计一把椅子,不仅要看它好不好看,还要看人坐上去脊柱受力是否均匀;设计一个手术器械手柄,要模拟不同握姿下手指关节的扭矩分布。这类仿真需要把CAD模型导入多体动力学软件(如Adams、Simpack)或有限元分析软件(如ANSYS Mechanical、Abaqus),建立刚体-柔体耦合模型,计算接触力、摩擦力、肌肉负荷。
CATIA的人机工程模块(Ergonomics)和Jack人机仿真软件,把数字人模型(Digital Human)放进虚拟场景,模拟伸手够取、弯腰搬抬、视线扫视等动作。每个关节有自由度约束,每次姿势调整都要解逆运动学(Inverse Kinematics)方程。动作流畅度依赖CPU的单线程响应;复杂场景里多个数字人同时运动,多核并行才能保持实时性。
更进一步的,触觉反馈(Haptic Feedback)和力反馈(Force Feedback)设备需要仿真循环在1kHz以上刷新,这对实时计算提出了近乎硬实时的要求。工作站的CPU不仅要算得快,还要算得稳——时间抖动过大会让力反馈设备出现震颤感,直接影响评估结果的可信度。
四、硬件瓶颈拆解
把上述软件负载拆开看,工业设计工作站的硬件需求可以归纳为四条主线。
4.1 单核频率:NURBS求值的命根
NURBS曲面求值、参数化特征重建、草图约束求解,这些算法的历史包袱决定了它们很难完美并行。Alias的Class A曲面评估、CATIA的GSD(Generative Shape Design)模块、SolidWorks的特征树重建,都是重依赖单核性能的环节。Intel Core Ultra 9 285K的P核全核超频实测优化频率达到5.5GHz,在这种场景下比多核低频处理器更有优势。AMD锐龙9950X3D的3D V-Cache对Rhino的NURBS求值也有帮助——缓存大了,控制点数据留在L3里不需要频繁访问内存,求值延迟显著降低。
4.2 GPU显存与带宽:渲染的硬天花板
显存容量决定了场景规模的上限,显存带宽决定了渲染迭代的速度。RTX 5090的32GB显存和1.8TB/s带宽,在KeyShot和Blender里处理复杂产品场景时游刃有余;RTX 4090的48GB显存(产品目录标注)对超大纹理集和千万面片场景更宽松。专业卡RTX Pro 5000的48GB显存和RTX 6000D的84GB显存,在Alias、CATIA这类ISV认证软件里还有驱动稳定性优势——游戏卡的驱动更新频繁,偶尔会和专业建模软件的OpenGL管线冲突。
4.3 内存容量:装配体和多软件的战场
工业设计的工作流通常是多软件并行:Rhino建完曲面进Alias修Class A,修完进KeyShot渲染,同时开着Photoshop修图、Illustrator画爆炸图、Excel做BOM表。16GB内存在这种场景下根本不够看,Windows系统本身就要占掉4-6GB,Rhino一个大模型轻松吃10GB,KeyShot的CPU渲染模式再吃掉8-12GB,多开几个软件就开始疯狂换页。64GB是底线,128GB才能宽松应对复杂装配体和多任务并行。ECC内存对长时间渲染作业有保护价值——非ECC内存在大规模数据读写中可能出现单比特翻转,导致渲染结果出现噪点或色彩断层。
4.4 存储:打开模型的等待时间
NVMe SSD的顺序读取带宽直接影响大型装配体的打开速度。一个SolidWorks装配体可能由几百个零件文件组成,打开时要逐个读取和解析。产品目录标称14GB/s读取带宽的NVMe SSD,能把大型装配体的打开时间从分钟级压缩到秒级。更重要的是,参数化建模软件频繁的自动保存和重建操作会产生大量临时文件,SSD的随机读写性能直接决定了操作流畅度。
五、图形工作站配置推荐
铺垫了这么多,核心问题还是:到底该配什么机器?下面的推荐按应用场景分档,所有机型和硬件参数均严格对照UltraLAB产品目录速查表和基准报价表速查2026v1。若两表不一致,以基准报价表为准。
方案A:入门级——学生课题与轻量产品建模
适用场景:工业设计本科课程作业、Rhino参数化建模、KeyShot基础渲染、小型装配体(零件数<200)、人机交互仿真入门。
推荐机型:A350 15064-MBX
- CPU:Intel Core Ultra 7 265K,20核(8P 5.1GHz / 12E 3.8GHz)。单核频率足够应对NURBS基础求值,多核并行处理小型装配体重建。
- GPU:RTX 5060Ti 16GB。16GB显存放得下中等复杂度的KeyShot场景和4K PBR材质集,NVIDIA OptiX加速光线追踪入门够用。
- 内存:64GB DDR5。满足Rhino + KeyShot + Photoshop多开的基本需求,留有一定余量。
- 存储:4TB NVMe SSD(产品目录标称14GB/s读取带宽)。容纳课程项目、软件安装和素材库,读写速度消除文件加载瓶颈。
方案B:进阶级——复杂曲面建模与中等规模渲染
适用场景:Alias Class A曲面设计、整车外饰局部建模、V-Ray中等规模离线渲染、虚幻引擎5实时评审、200-1000零件的中型装配体。
推荐机型:A350 153128-MCT
- CPU:Intel Core Ultra 7 265K,20核(8P全核5.3GHz / 12E全核3.8GHz)。产品手册标注为全核超频实测优化频率,Intel官方ARK标称P核基础频率3.7GHz、TVB最高5.5GHz。20核对SolidWorks大型装配体重建和Grasshopper遗传算法迭代有明显加速。
- GPU:RTX 5090 v2 24GB。24GB显存足够容纳整车局部外饰的高分辨率纹理和千万级面片预览,水冷散热保证长时间渲染不降频。
- 内存:128GB DDR5。Alias + KeyShot + Photoshop + 浏览器多标签 + 通讯软件同时运行不卡顿,大型装配体打开后内存仍有缓冲。
- 存储:4TB NVMe SSD(产品目录标称14GB/s读取带宽)。大型装配体和渲染输出文件占用空间巨大,4TB容量提供充足余量。
方案C:专家级——整车外饰全流程与工业级实时评审
适用场景:整车外饰千万面片全流程建模、Blender Cycles/V-Ray大规模路径追踪、虚幻引擎5 Nanite + Lumen VR评审、多软件并行工作流、触觉反馈实时仿真。
推荐机型:AR350 148192-MCT
- CPU:AMD锐龙9950X3D,16核(4.8~5.7GHz,产品手册标注为全核超频实测优化频率;AMD官方标称基准频率4.3GHz/最高加速5.7GHz)+ 水冷。3D V-Cache对Rhino和Alias的NURBS频繁缓存访问有显著收益,水冷压制让全核高负载下的频率更稳定。
- GPU:RTX 4090 48GB + 水冷。48GB显存(产品目录标注)对超大纹理集、千万面片Nanite场景和多4K显示器输出极为宽松,水冷解决长时间渲染的散热焦虑。
- 内存:192GB DDR5。整车外饰装配体 + 多体动力学仿真 + 实时渲染并行运行时,内存容量是避免换页崩溃的关键。
- 存储:4TB NVMe SSD(产品目录标称14GB/s读取带宽)。复杂项目的版本管理和素材库累积速度远超预期,高速大容量存储不可或缺。
方案D:旗舰级——大型设计团队与渲染农场节点
适用场景:设计工作室多人协作、Blender/V-Ray多卡并行渲染、虚幻引擎5大规模VR评审、参数化优化算法批量运算、数字孪生实时可视化。
推荐机型:AE450 145128-MC2T
- CPU:AMD锐龙Threadripper 7970X,32核4.5GHz。32核对大规模遗传算法、拓扑优化和批量渲染任务调度有天然优势,该平台支持ECC内存,长时间计算的稳定性更有保障。
- GPU:双RTX 4090 48GB + 水冷。双卡在Blender和V-Ray的多GPU渲染模式下接近线性加速,48GB单卡显存各自独立载入完整场景。水冷散热对双卡紧挨着的散热堆叠至关重要。
- 内存:128GB DDR5 ECC。ECC内存在连续数小时的渲染农场作业中防止单比特错误导致画面瑕疵,该平台支持让这一特性可用。
- 存储:4TB NVMe SSD(产品目录标称14GB/s读取带宽)。双卡渲染的输出量巨大,高速存储缩短帧序列写入延迟。
方案E:算力中心级——整车厂级数字样机与集群渲染
适用场景:整车厂完整数字样机(Digital Mock-up)、千万级零件大型装配体、分布式渲染农场、多物理场耦合仿真、工业设计AI辅助生成(Stable Diffusion/ControlNet产品概念设计)。
推荐机型:GX660M 227256-MC4T
- CPU:双Xeon金牌6530,64核(2.7~4GHz)。64核对大装配体的多线程重建、批量设计变量计算和分布式任务调度是刚需。
- GPU:4×RTX 5090D 32GB + 水冷。四卡并行在Blender和V-Ray中实现接近4倍迭代加速,32GB单卡显存对大多数工业设计场景足够;四卡散热必须由水冷统一解决,风冷在这么密集的负载下会触发降频保护。
- 内存:256GB DDR5。大型装配体载入内存后仍有余量运行背景任务,多用户远程共享时内存资源更宽裕。
- 存储:4TB NVMe + 20TB SATA。NVMe承载活跃项目和系统,SATA阵列存放历史版本和渲染帧序列归档。
六、关键选型建议
复杂曲面建模和工业渲染的硬件选型,有几个容易踩坑的地方值得单独拎出来讲。
第一,显存容量比核心数更重要。工业设计不是游戏,帧率不是目标,场景能载入、纹理不溢出才是底线。KeyShot的GPU模式在显存不足时会默默回退到CPU渲染,速度掉一个数量级,用户往往要到任务管理器里查GPU显存占用才能发现。建议显存容量按”目标场景峰值 × 1.5″来规划。
第二,专业卡和游戏卡的取舍要看软件认证列表。Alias、CATIA、SolidWorks对NVIDIA RTX Pro系列和AMD Radeon Pro系列有官方认证驱动,OpenGL显示列表的兼容性和稳定性经过验证。RTX 4090/5090的原始性能更高,但偶尔会在专业软件的线框显示或阴影渲染里出现小毛病。如果工作流以建模为主、渲染为辅,优先选专业卡;如果渲染占大头且用Blender/KeyShot这类对游戏卡友好的软件,RTX 4090/5090的性价比更优。
第三,内存频率对NURBS求值的影响被很多人忽视。DDR5-5600和DDR5-4800在实际建模中的差距,不像游戏帧率那么明显,但当Grasshopper的参数化逻辑树节点数超过一千时,内存带宽直接决定了每次参数更新后曲面重算的速度。建议至少选DDR5-5600,有预算可上更高频率。
第四,水冷不是炫技,是工业设计工作站的务实选择。KeyShot一次4K动画渲染可能持续数小时,Blender的Cycles路径追踪跑一夜也不稀奇。风冷在长时间满载下的噪音和温度曲线会让工作环境变得很煎熬,水冷的低温低噪对设计师的专注度是隐性投资。
回到开头那篇2010年的论文。哈工大材料学院某团队在UG平台上做的复杂曲面模具辅助系统,当时跑在什么样的工作站上已不可考。但可以确定的是,今天的千万面片整车外饰、实时光追评审、人机交互力反馈仿真,对硬件的索取早已不在同一个数量级。工作站的配置逻辑没变:先看软件负载特征,再找瓶颈环节,最后匹配硬件。变的只是数字后面跟着的零越来越多——从万级面片到千万级,从MB级纹理到GB级,从单核撑全场到多卡并行渲染。工业设计的技术史,本质上是一部算力需求持续指数膨胀的历史。而一台配对了的工作站,就是设计师手边最可靠的翻译器——把数学的优雅翻译成工程的现实。
微信号:maxftxwx












