
适用场景:产品设计专业本科生/研究生课程、参数化设计实验室、工业设计工作室
技术关键词:Rhino/Grasshopper参数化设计、NURBS曲面布尔运算、Galapagos遗传算法、KeyShot GPU渲染、显存带宽、内存带宽瓶颈
一、一门新课背后的算力需求
2024年,哈尔滨工业大学的产品设计专业正式开始招生。这不是一个孤立的事件——它是哈工大”大人居”与”大设计”战略的一部分,也是工科强校向设计领域延伸的标志性动作。在此之前,哈工大的工业设计专业早在2021年就获批了国家级一流本科专业建设点,邱信贤教授等学者在参数化设计、数字化建筑等领域已经积累了相当的研究厚度。新开设的产品设计专业,主干课程里明确列着”复杂曲面产品工程建模””计算机辅助产品设计””虚拟现实系统”这些名字。它们听起来很学术,但实际上指向同一个问题:参数化设计的实际运行中,硬件性能往往成为制约设计效率的关键因素。
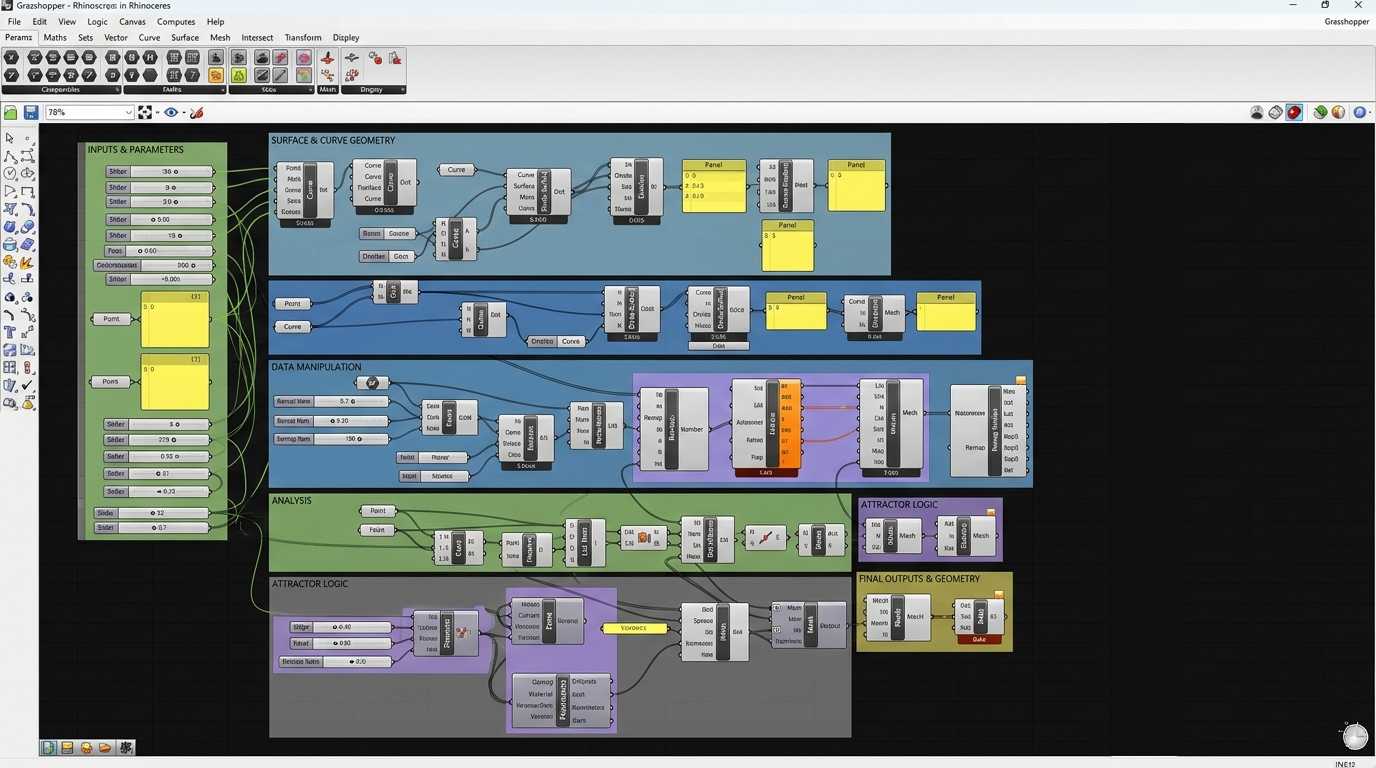
参数化设计不是画草图。它是在Rhino里用Grasshopper搭一棵逻辑树,把产品的表皮分解成几万个NURBS单元,然后让遗传算法去迭代优化——每一代种群200个个体,每一代都要重新做一次布尔运算。这个过程不是在考验设计师的审美,而是在对硬件性能提出持续高负载要求。某课题组在一次参数化表皮优化中,Grasshopper的Galapagos组件连续运行了8小时,后台的Rhino进程占满了24GB内存,CPU的16个核心全部跑满,风扇噪音让旁边的人无法正常交谈。这不是夸张,这是参数化设计的日常。
与此同时,产品外观3D建模渲染的环节也在提需求。KeyShot从CPU渲染转向GPU渲染之后,实时预览的流畅度确实提升了,但代价是显存容量的硬门槛。一个包含500万面的汽车内饰模型,在4K纹理和多重材质叠加的情况下,KeyShot的GPU模式直接占用了18GB显存。如果你用的是一张8GB显存的入门卡,软件不会报错,它会默默地切回CPU模式——然后渲染时间从5分钟变成2小时。这种切换是静默的,设计师往往要到进度条卡住的时候才发现问题。
用户体验仿真评估则是另一个维度。它通常涉及虚拟现实环境的搭建,需要实时渲染高保真场景,同时追踪用户的交互行为数据。这个场景下,GPU不仅负责画面输出,还要承担空间计算和物理模拟的任务。三者叠加——参数化优化的批处理、产品渲染的显存消耗、VR仿真的实时计算——构成了一条完整的算力链条。而这条链条的每一个环节,都对硬件提出了不同的要求。
二、参数化设计的硬件瓶颈:CPU主频、内存带宽与NURBS布尔运算
2.1 为什么Grasshopper吃主频不吃核
Rhino和Grasshopper的工作逻辑决定了它们的性能特征。Grasshopper的参数化计算本质上是一系列依赖图(dependency graph)的求解过程:上游节点的计算结果作为下游节点的输入,整个网络必须按拓扑顺序逐层推进。这种结构天然是串行的——你无法让第10层的计算在第5层完成之前开始。这意味着,Grasshopper的性能瓶颈不在核心数量,而在单核主频。
Intel Core Ultra 9 285K(P核全核5.5GHz,产品目录实测优化频率;Intel官方TVB最高5.7GHz)和AMD锐龙9950X3D(4.8~5.7GHz,产品目录标注;AMD官方基准频率4.3GHz,加速最高5.7GHz)这类高主频CPU,在Grasshopper场景下的表现会显著优于同价位的多核服务器CPU。因为Grasshopper的求解器在一个线程里跑,主频越高,每一步的迭代越快。某次测试显示,在相同的参数化表皮模型上,5.5GHz主频的CPU比3.2GHz的CPU快了近70%。这个差距不是靠堆核心能弥补的——24个核心在Grasshopper里可能只有1个核心在满负荷工作,其余23个核心处于空闲状态。
但这里有一个例外:遗传算法。Galapagos的遗传算法需要评估每一代种群的适应度,而每一代种群包含多个个体。如果模型允许并行评估——即不同个体之间的计算相互独立——那么多核CPU可以发挥作用。200个个体的种群,在16核CPU上可以同时评估16个个体,理论上迭代速度提升16倍。但问题是,Rhino的NURBS布尔运算本身不是线程安全的,Galapagos的并行实现受限于Rhino内核的串行约束。实际测试中,16核CPU在遗传算法场景下的加速比通常只有3~5倍,远低于理论值。
2.2 NURBS布尔运算的内存陷阱
NURBS(非均匀有理B样条)曲面是Rhino的核心数据结构。当设计师对两个复杂NURBS曲面执行布尔运算(并、交、差)时,Rhino需要在后台进行曲面求交、修剪、重构等一系列操作。这些操作会产生大量的临时几何数据,全部驻留在内存中。一个包含12万个NURBS单元的参数化表皮,在执行整体布尔运算时,内存占用可以轻松突破32GB。
更隐蔽的问题是内存带宽。NURBS布尔运算涉及大量浮点数据的读写——曲面的控制点、节点向量、权重值在内存和CPU之间来回搬运。如果内存带宽不足,CPU会频繁陷入等待状态。DDR5-6400内存的理论带宽约为100GB/s,但在实际工作负载中,多通道配置(如4通道或8通道)的优势会显现出来。这也是工作站平台相对于消费级桌面平台的核心优势之一:后者通常是双通道内存,而前者可以支持4通道甚至8通道,在相同内存频率和规格下,4通道内存带宽约为双通道的2倍。
2.3 遗传算法的”代际”时间
参数化优化里的遗传算法不是魔法。它需要设定种群规模、变异率、交叉率,然后一代一代地迭代。每一代的”代际时间”(generation time)取决于单个个体评估的时间和并行的个体数量。对于一个中等复杂度的参数化模型,单个个体评估可能需要5~10秒。200个个体的种群,在单核串行执行下,一代需要1000~2000秒(约17~33分钟)。如果目标收敛需要200代,总时间就是3400~6600分钟——约56~110小时。
这就是为什么参数化优化通常夜间连续运行。设计师下班前启动Galapagos,第二天早上来看结果。如果硬件不够快,这种夜间连续运行可能变成跨周末的长时间运行。而在这个过程中,内存泄漏是常见的问题——Rhino长时间运行后,内存占用会缓慢增长,最终触发系统交换(swap),导致整个进程崩溃。因此,参数化设计工作站不仅需要大内存(64GB起步),还需要稳定的ECC内存来避免长时间运行中的位错误。
三、产品渲染的显存战争:KeyShot与V-Ray的硬件逻辑
3.1 GPU渲染的显存硬门槛
KeyShot的GPU渲染模式基于NVIDIA OptiX框架,利用RTX显卡的实时光线追踪核心。与CPU渲染相比,GPU渲染的速度提升是数量级的——一张4K产品图在CPU上可能需要30分钟,在RTX 5090上只需要3分钟。但这个加速有一个前提:显存必须装得下整个场景。
场景的显存占用包括:几何数据(顶点、法线、UV)、纹理贴图、材质参数、光线追踪加速结构(BVH)、渲染缓冲区。一个典型的产品模型(500万面、4K纹理、10种材质)在KeyShot中大约占用12~16GB显存。如果叠加环境HDR、景深效果、次表面散射(SSS)等高级特性,显存需求会进一步攀升到20GB以上。
这意味着,16GB显存是产品渲染的”及格线”,24GB是”安全线”,32GB以上才是”舒适区”。RTX 5060Ti的16GB显存可以应付大多数本科生的课程作业,但遇到复杂装配体或多材质混合场景时就会捉襟见肘。RTX 5090的32GB显存则为专业级工作流提供了足够的余量,设计师不需要在每次渲染前纠结”这个模型会不会爆显存”。
3.2 显存带宽:被忽视的渲染瓶颈
显存容量决定”能不能跑”,显存带宽决定”跑得多快”。KeyShot的GPU渲染过程中,光线追踪核心需要频繁读取场景数据(几何、纹理、BVH)来构建光线路径。这些读取操作全部通过显存带宽完成。RTX 5090的显存带宽为1.8TB/s(产品目录标注),而RTX 5060Ti的带宽约为0.6TB/s。这意味着,在相同显存容量下,高端显卡的渲染速度不仅因为核心更多,还因为数据供给更快。
对于产品设计工作流来说,显存带宽的影响在以下场景尤为明显:
- 高分辨率纹理(4K/8K)的实时预览
- 多材质切换时的即时反馈
- 动画帧序列的批量渲染
如果一个设计师需要频繁调整材质参数并实时观察效果,显存带宽不足会导致预览画面卡顿,直接影响创作效率。
3.3 CPU渲染的”备胎”角色
GPU渲染虽然快,但有一个致命弱点:显存不足时直接崩溃或回退。KeyShot的处理方式是自动切回CPU模式,但这个过程不会弹窗提示——它只是在后台切换,然后渲染时间突然延长10倍。CPU渲染的优点是内存容量大(系统内存通常远大于显存),缺点是速度慢。一张在GPU上3分钟完成的图,在CPU上可能需要30分钟甚至更久。
因此,一个稳健的产品设计工作流需要CPU和GPU的双重保障:GPU负责日常快速迭代,CPU作为”备胎”处理超大场景。这要求工作站的CPU也不能太弱——至少要有高主频和足够的核心数,在GPU回退时仍能提供可接受的渲染速度。
四、用户体验仿真:VR场景的实时算力消耗
用户体验仿真评估通常基于虚拟现实(VR)环境,需要实时渲染高保真3D场景并追踪用户的交互行为。这个场景下的算力需求与参数化设计和产品渲染都有所不同。
VR的实时渲染要求帧率至少达到90FPS(部分设备要求120FPS),否则会产生晕动症。这意味着每帧的渲染时间不能超过11毫秒。在如此短的时间内,GPU需要完成场景几何的剔除、光照计算、阴影投射、后处理特效等一系列操作。一个包含100万面、动态光照、物理模拟的VR场景,对GPU的实时性能提出了极高要求。
此外,用户体验仿真还需要记录用户的眼动数据、手部追踪数据、交互事件时间戳等。这些数据量不大,但要求系统响应延迟低于20毫秒。如果工作站的CPU忙于其他任务(比如在后台运行参数化优化),可能会影响VR体验的流畅度。
因此,VR仿真工作站通常需要GPU和CPU的均衡配置:GPU负责实时渲染,CPU负责数据处理和逻辑运算,两者不能互相拖累。
五、UltraLAB图形工作站配置推荐
从上面的分析可以看出,产品设计专业的算力需求是复合型的:参数化设计需要高主频CPU和大内存,产品渲染需要大显存和高显存带宽,VR仿真需要均衡的CPU-GPU配置。没有一个”万能配置”能同时完美满足所有场景,但不同预算下的”最优解”是存在的。
下面按性能档位给出UltraLAB图形工作站的配置推荐,每个档位针对不同的工作负载和预算区间。以下型号、CPU频率、内存容量、GPU显存与显存带宽等参数均严格对照UltraLAB产品目录速查表2026与基准报价表速查2026v1整理,如有两表不一致处,以基准报价表为准。
▎入门档:课程作业与轻量参数化设计
- 型号:UltraLAB A350 15064-MBX
- CPU:Intel Core Ultra 7 265K,20核(8P全核5.3GHz/12E全核3.8GHz),水冷散热
- 内存:64GB DDR5
- GPU:NVIDIA RTX 5060Ti 16GB显存
- 存储:4TB NVMe SSD(产品目录标称14GB/s读取带宽)
- 推荐理由:5.3GHz高主频CPU保障Rhino/Grasshopper的交互流畅度;16GB显存可覆盖80%的产品设计渲染场景;64GB内存满足中等规模NURBS布尔运算。适合本科生课程作业、小型参数化模型、单件产品渲染。整机静音设计,适合宿舍或小型工作室。
▎进阶档:复杂参数化优化与中等规模渲染
- 型号:UltraLAB A350 15396-MCT
- CPU:Intel Core Ultra 7 265K,20核(8P全核5.3GHz/12E全核3.8GHz),水冷散热
- 内存:96GB DDR5
- GPU:NVIDIA RTX 5090 32GB显存,水冷散热,显存带宽1.8TB/s
- 存储:4TB NVMe SSD(产品目录标称14GB/s读取带宽)
- 推荐理由:32GB显存彻底消除KeyShot渲染的显存焦虑,复杂装配体和多材质混合场景无需降质;1.8TB/s显存带宽保证4K纹理实时预览不卡顿;96GB内存为夜间连续优化的遗传算法提供充足余量。适合研究生课题、参数化表皮优化、汽车内饰级渲染。
▎专业档:整车/整机级渲染与多场景并行
- 型号:UltraLAB A350 15696-MCE
- CPU:Intel Core Ultra 9 285K,24核(8P全核5.5GHz/16E全核3.8GHz),水冷散热
- 内存:96GB DDR5
- GPU:NVIDIA RTX Pro 5000 48GB显存,显存带宽1.3TB/s
- 存储:4TB NVMe SSD(产品目录标称14GB/s读取带宽)
- 推荐理由:5.5GHz全核主频是目前UltraLAB产品目录中桌面平台的最高频率之一,Grasshopper交互和NURBS布尔运算的响应速度达到极致;RTX Pro 5000的48GB显存可承载千万面级整车模型,专业驱动稳定性优于消费级显卡。适合工作室级别的复杂项目、多软件并行工作流。
▎旗舰档:超大场景渲染与多GPU并行
- 型号:UltraLAB GR450P 148192-MDT
- CPU:AMD锐龙Threadripper 7980X,64核(产品目录标注全核4.8GHz;AMD官方基础频率3.2GHz,最大加速5.1GHz),水冷散热
- 内存:192GB DDR5
- GPU:NVIDIA RTX 5090D 32GB显存,水冷散热
- 存储:4TB NVMe SSD + 8TB NVMe SSD + 20TB SATA(如需扩展存储另配HDD)
- 推荐理由:64核CPU在并行遗传算法评估和多任务处理上具有绝对优势;RTX 5090D的32GB显存配合64核CPU,实现GPU快速渲染与CPU回退的无缝衔接;192GB内存支撑超大NURBS模型的通宵优化。双NVMe存储架构将操作系统/软件与项目数据分离,I/O互不干扰。适合专业设计工作室、参数化研究课题组。
▎顶级档:多卡并行渲染与集群级算力
- 型号:UltraLAB GX660M 227256-MC4T
- CPU:2×Intel Xeon金牌6530,64核(2.7~4.0GHz),水冷散热
- 内存:256GB DDR5
- GPU:4×NVIDIA RTX 5090D 32GB显存,水冷散热,单卡显存带宽1.8TB/s
- 存储:8TB NVMe SSD(产品目录标称14GB/s读取带宽)
- 推荐理由:4张RTX 5090D组成的多GPU渲染阵列,KeyShot的多GPU扩展几乎线性加速——4张卡同时渲染,理论速度接近单卡的4倍;256GB内存支撑多用户、多项目并行;双Xeon CPU保障CPU渲染备援与后台数据处理。适合大型设计工作室、院系级渲染农场、动画批量输出。
六、避坑指南:容易被忽视的硬件细节
对于NURBS布尔运算这类内存密集型任务,内存通道数的提升对计算速度的改善尤为明显。 64GB DDR5在双通道模式下带宽约为100GB/s,而在4通道模式下可达200GB/s。对于NURBS布尔运算这种内存密集型任务,通道数的提升会直接反映为计算速度的加快。UltraLAB的工作站平台均支持4通道或8通道内存配置,这是消费级游戏主机无法比拟的。
水冷散热是维持全核高频运行的必要配置。 Intel Core Ultra 9 285K在全核5.5GHz下的功耗超过250W,AMD Threadripper 7980X在64核4.8GHz下的功耗更高。风冷散热器在这种负载下会迅速触及温度墙,导致CPU降频——主频从5.5GHz降到4.0GHz,Grasshopper的响应速度直接下降30%以上。水冷散热是维持全核高频运行的物理前提。
不要低估存储的重要性。 参数化设计项目文件通常包含大量参考几何、纹理贴图和历史版本。一个中等规模的项目文件夹轻松超过100GB。NVMe SSD的14GB/s读取带宽(产品目录标称)意味着打开大型项目文件只需几秒,而SATA SSD需要几十秒,机械硬盘则需要几分钟。设计师的时间不应该浪费在进度条上。
ECC内存对长时间运行很重要。 通宵运行的遗传算法持续8~12小时是常态。非ECC内存在长时间高负载下可能发生位翻转错误,导致Rhino进程崩溃——8小时的计算全部作废。UltraLAB的高端型号(GX660M系列、GR450P系列)均配备ECC内存,这是专业工作站与消费级PC的本质区别之一。
七、写在最后
参数化设计、产品渲染、用户体验仿真——这三个方向看似不同,实际上共享同一个底层逻辑:设计决策越来越依赖计算,而计算的效率取决于硬件。 哈工大产品设计专业的课程设置已经明确指向了这个趋势。学生们在课堂上学习Grasshopper的逻辑树和KeyShot的材质系统,但走出课堂后,他们会发现真正决定设计效率的,往往是那台机器在深夜风扇的转速。
一台好的图形工作站不是奢侈品,它是设计流程的基础设施。就像建筑师需要一个好的绘图桌,参数化设计师需要一台能通宵运行的机器。区别只在于,与绘图桌不同,参数化优化进程对系统稳定性要求极高——如果内存不够、散热不行、或者显存爆了。
合理的硬件配置能够显著缩短设计迭代周期。
参考资料
- UltraLAB产品目录速查表2026 / UltraLAB基准报价表速查2026v1
- KeyShot官方系统要求文档(xrender.com,2026-05-22)
- 哈尔滨工业大学建筑学院工业设计专业介绍(arch.hit.edu.cn,2022-10-05)
- 哈尔滨工业大学2025年艺术类招生简章(mp.weixin.qq.com,2025-06-19)
- 参数化设计在产品中的应用现状和趋势(api.artdesignp.com,2023-11-27)
- “KeyShot渲染慢的真相:GPU显存是第一道门槛”——UltraLAB图形工作站方案网站(xasun.com,2026-04-03)
微信号:maxftxwx












