
2025年10月,第十三届全国大学生数字媒体科技作品及创意竞赛全国现场总决赛在哈尔滨工业大学举办。50万余名师生、1187所高校、17万件作品涌入这场数字创意的集中检阅。颁奖典礼上,哈工大建筑与设计学院相关负责人从成都接过承办旗帜时说的那句话,”接过的不止是一面旗帜,更是责任和荣誉”,在数字媒体教育圈子里传了很久。但少有人注意的是,这17万件参赛作品背后,有多少是在机房凌晨三点因为内存耗尽而被迫中止渲染的。
哈尔滨工业大学数字媒体艺术专业依托建筑学院设计学系,课程覆盖美术与设计理论、互动媒体与游戏设计、网络与传播、影视与动漫四个系列。国家级课程4门、省级课程3门,从”静物摆放虚拟仿真系统”到”数字影像特技”等虚拟仿真实验项目,课程体系横跨虚拟现实、文化遗产数字化、影视特效合成。学生既要会用Nuke做节点合成,也要能在虚幻引擎里写蓝图,还得懂Houdini的VEX编程。这种交叉培养模式输出的人才确实能打,2024年哈工大学生团队在全国数媒竞赛中拿下多个赛道全国一等奖,但培养过程对硬件的压榨,也远超传统设计专业的承受范围。
影视特效合成计算,是这条培养链上最吃配置的环节之一。很多学生直到毕业设计阶段才第一次意识到:自己的笔记本跑不动一段带Deep数据的4K合成。
一、Nuke节点图:看不见的数据膨胀
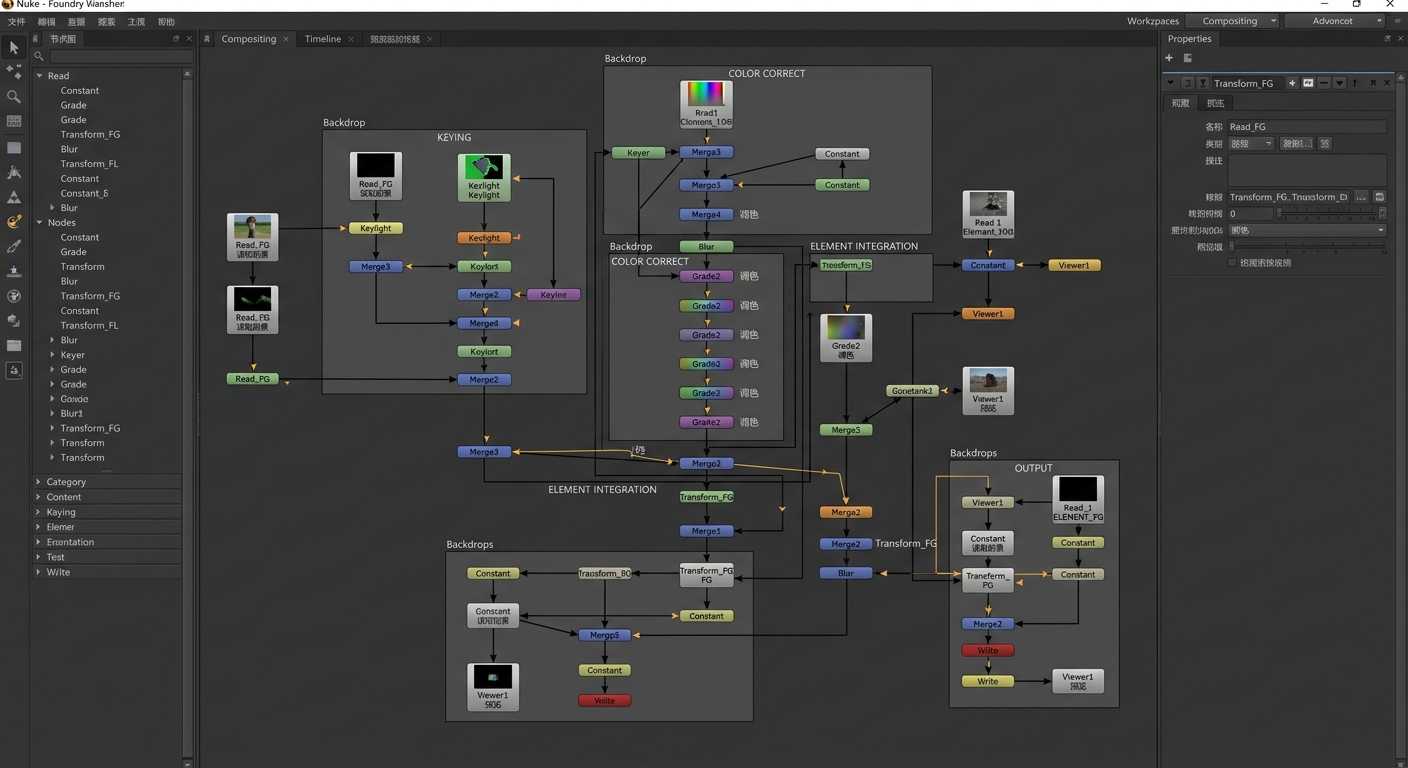
Nuke的节点式工作流看起来很优雅。Read节点接Grade再接Blur,最后用Merge叠到背景上,屏幕上是一张清晰的流程图。但优雅只是表象。每一个节点都在内存中保留一份完整的图像缓存,而影视级的合成项目往往不是”一张图”那么简单。
4K DCI分辨率(4096×2160)下,一帧32位浮点EXR图像的原始数据量是4096×2160×4通道×4字节,约135MB。这还只是一层。真正的合成镜头通常包含:背景层、角色层、特效层(烟、火、碎片)、景深通道(Z-depth)、运动向量通道(Vector)、法线通道(Normal)、遮罩通道(Matte)。加起来一帧可能超过10层,内存占用轻松突破1GB。一个300帧的镜头,如果节点图里有30个节点,内存峰值可能突破10GB,这还没算Nuke的Undo缓存和临时缓冲区。
Deep Compositing(深度合成)是更大的陷阱。传统合成靠Z-depth做景深排序,但半透明的烟雾、头发丝、玻璃折射会让简单的深度排序失效。Deep数据存储的是每个像素在深度方向上的完整样本列表,内存占用通常是普通EXR的5到10倍。一个带Deep数据的4K烟效元素,单帧可能达到2GB。学生在机房打开这样的文件,Nuke的内存监视器会直接从绿色跳到红色,然后界面卡住,最后弹出”Out of Memory”。
2025年数媒竞赛的”影视与动漫设计”赛道里,不乏用Houdini做流体模拟再进Nuke合成的作品。评审专家看到的最终画面或许只有几十秒,但创作者在后台经历的,可能是显存爆掉、内存吃满、硬盘写入速度跟不上的三重夹击。
二、Houdini到Nuke:特效管线中的带宽死结
Houdini的Pyro和Flip流体模拟生成的是体积数据(VDB)或粒子数据(BGEO)。这些数据在进入Nuke之前,通常要经过Mantra或Karma渲染成图像序列。渲染一步本身就需要大量内存,千万级粒子的Flip模拟,单帧VDB文件可能超过500MB,渲染时Mantra要把整个体积网格加载进内存做光线步进。内存不够,渲染器会直接退出。
更隐蔽的问题是存储带宽。特效合成的工作流是”读取-处理-写出”的循环。4K EXR序列以每秒24帧计算,一天的工作可能产生几百GB的临时文件。如果硬盘是机械盘,顺序读取速度只有150MB/s,打开一个100帧的序列就要等几十秒。这种等待不是仅仅是不便而已,它会打断创作节奏,让学生倾向于减少迭代次数,而迭代次数正是数字媒体创作的核心。
哈尔滨工业大学数字媒体艺术专业的课程体系中,”数字影像特技”和”虚拟现实系统”两门课都涉及这种跨软件管线。学生在数字影像内容创作方向需要完成从拍摄、跟踪、抠像到合成的完整流程。跟踪后的摄像机数据(PFTrack或3DEqualizer输出)导入Nuke做投影合成时,3D场景的几何体和纹理也要加载进内存。一台普通笔记本的16GB内存,在这种工作流里连一个中等复杂度的镜头都撑不住。
三、实时渲染引擎:另一条更吃显存的路
与离线合成相对的,是实时渲染引擎方向的课程。虚幻引擎5的Nanite虚拟几何和Lumen动态全局光照,让数字媒体艺术的学生可以在视口里直接看到接近成片的画面。但”实时”不等于”免费”。
Nanite把高模自动转换成微多边形集群,显存占用随场景复杂度线性增长。一个学生搭建的虚拟展厅,如果导入了几百件高精度扫描资产,Nanite的显存池可能突破8GB。Lumen的光照计算依赖显存中的距离场和辐射度缓存,打开光追反射后,显存需求再上一个台阶。学生在课程作业里常见的报错不是”蓝图编译失败”,而是”GPU内存不足,Nanite已降级”,意思是显存不够,引擎被迫回退到传统LOD模式,画面质量打折扣。
交互媒体编程设计课题对硬件的要求又不一样。TouchDesigner或Max/MSP构建的音画交互系统,通常需要稳定的帧率输出(60fps或更高)。这意味着GPU不仅要渲染画面,还要在每一帧执行自定义的GLSL或HLSL着色器。如果工作站GPU太弱,帧率波动会让交互体验出现明显的延迟感。在2024年数字化艺术实验教学研讨会上,相关教师展示的”智能机器数控影像”和”大空间VR多人交互”实验,背后都是高刷新率、低延迟的硬件在支撑。
四、硬件需求拆解:影视特效合成计算到底吃什么
影视特效合成和实时渲染,对硬件的需求侧重点不同,但有几个共通的核心指标。
内存:这是特效合成的头号瓶颈。Nuke官方推荐32GB起步,4K Deep合成建议64GB以上。Houdini的Pyro模拟和Karma渲染同样吃内存,粒子数量×属性数量×每个属性的字节数,就是内存占用的硬上限。学生的毕业设计如果涉及Houdini到Nuke的完整管线,128GB内存并不夸张。
显存:GPU显存在实时渲染中直接决定能加载多大的场景。UE5的Nanite需要显存存放微多边形集群和虚拟纹理,Lumen需要显存放距离场和辐射度缓存。影视合成软件(Nuke、Fusion)的GPU加速节点也依赖显存,VectorBlur、Grain、Denoise这些节点在GPU上跑得快,但显存不够就会回退到CPU模式,速度骤降。
存储:特效合成的素材读取是顺序大文件IO,NVMe SSD的14GB/s读取带宽(产品目录标称)比机械盘快两个数量级。几百GB的EXR序列放在NVMe盘上,拖拽进Nuke几乎无延迟;放在机械盘上,进度条会让人怀疑软件是否卡死。
CPU:Nuke的节点图执行是单线程主导的,节点之间是串行依赖,无法并行。所以CPU的单核性能(频率)比核心数更重要。但Houdini的模拟和渲染可以并行,多核有帮助。这里存在一个矛盾:既要高单核频率(Nuke UI响应快),又要多核心(Houdini模拟快)。工作站选型时需要平衡。
显示器:数字媒体创作对色彩准确度有硬性要求。10bit色深、100% Adobe RGB或DCI-P3覆盖、Delta E<2,这些参数直接影响调色和合成时的判断。学生用普通显示器做的调色,到了评审现场的广色域屏幕上可能完全走样。
五、为什么现在要聊配置
数字媒体艺术教育的交叉性决定了硬件需求的多重叠加。一个数媒专业的学生,大二在学Nuke合成,大三在做Houdini流体模拟,大四毕设用虚幻引擎搭实时交互场景。这三套软件对硬件的峰值需求分别落在内存、显存、存储带宽三个不同的维度上。买一台只满足其中一项的机器,另外两项会在关键时刻成为短板。
2025年全国数媒竞赛在哈工大举办的现场,评审专家能看到最终呈现的精彩作品,但看不到后台的硬件挣扎。50万师生提交17万件作品,这个数量级背后,是无数学生在机房排队等渲染、在笔记本前看着进度条发呆的日常。对准备进入这个领域的本科生、研究生,以及承担教学任务的实验室来说,工作站的配置是支撑学习效率和创作上限的基础设施。
以下按应用场景和预算区间给出UltraLAB图形工作站配置推荐。
UltraLAB数字媒体艺术图形工作站配置推荐
入门级:影视合成与基础特效
适用场景:Nuke基础合成(1080p/2K)、After Effects动效制作、Blender基础三维、虚幻引擎小规模场景
推荐机型:A350 15064-MBX
- CPU:Intel Core Ultra 7 265K 20核(8P全核5.3GHz/12E全核3.8GHz)+ 水冷(产品手册标注为全核超频实测优化频率,Intel官方标称单核最高TVB 5.5GHz)
- GPU:RTX 5060Ti 16GB
- 内存:64GB DDR5
- 存储:4TB NVMe SSD(产品目录标称14GB/s读取带宽)
- 显存带宽:产品目录标称单卡显存带宽需以NVIDIA官方datasheet为准
推荐理由:64GB内存可以支撑2K合成的节点图缓存,16GB显存满足基础UE5场景和Nuke GPU加速节点的需求。Intel Ultra 7的单核高频保证Nuke的UI响应流畅。适合数媒专业本科低年级学生的课程作业和入门竞赛项目。
进阶款:4K合成与Houdini特效
适用场景:Nuke 4K Deep合成、Houdini Pyro/Flip模拟、Karma渲染、UE5中型场景实时开发
推荐机型:A350 153128-MCT
- CPU:Intel Core Ultra 7 265K 20核(8P全核5.3GHz)+ 水冷
- GPU:RTX 5090 v2 24GB + 水冷
- 内存:128GB DDR5
- 存储:4TB NVMe SSD(产品目录标称14GB/s读取带宽)
- 显存带宽:1.3TB/s(产品目录标注,以NVIDIA官方datasheet为最终参考)
推荐理由:128GB内存是4K Deep合成的安全线,24GB显存可以加载更复杂的Nanite场景和Nuke Deep数据。RTX 5090的CUDA核心加速Nuke的GPU节点(如VectorBlur、Denoise),水冷散热保证长时间渲染的稳定性。适合承担毕业设计、竞赛作品、小型商业项目的学生和青年教师。
专家级:8K合成与复杂特效管线
适用场景:8K影视合成、Houdini大规模流体模拟、UE5影视级虚拟制片、TouchDesigner实时交互装置
推荐机型:AR350 145128-MCE
- CPU:AMD锐龙9950X 16核 4.5GHz
- GPU:RTX 6000D 84GB
- 内存:128GB DDR5
- 存储:4TB NVMe SSD(产品目录标称14GB/s读取带宽)
- 显存带宽:1.6TB/s(产品目录标注,以NVIDIA官方datasheet为最终参考)
推荐理由:84GB显存是处理8K素材和多通道EXR的硬门槛,RTX 6000D的专业驱动对Nuke、Houdini、UE5的稳定性优化更好。AMD 9950X的16核在高频下兼顾单核响应和多核渲染。适合数媒专业研究生、实验室骨干、以及需要同时跑多条管线的创作团队。
集群级:教学实验室与虚拟制片
适用场景:数媒专业实验室批量渲染、UE5虚拟制片舞台、多机位实时合成、AI辅助内容生成(AIGC管线)
推荐机型:GX660M 227256-MC4T
- CPU:2×Xeon金牌6530 64核(2.7~4GHz)+ 水冷
- GPU:4×RTX 5090D 32GB + 水冷
- 内存:256GB DDR5
- 存储:4TB NVMe + 20TB SATA
- 显存带宽:4×1.8TB/s(产品目录标注,以NVIDIA官方datasheet为最终参考)
推荐理由:四卡并联提供128GB总显存,可以分割给多个学生同时做UE5开发或Nuke合成。双路Xeon的64核心支撑Houdini分布式模拟和Karma网络渲染。256GB内存允许同时加载多个Deep合成项目。20TB SATA用于存放原始素材和渲染序列的冷存储。适合哈工大数媒专业这类需要支撑国家级课程和竞赛培养的实验室环境。
微信号:maxftxwx












