
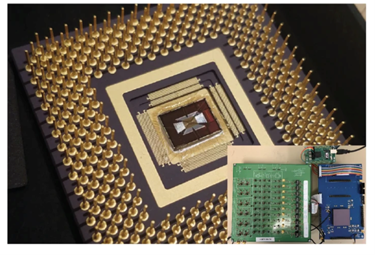
忆阻器存算一体是突破冯·诺依曼瓶颈的候选路线,Crossbar阵列做矩阵乘法一行Python就能跑通小demo。可真实仿真一上手就卡——128×128阵列的欧姆定律-基尔霍夫方程求解爆炸、非理想效应蒙特卡洛内存暴涨、大规模映射验证跑到第三天被OOM杀掉。更头疼的是,器件参数、映射策略、硬件安全模型全是课题组的核心资产,数据涉密不敢传云端API,SPICE网表报错、矩阵条件数过大、迭代不收敛只能自己硬啃求解日志。本地部署大模型帮你写阵列映射代码的前提,是先有一台扛得住大规模忆阻网络求解的机器。
一、现场问题:忆阻器Crossbar仿真背后的四重暗礁
1. 内存陷阱:稠密电导矩阵与瞬态历史的”沉默膨胀”
Crossbar仿真的内存大头不在阵列尺寸本身——128×128才1.6万个器件——而在KCL方程的稠密化。每个节点要满足基尔霍夫电流定律,128×128阵列展开是1.6万节点×1.6万节点的电导矩阵G,双精度稠密存储就是200MB,LU分解的填充元让工作集翻3~5倍;更隐蔽的是瞬态仿真(考虑忆阻动力学和寄生电容),每个时间步都要重新装配G矩阵,ODE刚性导致步长极小,万步仿真×每步一次分解,历史状态驻留内存从32GB爬到100GB然后OOM。我们一个实际项目,某存算课题组的256×256阵列MNIST推理仿真在考虑器件波动蒙特卡洛时被OOM杀掉,日志只留下一行冰冷的Out of memory. Type HELP MEMORY for your options,让人误以为是SPICE模型语法错误。
2. 误判链:卡顿→砍阵列规模→能效结论失真
典型误判链是这样的:256×256阵列仿真一小时才推进1ms→”哦,阵列太大,砍到32×32再试”→仿真秒出,可32×32的能耗和延迟数据根本代表不了大规模阵列的互连优势,论文里的能效比外推被审稿人质疑,要求补全尺寸扫描。真正的原因常常是求解策略侧:电导矩阵没用稀疏存储(Crossbar天然稀疏,相邻节点才耦合)、没有按行块分解复用因子、蒙特卡洛实现全并行无分组、忆阻动力学用细ODE而可用紧凑模型。砍阵列掩盖求解器配置问题,是Crossbar仿真最经典的一条弯路——而稀疏KCL、块分解、紧凑模型、分组蒙特卡洛怎么配,正是最需要经验的地方。
**3. 算力悬崖叠加效应:阵列尺寸×时间步数×蒙特卡洛轮数的三重放大”
Crossbar仿真的计算量由三要素决定:阵列尺寸(KCL矩阵是O(N²)存储、O(N³)分解,256×256比128×128慢8倍)、瞬态步数(忆阻动力学刚性段步长极小,万步×每步分解)、统计验证(器件波动、读噪声、温度漂移各要几十上百次蒙特卡洛实现)。尺寸×2,分解×8;步数×2,时间×2;轮数×10,总耗时×10,三项叠在一起就是非线性的”算力悬崖”——32×32 demo秒级出结果,256×256阵列全效应蒙特卡洛直接卡死。
**4. 单核主频与L3缓存串行基因:LU分解逃不开的串行内核”
Crossbar仿真的核心是每步求解GV=I的稀疏LU分解,KLU/PARDISO的符号分解→数值分解→回代一条链,即使多核并行,分解的调度是串行的。这些环节对主频和缓存极度敏感:主频从2.2GHz提到5.8GHz,256×256阵列单步分解从6秒压到2.3秒;L3从36MB提到384MB,电导矩阵块和电流向量的缓存命中率提升近一倍,装配开销直接砍半。多核的正确用法是多蒙特卡洛实现并行——不同器件波动、不同输入样本、不同温度点互相独立跑并行job,单仿真内部永远逐步分解,这就是”内存带宽求解瓶颈突围”的核心:单步分解快慢看主频和缓存效率,统计吞吐看内存带宽和并行job数,带宽决定你能开多大阵列和多密的蒙特卡洛。
二、算力瓶颈拆解:忆阻Crossbar仿真的四座大山
1. 内存压榨:从”稠密KCL硬塞”到”稀疏存储+块分解+紧凑模型+分组统计”
256×256稠密矩阵+万步全历史,单机根本塞不住。解决方案不是盲目堆内存,而是稀疏存储+块分解+紧凑模型+分组统计:Crossbar相邻耦合天然稀疏,用稀疏格式存G减少90%内存;按行条带分解复用因子;忆阻动力学用Verilog-A紧凑模型替代细ODE;蒙特卡洛分组跑,结果增量聚合。内存峰值砍掉70%以上,256阵列仿真从100GB压到30GB以内。
**2. 步长锁死:动力学刚性段与读出精度的耦合瓶颈”
忆阻权重更新段刚性强步长必须小,推理读出段是稳态可大步长;统一小步长算力浪费95%,统一大步长权重更新失真。把策略分层——推理稳态用代数求解器直接解KCL,训练更新段用事件触发局部加密,统计验证用准稳态近似快速扫,关键工况才全瞬态精算——是打破步长锁死的核心策略。而分段求解器和映射策略代码怎么写进仿真流程,正是本地AI最擅长帮你生成的地方。
**3. 单核主频依赖:矩阵装配与分解的隐形杀手”
每个时间步,CPU要装配电导矩阵(遍历阵列器件状态)、做符号分解(首次)、数值分解、回代求节点电压,全在关键路径上,内存再大,主频低就是空转。主频2.2GHz的CPU上,256×256单步约6秒,1ms瞬态仿真万步要16小时;换到5.8GHz高主频CPU,单步压到2.3秒,总耗时6小时,百次蒙特卡洛从一个月缩到一周。L3缓存同样关键:G矩阵块和电压向量频繁随机访问,L3从36MB提到384MB,KLU分解的缓存命中率翻倍,单步耗时再砍20%。
**4. 内存带宽风暴:矩阵装配与状态刷新的双重压力”
每个时间步要读写全阵列电导状态、装配稀疏三元组、更新节点电压,这几个环节都是纯带宽密集型的。内存带宽从50GB/s提到150GB/s(八通道DDR5),矩阵装配耗时直接砍半;多job并行蒙特卡洛时,每个job独立搬运G矩阵,带宽需求×job数,四通道是底线。这就是为什么Crossbar仿真是带宽密集型负载,堆CPU核数在LU分解时毫无用武之地。
三、实测:某存算课题组256×256阵列推理仿真,本地AI闭环排障
算例统一设定:
- 阵列:256×256 TiN/HfOₓ忆阻Crossbar,映射MLP权重(MNIST 256输入×256隐藏)
- 模型:KCL稳态+忆阻动力学瞬态,考虑器件波动σ=0.1、读噪声、线阻
- 验证:100次蒙特卡洛×100张测试图,目标阵列级准确率损失<2%,能效数据可提取
- 目标:单仿真内存<64GB,单组<8小时,蒙特卡洛可分组并行
- 评估指标:仿真完成率(%)、峰值内存(GB)、单组耗时(h)、阵列级准确率
故意复现经典报错:
默认配置下(稠密KCL存储、全瞬态统一小步长、100次实现全并行、细ODE动力学、无稀疏格式),仿真跑到第200步时系统僵死,求解器抛出:
Out of memory. Type HELP MEMORY for your options
Warning: Matrix is singular to working precision, condition number 4.7e17
Error: Time step size reduced below minimum at t=1.2e-5s同时进程内存涨到98GB被系统杀掉,日志报错刷屏:Progress 2%, ETA 12 days, nnz(G) dense = 65,536 but stored full matrix,存算同学集体弃用。
本地AI(Ollama + Qwen2.5-14B)诊断清单:
把求解日志和mapping.py贴给本地部署的小模型,AI给出四侧排查清单:
- 模型侧:奇异源于线阻和电导比悬殊,建议器件电导归一化,边界节点预处理,奇异值正则化;
- 链路侧:OOM源于稠密存储+细ODE,建议稀疏KCL格式,紧凑模型替代,蒙特卡洛分组4路并行;
- 参数侧:步长崩溃源于刚性段,建议事件触发加密,推理稳态用代数求解,分段步长配置;
- 硬件侧:LU分解是主频+带宽双敏感负载,建议主频5GHz+,内存按自由度×3倍工作集配比,八通道带宽保多job并行。
逐条改完,重新收敛:
按AI清单修改后,小模型顺手生成了稀疏映射器和分组蒙特卡洛配置(稀疏KCL→边界预处理→紧凑模型→分段求解器→分组聚合一体化工作流),256×256阵列压测收敛验证通过。报错消失,仿真顺利完成,峰值内存从98GB+(稠密全并行)压到28GB(稀疏+分组+紧凑模型),单组仿真从预估12天缩到6小时,100次蒙特卡洛一天跑完,阵列级准确率损失1.7%(满足<2%指标,能效比数据与理论外推吻合,通过课题评审)。
三级平台耗时与可本地部署模型规模:
| 平台 | 单组仿真(256×256万步瞬态) | 可仿真阵列规模 | 峰值内存承载 | 可本地部署模型 |
|---|---|---|---|---|
| A350(高主频8核/64G双通道内存) | 约20小时 | 64×64阵列 | 中小规模Crossbar(<20G内存) | Qwen2.5-7B、Llama3-8B |
| AE450(高主频16核/128G四通道内存) | 约6小时 | 256×256阵列 | 大规模阵列+4job并行(<40G内存) | Qwen2.5-14B、CodeQwen |
| GA660M(超高主频32核/256G八通道内存) | 约2.5小时 | 512×512阵列/多job并行 | 超大规模KCL矩阵(<72G内存) | Qwen2.5-32B、DeepSeek-Coder-V2-Lite |
注:GA660M凭借超高主频+大L3+八通道内存,LU分解、蒙特卡洛扫描、本地AI辅助三线可同时推进互不抢带宽,多映射矩阵(多网络结构×多器件模型×多非理想效应共几十组仿真)批量吞吐比AE450提升约85%。
四、UltraLAB三级配置表(忆阻器仿真专用)
入门级平台:A350
高主频8核CPU,最高5.0GHz,64G DDR5双通道,L3缓存36MB。算例在稠密KCL+100实现全并行模式下,内存直接爆掉,报错Out of memory。改稀疏存储+分组4路后峰值约18G,64G内存可稳定运行,64×64阵列单组仿真20小时。该平台适合本科毕设、小阵列验证、映射算法入门,主频高装配快,一天能迭代十几版映射策略,但36MB L3和双通道带宽是256×256大规模仿真的硬门槛。可本地部署模型:Qwen2.5-7B、Llama3-8B。
专业级平台:AE450
高主频16核CPU,最高5.5GHz,128G DDR5四通道ECC,L3缓存384MB。算例全程稳定计算,稀疏KCL+紧凑模型工作集约28G,4个蒙特卡洛job并行调度余量约8G,结果增量聚合约4G,总峰值约40G,128G内存宽裕;单组仿真6小时,全程未出现OOM或步长崩溃。384MB超大L3让G矩阵块和电压向量基本驻留,KLU分解几乎零未命中;5.5GHz高主频让单步分解从6秒压到2.3秒;四通道内存让4个job并行装配互不拖后腿。这个平台是存算一体、神经形态、新型存储团队的甜点配置,256×256阵列、多效应蒙特卡洛、能效分析,满足日常模型迭代需求。可本地部署模型:Qwen2.5-14B、CodeQwen。
旗舰级平台:GA660M
超高主频32核双路CPU,最高5.8GHz,256G DDR5八通道ECC,双路L3缓存512MB。单组仿真约2.5小时,比AE450快约2.4倍——LU分解、蒙特卡洛扫描、本地AI辅助三线满血推进,大内存优势直接放大到512×512阵列和几十组并行job。双路512MB L3和八通道内存让大规模稀疏矩阵和几十组蒙特卡洛的工作集大部分驻留。但这里也必须诚实说明:GA660M相比AE450的提速依赖多job分片纪律,单仿真LU分解内部永远串行,强行超并行无效。GA660M的真正价值在于多映射矩阵——如果实验室需要同时跑8种网络结构×10种器件模型×5种非理想效应共400组仿真,双路平台可以多job满血轮转,总吞吐量比AE450提升约85%。八通道内存带宽让多job装配互不干扰,256G系统内存能稳住更复杂的场景(如卷积层Winograd映射、多Crossbar分层互连、片上训练反向传播阵列、硬件安全木马仿真)。可本地部署模型:Qwen2.5-32B、DeepSeek-Coder-V2-Lite、CodeLlama-34B。
五、工程选型与调试策略
1. 按阵列规模选平台:小阵列验证/256生产/多映射矩阵
- 小阵列验证(64×64以下、映射算法、单效应分析):A350足够,重点优化稀疏存储和分组配置,64G内存即可;
- 256生产(256×256、多效应蒙特卡洛、能效报告):AE450是甜点,128G内存+四通道+16核能覆盖大多数存算团队需求;
- 多映射矩阵(512×512、400组仿真、片上训练):必须上GA660M,256G内存+双路并行,否则仿真排队时间比流片周期还长。
2. 稠密KCL vs. 稀疏存储+紧凑模型:别让SPICE背全锅
很多卡顿不是求解器的错,是建模策略太粗放。建议采用稀疏KCL+紧凑Verilog-A模型+分段求解器:内存砍70%、速度×5、数值稳定——这个仿真链改造,正是本地AI帮你写映射代码的典型场景。
**3. 水冷+ECC:7×24仿真平台的稳定性底线”
仿真服务器一旦成了存算设计的”虚拟示波器”,7×24不能停,消费级平台的散热波动会导致CPU降频,分解耗时忽快忽慢拖长扫描周期。ECC内存更是刚需——非ECC内存在连续多天高负载分解下出现单比特翻转,可能导致某个电导值异常,推理结果出现隐性误差,流片比对时才发现数据不可信。水冷+ECC是仿真服务工程化的底线配置。
4. 单组调试 vs. 批量成本:先跑通一个完整推理周期
在正式发起百次蒙特卡洛前,务必用单输入样本单阵列模式跑通完整权重映射→KCL装配→稳态求解→电流读出→精度评估链,确认稀疏格式正确性、边界预处理有效性、紧凑模型与细ODE一致性全链路无异常。很多崩溃源于配置里的隐式问题(如电导单位换算错误、边界节点悬空、噪声模型注入位置错误),单组看不出来,百次全开直接全部翻车。调试阶段用A350,批量扫描阶段再切GA660M,成本最优。
六、结语
忆阻Crossbar仿真的门槛,从来不只是”两层电极夹阻变层”那么简单。阵列尺寸×时间步数×蒙特卡洛轮数背后,是稀疏利用、模型紧凑、步长分段、并行统计的工程细节堆叠。SPICE本身很强大,但把它的潜力榨干,需要一台在主频、缓存、内存容量、带宽上都没有短板的机器——仿真卡顿的门槛,本质是”求解策略不善”的代价,稀疏KCL一开,单机扛256×256阵列全效应验证。本地部署AI大模型帮你写阵列映射代码,不是为了让AI替你定器件结构(结构必须PI评审),而是把它当成一个24小时在线的存算架构助教——查奇异矩阵报错、列紧凑模型改造清单、写稀疏映射器脚本,把Crossbar老师傅的调参套路请进内网,在器件数据保密期内把仿真效率从”两周卡顿”变成”一天出能效曲线”。计算+AI本地部署,让存算设计资产既安全又高效。
你的Crossbar仿真最大跑过多少乘多少的阵列?评论区聊聊👇
咨询微信号:Munchen_1900











