
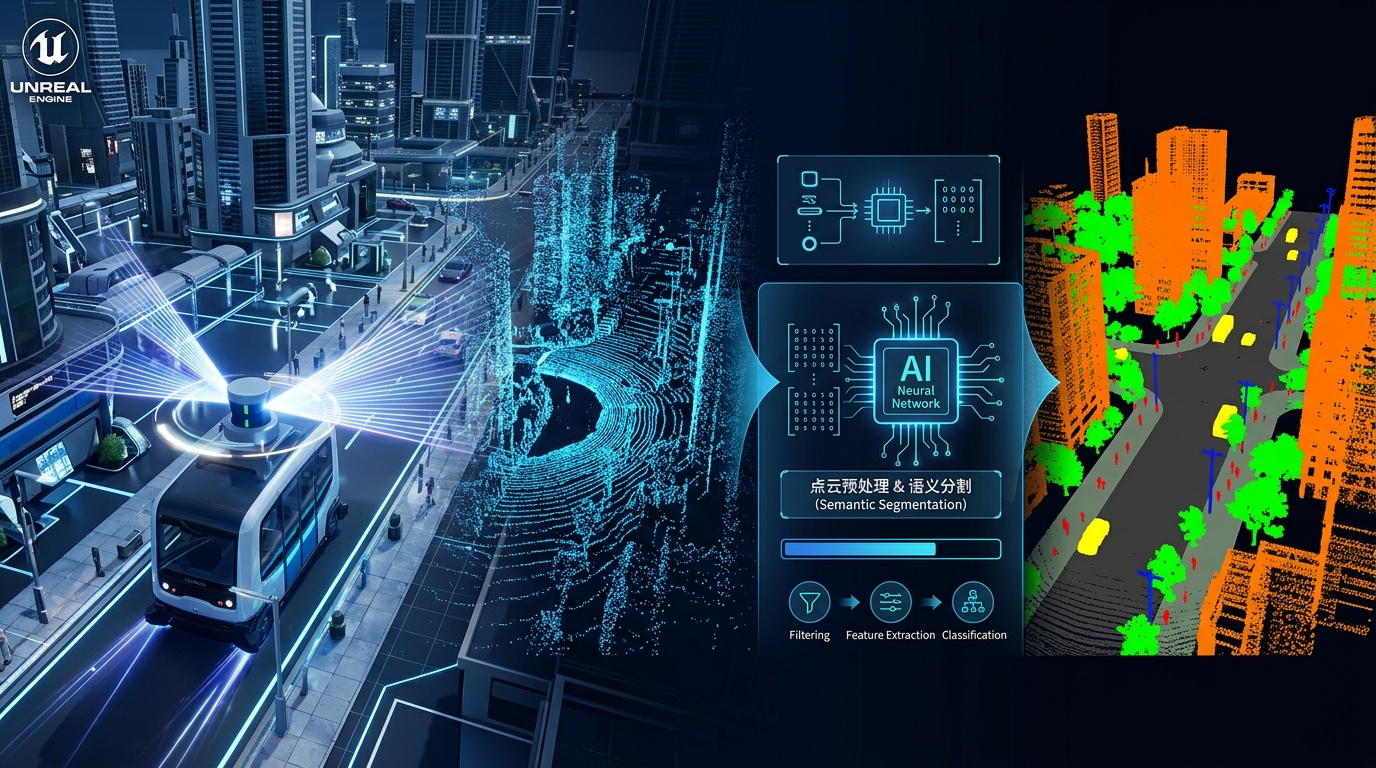
一、项目缘起:一堆点云,和一个看似简单的需求
2026年初,一个做自动驾驶感知算法的团队接到了一桩典型的委托:客户在车上装了一批混合固态激光雷达,跑了几个月,攒下了几百TB的原始点云,希望团队帮忙做两件事:把点云里的道路、车辆、行人、植被分清楚(语义分割),再把结果整理成可读的场景理解报告。
听起来是点云处理的常规活,但团队负责人心里清楚,这事没那么简单。2026年的激光雷达行业正在经历一场估值逻辑的重构。光大证券在2026年5月27日发布的行业深度报告里明确指出,AI大模型正在从二维向三维跃迁,而激光雷达点云作为原生三维数据,可以直接输出三维坐标,无需经过神经网络推理或光栅化渲染即可复用。报告里还提到两个标志性动作:小马智行使用激光雷达点云作为真值来训练BEV感知模型;速腾聚创与库犸科技达成了三年内120万台固态激光雷达的合作。点云的数据价值,正在从”传感器的副产品”变成”可以喂给大模型的资产”。
与此同时,行业里也发生着另一场争论。2026年,小鹏汽车宣布新车型移除激光雷达、转向纯视觉路线,给出的理由之一是点云数据格式难以被大语言模型有效吸收,而图像数据与大模型生态天然兼容。这个说法在行业内引发了大量讨论。它恰好点出了这个团队要解决的真正难题:怎么让大模型读懂点云?
二、技术攻关第一步:小规模验证,先把基线跑通
团队的第一个决定是不急着上大模型,先用经典点云算法把流程跑通。他们选了公开数据集做基准,用PointNet++和RandLA-Net这类经典网络跑语义分割基线,确认标注格式、评测指标、数据预处理管线的正确性。
这个阶段的数据规模不大,单帧点云几十万到上百万个点,训练一张模型、跑一个语义分割推理,对硬件的要求其实相当温和。真正花时间的是数据清洗:原始点云里混着大量的噪声点、运动畸变和天气退化帧,这些脏数据不处理掉,后面的模型会被带偏。
这个阶段团队用的是一台普通的单卡工作站。点云前处理(滤波、降采样、坐标转换)主要吃CPU单核性能和内存容量,GPU只负责网络前向。一台入门级的图形工作站就够用了,没必要一开始就堆多卡。
三、技术攻关第二步:模型构建,显存开始吃紧
基线跑通之后,团队开始构建正式模型。方向是两个:一是用Point Transformer V3这类更强的点云骨干网络提升分割精度,二是尝试把点云特征与语言模型对齐,让模型输出的不只是类别标签,还有自然语言描述。
问题在这里出现了。点云骨干网络的参数量虽然不大,但点云的计算有个特点:每个点都要和邻域点做特征聚合,邻域半径一大,显存占用就呈平方级增长。训练时一个batch塞不下几帧点云,显存就直接顶满。更麻烦的是数据增广,旋转、缩放、点云混合(mixing)这些操作要在GPU上实时做,进一步压缩了显存余量。
团队试了两个办法:降低单帧点数(损失精度),或者换更激进的稀疏卷积。最终他们选择了后者,同时把训练批次拆小、累积梯度。这一步让他们意识到:点云训练的显存瓶颈,往往比模型参数表上写的数字更凶。
四、技术攻关第三步:结果分析,点云真值的飞轮转起来了
模型训练完,进入结果分析和迭代阶段。团队把分割结果与激光雷达真值对比,发现了一个有趣的现象:激光雷达点云天然带精确三维坐标,作为真值训练其他传感器模型时,精度远高于视觉重建——行业里纯视觉的NeRF重建通常只能到分米级相对误差,而激光雷达可以做到厘米级。这正是小马智行拿点云当真值训练BEV模型的原因。
团队也借此搭起了自己的数据飞轮:新采集的点云先过一遍分割模型出伪标注,再抽帧交给本地大模型做语义审核和描述生成,人工只复核存疑帧。标注成本降了一个数量级,迭代速度反而快了。这个阶段对存储IO和并发提出了新要求:几个人同时标注、训练、推理,内存和显存都要留余量。
五、让大模型读懂点云:本地部署成为必选项
5.1 为什么必须本地化
接下来是整个项目最难、也最有价值的部分:用大模型辅助点云数据的标注与报告生成。团队列出三条本地部署的硬理由:
- 数据合规:道路点云涉及地理信息安全,委托方要求数据不出内网,云端API调用直接排除。
- 长期成本:几百TB点云要做伪标注、清洗和报告生成,按API计费是持续开支,本地推理一次投入、长期摊薄。
- 离线可用:外场采集车常处弱网环境,标注工具链须离线运转。
5.2 模型选型与显存估算
选型上,团队定了两档:Qwen3-32B承担标注辅助、代码生成和报告初稿;GLM-4.5(MoE架构,总参数355B、激活参数32B)承担更复杂推理任务,如场景规则推理和多跳分析。
显存估算的经验公式:所需显存≈参数量×量化字节数×1.2(KV cache与系统开销预留)。FP16每参数2字节,为无损基线;Q8占1字节,精度损失极小;Q4占0.5字节,有少量损失但工程场景通常可接受,且显存减半、推理更快,是消费级默认选择。按这个口径算:
- Qwen3-32B:Q4约19~22GB,24GB显存即可跑起来,解码速度几十tokens/s;Q8约33GB,需48GB显存才宽裕。
- GLM-4.5:这里有个MoE的坑——显存按总参数算,不按激活参数算。Q4量化后约需213GB,单张96GB的卡装不下,至少需三张同规格显卡并联。
- 中间档GLM-4.5-Air(总参数106B):Q4约64GB,一张80GB显存的数据中心卡即可拿下,是单机部署MoE的务实选择。
5.3 速度量级与微调的现实
纯CPU推理只有个位数tokens/s,标注几百帧点云能跑到天荒地老;单卡GPU可以到几十甚至上百tokens/s,这是可用与不可用的分水岭。微调是另一笔账:LoRA只增加3~5GB显存,给Qwen3-32B做点云术语适配完全可行;全参数微调32B模型,显存需求是推理的数倍,直接决定配置档位能否上探。
最终部署方案:Qwen3-32B(Q4)跑在标注工作站上负责高频任务,GLM-4.5-Air(Q4)跑在微调工作站上负责复杂推理,满血GLM-4.5留给扩容时的多卡方案。
六、主要软件
这个项目的软件栈大致分四层:
- 点云处理基础库:PCL、Open3D,做点云滤波、配准、降采样、特征提取,几乎是所有点云算法的地基。
- 深度学习框架与模型库:PyTorch加OpenPCDet或MMDetection3D,承载点云分割、检测网络的训练与推理。
- 标注与可视化:SUSTechPOINTS、LabelCloud做点云人工标注,CloudCompare做大规模点云可视化比对。
- 大模型服务与编排:vLLM或Ollama承载本地模型推理,配合RAG框架把场景规则库、历史报告接进大模型的上下文。
七、团队最终选的配置方案
原理聊得再多,最终还是要回到”这台机器能不能把活干完”这个朴素的问题上。点云处理和大模型本地部署对硬件的胃口差别很大——点云前处理吃CPU单核和内存,模型训练吃GPU显存和算力,大模型推理吃显存容量和带宽。团队复盘整个项目周期后,按三个档位整理了配置参考:
方案A:基线验证与轻量标注
适用场景:点云算法基线复现、小规模数据集训练、Qwen3-32B(Q4)本地推理与标注辅助,单人使用。
推荐机型:A350 15396-MCT
- CPU:Intel Core Ultra 7 265K 20核(8性能核全核5.3GHz/12能效核全核3.8GHz)(5.3GHz/3.8GHz为全核超频实测优化频率)
- GPU:RTX 5090 32G 水冷(32GB GDDR7,显存带宽1.79 TB/s)
- 内存:96GB DDR5
- 存储:4TB NVMe
- 显存带宽:1.79 TB/s
方案B:点云大模型训练与GLM-4.5-Air部署
适用场景:Point Transformer等骨干网络全量训练、LoRA微调、GLM-4.5-Air(Q4)单机部署,两到三人小组并发使用。
推荐机型:AX430 127128-MCA
- CPU:Xeon金牌6530 32核2.7GHz(2.7GHz为全核超频实测优化频率)
- GPU:A100 80GB 水冷(80GB HBM2e,显存带宽2 TB/s)
- 内存:128GB DDR5
- 存储:4TB NVMe
- 显存带宽:2 TB/s
方案C:满血GLM-4.5与点云多模态训练
适用场景:满血GLM-4.5(Q4)本地部署、点云-语言多模态模型训练、全参数微调探索、四人以上并发标注与推理。
推荐机型:GX660M 227512-MD3F
- CPU:2×Xeon金牌6530 64核2.7GHz(2.7GHz为全核超频实测优化频率)
- GPU:3×RTX Pro 6000 96GB(单卡96GB GDDR7,单卡显存带宽1.79 TB/s)
- 内存:512GB DDR5
- 存储:8TB NVMe
- 显存带宽:1.79 TB/s(单卡)
八、如果重来一次,我们会怎么做
复盘下来,团队总结了几条值得后来者参考的教训:
- 存储规划要趁早。几百TB点云先堆进普通硬盘阵列,后来训练时IO跟不上的教训,代价是一次整体迁移。点云数据尽量从第一天就分层存放:热数据放NVMe,冷数据放SATA。
- 别用CPU硬扛大模型。前期有成员在办公机上用CPU跑32B模型做测试,一个标注流程跑了六个小时,换回GPU工作站后十几分钟搞定,这个对比让所有人印象深刻。
- 先跑通小闭环再扩规模。先把”采集—分割—伪标注—人工复核—回流训练”的小循环验证清楚,确认标注质量达标后再加大算力投入,顺序反过来就是烧钱。
- 模型选型留台阶。先用GLM-4.5-Air验证流程,再决定要不要上满血版,比一步到位买满配机器风险小得多——MoE模型的显存按总参数算这件事,是部署前必须算清楚的账。
九、常见FAQ
点云处理到底吃CPU还是吃GPU?
分阶段。点云预处理(滤波、降采样、配准)主要依赖CPU单核性能和内存容量;深度学习训练和推理主要依赖GPU显存与算力。所以点云工作站的合理形态是高频CPU配大内存,再按模型规模配显卡,两边都不能瘸腿。
Qwen3-32B本地部署需要多少显存?
Q4量化约19~22GB,24GB显存可以流畅运行;Q8约33GB,建议48GB显存。这是当前消费级和专业级显卡都够得着的档位,也是标注辅助、报告生成这类高频任务的性价比选择。
满血GLM-4.5单机跑得动吗?
跑得动,但要算清楚账。它是355B总参数的MoE模型,显存按总参数算:Q4约需213GB,至少需要三张96GB显存级别的显卡并联。单机三卡方案能落地,预算有限时可以先用GLM-4.5-Air(Q4约64GB)过渡。
固态激光雷达的点云和传统机械式雷达,处理上有区别吗?
有。固态雷达视场角通常更窄、点云分布更不均匀,边缘区域点密度骤降,对算法的鲁棒性要求更高。但数据格式一致,处理管线通用,主要区别在数据增广策略和模型对稀疏区域的适应能力。
实验室已经有服务器了,还需要工作站吗?
看场景。机架服务器适合集中式训练任务,但点云标注、外场数据回传后的快速质检、大模型交互式调试,这些需要人在回路的工作在塔式工作站上体验好很多。很多团队是”工作站做交互和轻训练,服务器做重训练”的组合。
点云数据量很大,存储该怎么配?
参考分层思路:系统盘用高速NVMe保证软件流畅;热数据盘(近一个月采集的点云)放NVMe保证训练读取速度;冷数据归档用SATA机械盘。预算充足的话,20TB起步的数据盘是几百TB点云项目的及格线。
十、结语
这个项目最后交付的成果,是一套用激光雷达点云驱动的场景理解流程:分割模型负责把三维世界切分清楚,本地部署的大模型负责把切分结果翻译成人能读懂的语言。回头看,固态激光雷达降价放量、点云数据积累、大模型向三维跃迁,三件事在2026年撞在了一起。对于激光雷达感知团队来说,点云处理的每一级瓶颈都有对应的硬件解法。把需求想清楚再选配置,比盲目堆料更省钱也更省心。
欢迎咨询~
微信号:maxftxwx
fuyiqin@xasun.com












