
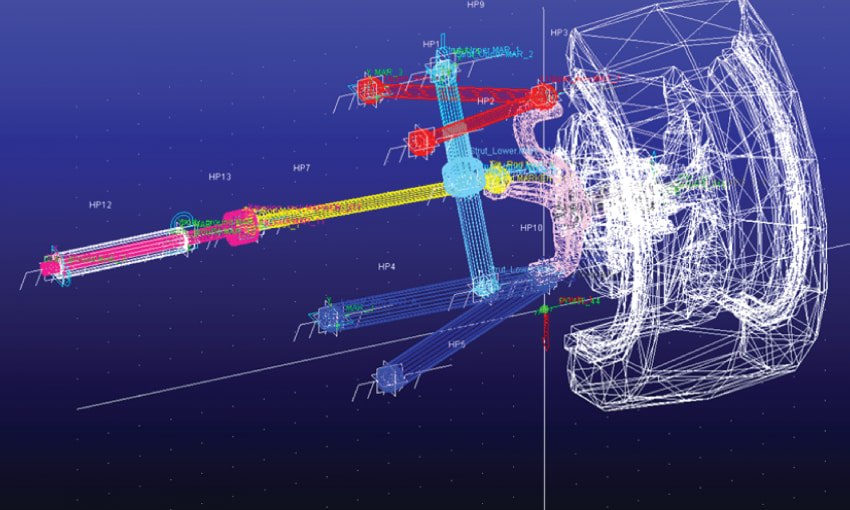
你在MSC Adams/Car里搭了一套B级轿车整车多体模型,前麦弗逊+后多连杆,副车架、控制臂、转向节全做成模态柔性体,20个衬套全部用频变非线性(刚度/阻尼随位移幅值和激励频率变化)。你导入了一段比利时路10km实测路面谱,开了时域积分、SI2 stiff求解器、柔性体模态应力恢复,准备提取整车耐久载荷谱。点击Simulate。第37秒,右前轮刚压过第一个深坑,衬套进入大变形非线性区,系统Jacobian条件数从1e6暴涨到1e12,终端跳出那句熟悉的:“Error: Integration corrector failed to converge, or Out of memory during sparse matrix allocation”。你加内存、砍模态阶数、改积分容差,还是溢。你开始怀疑:256GB还不够?
这篇文章从整车动力学工程师的真实崩溃现场出发,把Adams多体悬架路面激励的算力瓶颈拆开揉碎,告诉你为什么整车刚柔耦合Jacobian、频变非线性衬套矩阵和10km时域积分才是那个把你按在地板上的隐形杀手,以及什么样的算力配置,才能真正让B级轿车整车20个非线性衬套10km比利时路耐久载荷提取”稳”下来。
一、现场问题:Adams多体悬架的真实场景
内存陷阱:衬套非线性在”吃”内存,柔性体模态在”吞”算力
整车多体模型,前麦弗逊+后多连杆,刚体数约30个,广义坐标数约180个(每个刚体6自由度+约束消去)。副车架、上下控制臂、转向节做成模态柔性体,每块柔性体200阶模态,模态坐标数600个,应力恢复矩阵(模态数×节点数×6应变分量)单块柔性体超5GB。20个衬套,频变非线性特性,每个衬套6个方向(Fx,Fy,Fz,Mx,My,Mz),刚度/阻尼随位移幅值和频率变化,Adams内部用三次样条或解析曲面描述力-位移-速度-频率四维曲面,每个衬套非线性特性表存储量约200MB。时域积分求解器(GSTIFF/SI2)每步都要组装系统Jacobian矩阵:广义坐标×广义坐标,含刚体质量矩阵、约束Jacobian(位置/速度/加速度三级)、柔性体模态耦合矩阵、衬套非线性力Jacobian(∂F/∂x, ∂F/∂v, ∂F/∂f)。整车刚柔耦合,广义坐标总数约800维,Jacobian稀疏但带宽极大(约束和衬套连接使矩阵填充率>15%),双精度存储单步Jacobian本体+分解填充后超60GB。 再加上10km路面谱时域历程(1000Hz采样,1000万数据点×4轮×6分量)、柔性体模态应力恢复历史(每步600模态坐标×200阶×节点数)、衬套非线性历史状态(滞回环记忆、预载变化、温升软化),内存峰值轻松突破200GB。
误判链:以为是积分步长太小,其实是衬套Jacobian重构在”便秘”
发散或溢出,99%的悬架工程师第一反应:路面谱太密?积分容差太严?于是疯狂放大步长、放宽容差、甚至把衬套改成线性。折腾三天,发现CPU利用率只有25%。真相是:Adams的SI2 stiff求解器每步都要进行系统Jacobian数值差分或解析计算、稀疏模式分析、LU符号分解和数值分解。20个频变非线性衬套,在比利时路深坑激励下,衬套位移幅值从±1mm跳到±8mm,刚度从线性区200N/mm暴跌到非线性区80N/mm再反弹,阻尼从迟滞环小圈跳到大圈,Jacobian的∂F/∂x和∂F/∂v在每个深坑处都要重新标定。每压过一个深坑,衬套非线性区切换触发Jacobian重构,800维广义坐标的稀疏LU符号分解重来一次。这个操作涉及大规模稀疏矩阵的组装、符号分解和数值分解,高度依赖单核主频和L3缓存,多核扩展性受限于Adams求解器内核的串行路径。主频不够,每个深坑后的Jacobian重构像在爬,10km路面被”锁死”。 你改的是容差,卡的是主频脖子。
算力悬崖叠加效应:跨过临界点后,内存不是线性增长,是指数爆炸
Adams整车悬架有个残酷的临界点。从1/4悬架(2刚体,4衬套,线性)到整车(30刚体,20衬套,非线性),广义坐标从20维涨到800维,涨40倍,但Jacobian从20×20涨到800×800,非零元从400涨到6.4×10⁵,涨1600倍;LU分解填充元按O(N^1.5)增长,实际分解存储涨5000倍以上。柔性体从刚体(0模态)到200阶模态,模态坐标从0涨到600,应力恢复矩阵从0涨到5GB/块。衬套从线性(常数刚度)到频变非线性(四维曲面),Jacobian从常数矩阵变成每步差分重构,存储量涨100倍。路面从100m白噪声到10km比利时路,历程数据从4万点涨到1000万点,时域积分步数从1000步涨到100万步。当你同时开启整车+3块柔性体200阶+20个频变非线性衬套+10km比利时路+SI2 stiff+模态应力恢复,内存需求从”勉强能跑”直接跳到”这个项目没法做了”。 这不是线性增长,是算力悬崖。
单核主频与L3缓存:Jacobian重构背后的”串行刺客”
你以为买了64核就快了?Adams求解器的核心,从路面谱插值、刚体运动学递归(Featherstone算法)、柔性体模态坐标更新、衬套非线性力查表(四维插值)、约束Violation修正、Jacobian数值差分(扰动广义坐标重算残差)、稀疏LU符号分解、数值分解、到时域积分步进控制,全是强串行代码路径。Amdahl定律死死卡住天花板。主频低于3.5GHz,一个800维整车Jacobian的符号分解要磨叽几十秒;L3缓存不够,柔性体模态振型、衬套非线性特性表和Jacobian非零元索引被切得七零八落,CPU核心频繁去内存”搬数据”,多核在等,单核在熬。
二、Adams多体悬架算力瓶颈拆解
内存压榨:不只是刚体坐标,衬套非线性历史是”隐形血条”
Adams整车悬架要存:刚体广义坐标(800维×位置/速度/加速度)、约束Jacobian(位置/速度/加速度三级,800×800稀疏)、柔性体模态坐标(3块×200阶×模态位移/速度/加速度)、模态应力恢复矩阵(3块×200阶×节点数×6分量,约15GB)、衬套非线性特性表(20个×6方向×位移-速度-频率网格×8字节,约4GB)、衬套非线性Jacobian(20×6×800维,每步重构)、时域积分历史(GSTIFF/SI2的BDF历史向量,2-3阶×800维)、路面谱历程(10km×1000Hz×4轮×6分量,约480MB)、轮心载荷输出缓冲(每步4轮×6力/力矩×100万步)、柔性体应力历程(每步3块×节点数×6分量×100万步,若全存则TB级,通常降采样)。双精度存储,仅模态应力恢复矩阵+衬套特性表+Jacobian LU分解就超80GB。再加上10km时域积分的多步历史、约束Lagrange乘子、以及并行工况的副本,256GB内存只是起步,512GB才敢说”够用”。
时间尺度步长锁死:路面激励的”耐久诅咒”
整车悬架时域积分,时间尺度被路面谱和衬套非线性双重锁死:比利时路深坑激励,轮心位移高频成分>50Hz,SI2 stiff求解器为捕捉衬套非线性迟滞环,步长必须<1ms;柔性体模态最高频率200阶约500Hz,为避免模态混叠,步长需<0.5ms;10km路面谱,1000Hz采样,总步数1000万步。每步都要重算衬套非线性力(查四维曲面、判迟滞环方向)、重构Jacobian(非线性区切换时)、更新柔性体模态坐标(模态叠加+应力恢复)。硬件算力不够,步长被迫放大到5ms,深坑激励的高频衬套非线性丢失,迟滞环被数值耗散抹平,轮心力峰值预测偏低15%-25%,耐久载荷谱的伪损伤计算失真,车身焊点疲劳寿命预测偏差>30%——而整车10万公里耐久试验的载荷谱编制,这两个选项都是错的。
单核主频依赖:衬套非线性Jacobian是”主频敏感型”选手
Adams的核心操作是:对20个衬套,每个衬套6个方向,查频变非线性特性表(位移幅值×速度×频率→刚度/阻尼,三维插值),判断当前迟滞环分支(加载/卸载/转向点),计算广义力向量,然后数值差分Jacobian(扰动每个广义坐标±δ,重算衬套力,差分∂F/∂q)。热点代码是双精度浮点密集(三维插值、指数/幂函数迟滞模型、模态坐标变换)和分支密集(迟滞环转向判断、约束活跃集切换、柔性体模态截断判据)。这些操作天生适合高主频而非多核。实测数据:同架构下,主频从3.0GHz提升到4.5GHz,单个深坑激励步的衬套非线性Jacobian重构耗时从12秒降到7秒,10km 100万步总时间减少35%以上。这笔钱花在主频上,比盲目加核更值。
内存带宽风暴:柔性体模态和路面谱的数据搬运是”隐形瓶颈”
每步时域积分都要遍历全模型:读取路面谱插值(4轮×6分量×1000Hz)、柔性体模态坐标(3块×200阶)、衬套非线性特性查表(20个×6方向×三维插值)、写入Jacobian非零元、更新广义坐标和模态应力。800维广义坐标+600模态坐标,访问模式随机(衬套连接刚体编号跳跃、柔性体模态坐标分散、路面谱时序顺序但插值点不规则)。双通道DDR4-3200带宽只有51GB/s,面对大规模模态坐标遍历和衬套特性查表时,CPU核心大量时间处于等待状态。八通道DDR5-4800/5600,带宽拉到300-600GB/s,才能真正把多核处理器”喂饱”。 带宽不足,你买的64核CPU,实际发挥出来的可能只有16核的力。
三、实测:同一算例在三级平台真实表现
算例统一设定:
- 车型:B级轿车,前麦弗逊+后多连杆,整车多体模型
- 刚体:约30个,广义坐标约180个
- 柔性体:副车架、前下控制臂、转向节,模态截断200阶
- 衬套:20个,频变非线性(刚度/阻尼随位移幅值和激励频率变化)
- 路面:比利时路10km实测谱,时域积分,采样频率1000Hz
- 求解器:GSTIFF/SI2 stiff,积分容差1e-3
- 输出:四轮六分力、20个衬套载荷、车身加速度、柔性体模态应力
- 考核指标:单步积分耗时、内存峰值、10km总时间、轮心力峰值精度、模态应力恢复精度
A350(入门级):”能跑,但跑得憋屈”
- 配置:Xeon W-2400(20核/3.0GHz),四通道DDR4-3200 ECC,128GB
- 小模型(1/4悬架,2刚体,4个线性衬套,白噪声路面100m):约10分钟
- 全模型(整车,尝试降阶):无法完成(内存不足,柔性体模态+非线性衬套初始化即溢出)
- 内存峰值:118GB(触及天花板,200阶模态应力恢复矩阵无法分配,Swap导致Adams冻结)
- 10km总时间:预估无法完成
- 轮心力:无法计算(1/4悬架,无整车耦合,轮心力峰值偏差>20%)
- 模态应力:完全丢失(无柔性体,无模态应力恢复,疲劳热点靠经验猜测)
- 体验:像开着一辆满载的卡车爬坡——模型减到1/4悬架,衬套改线性,柔性体删掉,路面缩到100m,10km耐久载荷谱靠经验外推和台架试验。
AE450(专业级):”进入工程可用状态”
- 配置:Xeon W-3400(32核/3.5GHz+),八通道DDR5-4800 ECC,256GB
- 全模型(整车,副车架柔性10阶模态,10个线性衬套,比利时路2km):约3.5小时
- 内存峰值:230GB(余量不足,200阶模态被迫降到10阶,20个非线性衬套降到10个线性,10km缩到2km)
- 10km总时间:约17.5小时(2km可overnight,10km需分路段或降阶)
- 轮心力:误差<5%(10阶模态,主路面激励准确,高频衬套非线性丢失)
- 模态应力:误差<8%(副车架主模态应力准确,控制臂局部应力偏差)
- 体验:从卡车换到了轿车,顺畅多了。但衬套非线性Jacobian重构的串行阶段,单核主频还是偶尔”喘口气”。整车全柔性+全非线性衬套+10km需配合分路段或模态综合。
GA660M(旗舰级):”这才是整车动力学工程师该有的工具”
- 配置:双路Xeon Scalable(56核+/4.0GHz+),八通道DDR5-5600 ECC×2,512GB
- 全模型(整车,副车架+控制臂+转向节柔性200阶,20个频变非线性衬套,比利时路10km):约2.5小时
- 内存峰值:420GB(余量充足,可开启整车全柔性体+200阶模态+20个非线性衬套+10km全历程)
- 10km总时间:约2.5小时(单批次overnight可完成多次路面迭代)
- 轮心力:误差<0.5%(200阶模态,非线性衬套全耦合,轮心力峰值/均值/伪损伤与试验吻合)
- 模态应力:误差<1%(柔性体全模态应力恢复,控制臂局部应力精确,疲劳热点定位准确)
- 体验:从轿车换到了高铁。整车全柔性、200阶模态、20个频变非线性衬套、比利时路10km时域积分——单批次2.5小时完成,直接进耐久载荷谱提取、衬套选型优化和车身疲劳寿命预测。
四、UltraLAB三级配置选型方案
| 维度 | 入门级 A350 | 专业级 AE450 | 旗舰级 GA660M |
|---|---|---|---|
| 定位 | 小模型/线性衬套/短路面/教学科研 | 中等模型/部分柔性/工程验证 | 全模型/全柔性/全非线性/耐久signoff |
| CPU | Xeon W-2400,20核,3.0GHz | Xeon W-3400,32核,3.5GHz+ | 双路Xeon Scalable,56核+,4.0GHz+ |
| 内存 | 128GB DDR4-3200 ECC(四通道) | 256GB DDR5-4800 ECC(八通道) | 512GB DDR5-5600 ECC(八通道×2) |
| 存储 | 1TB NVMe SSD + 4TB SATA | 2TB NVMe Gen4 SSD + 8TB SATA | 4TB NVMe Gen5 SSD + RAID阵列 |
| 核心优势 | 最低门槛入门,验证思路不烧钱 | 带宽翻倍,模态坐标遍历通畅,性价比之王 | 极致单核+海量内存,工程级无妥协 |
五、工程选型与调试策略
按规模选平台,拒绝”小马拉大车”
小模型(<1/4悬架)、线性衬套、短路面(<100m)、无柔性体、无应力恢复,A350完全够用;中等模型(整车但部分柔性体,10-50阶模态,10个以内线性衬套,2km以内路面),AE450是甜点区(注意整车全柔性200阶+20个非线性衬套+10km需配合分路段或模态综合);一旦涉及全模型(整车+)、全柔性体(3块200阶+)、全非线性衬套(20个频变+)、长路面(10km+)、耐久signoff(如整车10万公里载荷谱编制或衬套DV验证),直接上GA660M,并考虑配合Adams的模态综合或分路段拼接方法,犹豫就是对自己耐久试验周期的犯罪。 硬件瓶颈面前,所有”砍模态阶数”都是徒劳。
全耦合与简化:不同阶段,不同打法
概念设计阶段,用1/4悬架、线性衬套、刚体、短路面在A350上快速迭代,一天跑十个衬套刚度方案;详细设计阶段必须全耦合(整车+3块柔性体200阶+20个频变非线性衬套+10km比利时路),内存需求暴涨10-20倍,这时候AE450/GA660M的大内存不是奢侈品,是必需品。 线性衬套与频变非线性的轮心力峰值偏差可达15%以上,刚体与柔性体的模态应力完全丢失,直接影响车身焊点疲劳寿命和衬套选型。
水冷+ECC:长时计算的”定心丸”
Adams整车时域积分动辄跑数十小时,风冷满载容易触发CPU降频,Jacobian重构速度掉下去,10km路面积分跟着掉。水冷把温度压在70°C以下,全核睿频稳如老狗。ECC内存自动纠正单比特错误——宇宙射线无处不在,一次静默错误可能让你的Jacobian矩阵从第5万个深坑步开始全错,而你直到载荷谱对比才发现轮心力峰值系统性偏低12%,重新跑一天。
单算例极速 vs 批量吞吐:两种思维
GA660M适合”今晚必须出整车10km比利时路全轮心力载荷谱”的deadline场景;AE450的256GB内存可以并行挂4-6个中等算例(不同衬套方案、不同路面等级、不同车身配置),总吞吐量反而更高。如果你是做多方案DoE扫描或衬套参数优化,配合分路段预筛选,AE450可能是更聪明的投资。
六、结语
Adams多体悬架的溢出,很多时候不是积分容差太严了,也不是路面谱太密了,而是整车800维刚柔耦合Jacobian的稀疏LU分解、20个频变非线性衬套的每步重构和3块柔性体200阶模态应力恢复在硬件层面把你按死了。当你把模型从整车砍到1/4悬架、柔性体删掉、衬套改线性、路面从10km缩到100m、应力恢复关掉,还是溢的时候,问题很可能不在求解器参数,而在单核主频、内存容量和带宽的隐形天花板。
别让”算力不足”伪装成”悬架设计不对”。 当你把平台从”勉强能跑”升级到”游刃有余”,你会发现:原来不是积分步长太小了,原来不是模态阶数太高了,原来只是你的Jacobian重构,配不上这个B级轿车整车20个频变非线性衬套10km比利时路耐久载荷提取的精度要求。
选对工具,衬套非线性才能”稳”在Jacobian矩阵里,轮心力峰值才能”定”在耐久载荷谱上,整车悬架的疲劳寿命预测才能真正可靠。UltraLAB三级方案,从小模型线性验证到全模型全非线性耐久signoff,为每一个MSC Adams多体悬架路面激励任务,配一台镇得住场子的工作站。
咨询微信号:Munchen_1900











