
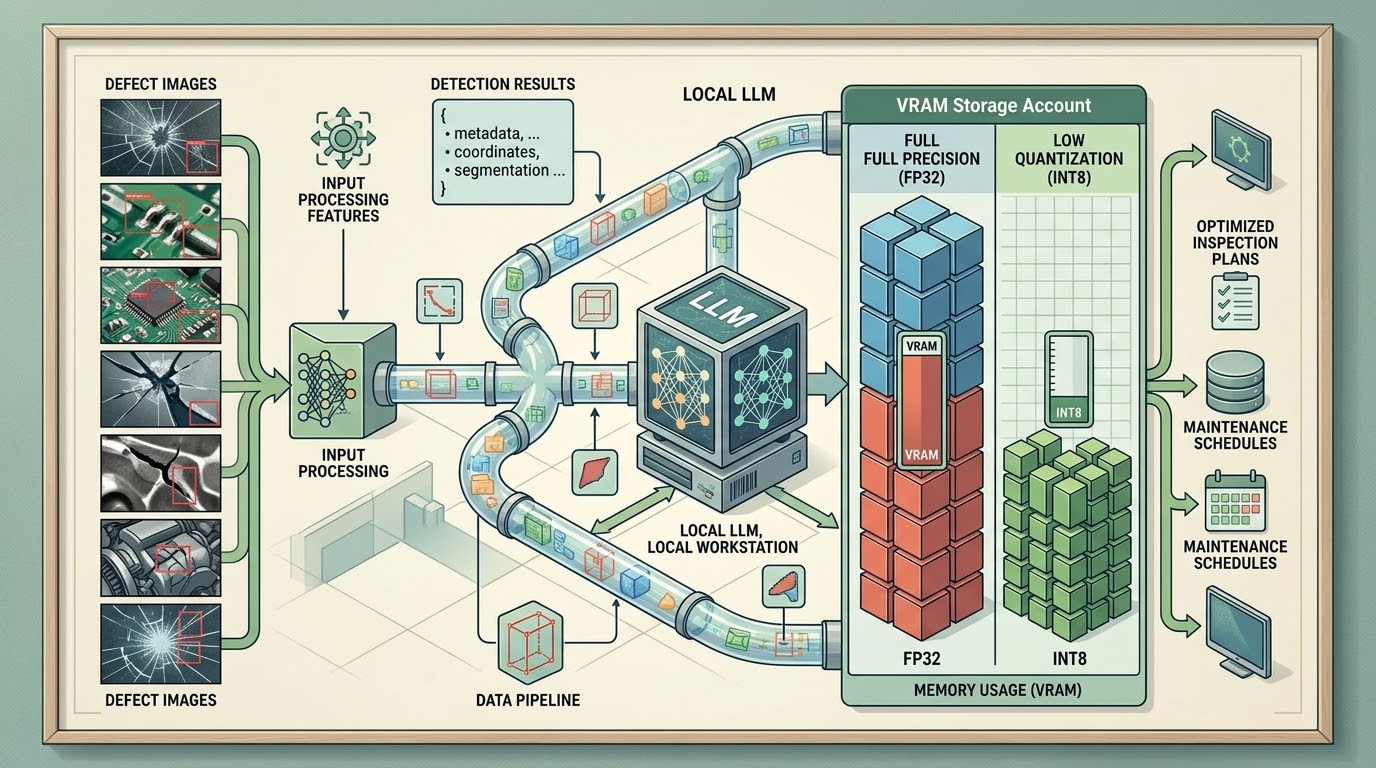
缘起:质检车间里的一双老花眼
2025年初,一家航空零部件制造企业的质检团队接到一项任务:为某型结构件的表面检测建立一套视觉检测系统。此前这道工序全靠老师傅肉眼加放大镜,一盏台灯,一把划痕规。老师傅们颈椎劳损不说,一到下午就眼花,划痕和氧化斑的漏检率肉眼可见地往上走。
团队里负责这件事的工程师,手边当时只有一台办公台式机,显卡还是几年前的入门款。他先跑了个小试验:拍两百张构件表面照片,拿开源检测框架训了个小模型。在背景干净的照片上,划痕识别效果相当漂亮;可照片一换成车间实拍,光线一暗、反光一强,误检漏检立刻翻倍。这个反差,正是整个项目真正的起点。
节点一:数据准备——先过”样本贫瘠”这一关
视觉检测项目的第一道坎,往往卡在数据上,而非算法。
结构件表面的缺陷类型不少:划痕、凹坑、裂纹、氧化变色、碰伤。每一类在产线上的出现频率天差地别,划痕天天见,裂纹可能一个月攒不出十几张。深度学习检测网络偏偏最怕这种贫富分化:多数类越学越好,少数类始终学不会,而稀有缺陷恰恰是质检最该抓住的东西。
团队的对策分两步。第一步是采集规范化:固定工位、固定光源角度、固定相机参数,先把成像条件稳住,让数据分布尽量一致。第二步是数据增广与合成缺陷:对现有样本做旋转、缩放、亮度扰动,再用图像合成手段在完好的构件照片上”贴”出人工缺陷,批量造出稀有类别的样本。
机器视觉替代人眼检测,这条路国内高校早就走过。南京航空航天大学曾研制出一套精密钢球表面缺陷检测技术及装置,用CCD相机采集图像,基于OpenCV函数库实现识别算法,自动完成进料、表面信息展开、缺陷识别与分类分拣,应用于轴承制造检测领域。这套装置的思路放到今天依然成立,但航空构件比钢球难得多:钢球表面规则、背景单一,构件表面有曲率变化、有机加工纹理、有反光,图像复杂度完全不在一个量级。
这个阶段对硬件的要求还不算夸张。图像清洗、标注、增广主要靠CPU多核算力和内存容量,几千张图片的批量处理,一台桌面工作站就能干。但团队很快发现,合成缺陷照片涨到数万张、增广管线跑一轮要几个小时之后,机器明显吃力。这是第一个该换装备的信号。
节点二:成像质量——看不见,就检不出
数据量上去之后,团队撞上了第二道坎:模型在训练集上表现很好,一到现场就”近视”。
排查下来,问题出在成像上。车间顶灯照度不均,构件曲面反光强烈,照片里一半过曝一半死黑。检测网络再聪明,输入图像里缺陷压根没成像,它也检不出来。检测系统的上限,早在相机快门按下的那一刻就定死了。
图像增强因此被提到管线上游。恰好在这个方向上,南京航空航天大学计算机科学与技术学院有一项代表性成果:2024年初,该院梁栋副教授为第一作者、魏明强与陈松灿教授为共同通讯作者的论文《PIE: Physics-inspired Low-light Enhancement》被计算机视觉领域国际顶级期刊IJCV录用,这是该院首次以第一单位和通讯单位在该刊发表论文。这项工作提出物理启发的低光增强对比学习范式,摆脱对成对训练样本的依赖,用非配对样本就能学习低光增强,还设计了无监督的区域亮度一致性准则,避免依赖人工语义标注。低光增强在智能观测里用途很广,而且计算代价低,适合部署到终端上。
这套思路给团队的启发很直接:与其让检测网络硬啃烂图,不如先把图增强好。团队把低照度增强、反光抑制、亮度归一化做成预处理模块,接在相机采集之后、检测推理之前。预处理同样吃硬件:数万张历史照片要重跑一遍增强,增强后再喂给检测网络做离线评估,CPU长时间顶满,GPU也被预处理的小模型占着。
到这里,普通办公台式机已经彻底不够用了。
节点三:模型训练——GPU的主场来了
图像预处理理顺之后,项目进入正题:训练检测网络。
缺陷检测有两个特点,直接决定训练策略。第一,缺陷往往是小目标,划痕在整张照片里可能只占几十个像素,网络必须在高分辨率输入下保持小目标检测能力;输入分辨率一高,显存占用立刻翻倍。第二,类别不平衡严重,训练时要用重采样、损失加权等手段,强行让网络多关注稀有缺陷。
这些技巧的共同代价是算力。一次完整训练动辄在数十万张增强图像上迭代几十个轮次,一块显卡连轴转一整天是常态。团队还想做超参扫描:学习率、输入分辨率、增广强度排列组合,每组配置跑一遍对比,训练任务从”跑完一次”变成”跑完一批”。
这个阶段还有个容易被低估的瓶颈:数据加载。GPU算得再快,CPU预处理和数据读取跟不上,显卡就在空等。开源训练框架通常要开多个数据加载进程并行喂数据,全靠CPU多核和内存带宽撑着。所以训练机讲究均衡:GPU是主角,但CPU和内存不能让GPU挨饿。
团队第一次认真讨论硬件选型,结论很朴素:做视觉检测训练,预算大头应该给GPU,显存决定能开多大的输入分辨率和批量,算力决定一次训练跑多久;CPU多核能力、内存容量和存储读写速度,决定数据管线喂不喂得饱GPU。
节点四:上线运行——真正的消耗才刚刚开始
模型在验证集上达标之后,项目进入部署与迭代期。这恰恰是硬件消耗最持久的阶段。
系统上线后,工位相机每天产生新图像,被判可疑的样本回流进训练集;每隔一段时间,工艺变更或新缺陷类型出现,模型就得增量再训练。训练从一次性事件变成了周期性任务,机器要常年处于”随时能跑”的状态。
更实际的负担是检测报告。每一批受检构件都要出具报告,写明缺陷位置、类型、尺寸、置信度和处置建议。过去这些报告由质检员手工撰写,写报告的时间比跑检测还长。团队的想法很自然:检测网络给出结构化结果,剩下交给语言大模型自动生成规范报告,质检员只做审核。
可检测报告里带着构件图号、工艺参数和客户的验收条款,这些是签了保密协议的东西,往公网接口上送,合规部门第一个不答应。内网部署一台本地大模型,成了唯一走得通的路。
检测报告自动生成:内网部署大模型的显存账
内网部署理由有三:检测图像与工艺数据涉客户保密协议出不了内网;报告生成高频日常,本地年成本远低于按token计费;车间断网流水线不停摆。
选型考察两个模型:智谱2025年7月开源的GLM-4.5-Air,混合专家架构,总参数1060亿、激活120亿,MIT协议权重;阿里Qwen2.5-72B-Instruct,720亿参数密集架构,128K上下文,适合吞长验收条款与工艺文件。
所需显存 ≈ 参数量(B) × 量化字节数 × 1.2
FP16占2字节、Q8占1字节、Q4占0.5字节,1.2为上下文与系统开销预留系数。
算例一,Qwen2.5-72B-Instruct:Q4下72 × 0.5 × 1.2约43GB,48GB以上或双卡才从容;Q8约86GB;FP16约需173GB。算例二,GLM-4.5-Air:MoE显存按总参数算,激活仅120亿省算力省不了显存;Q4下106 × 0.5 × 1.2约64GB,单卡装不下,得双卡或96GB级专业卡。
| 模型 | FP16 | Q8 | Q4 | Q4舒适档 |
|---|---|---|---|---|
| Qwen2.5-72B-Instruct | 约173GB | 约86GB | 39~43GB | 48GB以上或双卡 |
| GLM-4.5-Air | 254GB | 约127GB | 约64GB | 双卡或96GB级 |
量化怎么选?FP16无损但显存翻倍,只用于精度极度敏感场合;Q8损失小、显存减半,适合预算充足团队;Q4每10亿参数约0.6GB,以少量精度损失换消费级硬件可跑,是默认档。
纯CPU靠内存带宽,生成只有个位数tokens/s,一份报告等几分钟;单卡GPU几十到上百tokens/s,报告秒出。这就是工作站与普通电脑的分界线。
至于微调,通用模型写报告措辞不对味,要用LoRA做领域适配,喂历史报告与验收术语。LoRA只训少量外挂参数,中小模型显存增量约35GB,72B级约10GB量级,叠在Q4基座总需求仍在5060GB档;全参数微调是另一个物种:72B优化器状态与梯度会把显存推到数百GB级,多卡才扛得住。推理加轻量微调一台机器就够,直接决定后面方案分档。
软件与工具链
硬件之外,这套系统的软件栈也有讲究。
数据侧需要标注工具和版本管理:缺陷框标注、标注审核、数据集版本回滚,哪一步缺了,后面排查训练问题都会很痛苦。训练侧用主流开源检测框架搭配图像增广库,训练配置统一用配置文件管理,保证每次实验可复现。部署侧分两条线:工位推理走轻量推理框架,报告生成走本地大模型服务框架,把量化后的权重以内网API形式提供给报告流水线。
还有一个容易被忽视的点:全流程日志与可追溯。航空质检对可追溯性要求极高,每一张检测图、每一次模型版本、每一份自动报告,都要能回溯到具体时间和模型快照。选型时就把这条要求设计进去,比事后补洞便宜得多。
从项目回到配置:这套系统该配什么样的机器
聊到这里,技术上的来龙去脉已经清楚:预处理吃CPU与内存,训练吃GPU,报告生成吃显存容量,流水线各环节又要均衡,谁也不拖谁的后腿。接下来是更实际的问题——按这个项目的规模,机器该怎么配。下面这几档方案,是复盘整个项目后按任务规模整理的参考,每档给出适用场景、推荐机型和完整配置,价格按区间标注。
方案A:轻量验证
适用场景:样本量在几千到一两万张,以数据准备和模型可行性验证为主,训练偶尔跑一跑,报告生成用中小规模模型。
推荐机型:A350 15364-MBT
- 价格区间:4~7万
- CPU:Intel Core Ultra 7 265K 20核(8性能核全核5.3GHz/12能效核全核3.8GHz)
- GPU:RTX 5090D v2 24G 水冷
- 内存:64GB DDR5
- 存储:2TB NVMe
- 显存:24GB
- 显存带宽:1.34 TB/s
- 注:CPU频率为UltraLAB全核超频实测优化频率。
方案B:常规训练
适用场景:样本量数万到数十万张,训练与迭代成为日常,单轮训练控制在一天以内,大模型报告生成按Q4量化运行。
推荐机型:AE450 145128-MC2T
- 价格区间:10~18万
- CPU:AMD锐龙Pro 7970X 32核4.5G
- GPU:双RTX 4090 48G 水冷(48GB为第三方定制版,非NVIDIA官方规格)
- 内存:128GB DDR5
- 存储:4TB NVMe
- 显存:96GB
- 显存带宽:2×1.01 TB/s
- 注:CPU频率为UltraLAB全核超频实测优化频率。
方案C:多任务并行
适用场景:检测训练、历史数据增强回刷、大模型报告服务三线并行,需要同时保证显存容量与数据管线吞吐。
推荐机型:GX660M 227384-MD4T
- 价格区间:20~40万
- CPU:2×Xeon金牌6530 64核2.7-4G
- GPU:4×RTX 4090 48G 水冷
- 内存:384GB DDR5
- 存储:8TB NVMe
- 显存:192GB
- 显存带宽:4×1.01 TB/s
- 注:CPU频率为UltraLAB全核超频实测优化频率。
方案D:产线级平台
适用场景:多条产线图像集中处理,70B级大模型以高量化档常驻服务,团队多人共用,要求全年稳定运行。
推荐机型:GX660M 227512-MD4A
- 价格区间:50~80万
- CPU:2×Xeon金牌6530 64核2.7G
- GPU:4×A100 80GB 水冷
- 内存:512GB DDR5
- 存储:8TB NVMe
- 显存:320GB
- 显存带宽:4×2 TB/s
- 注:CPU频率为UltraLAB全核超频实测优化频率。
如果重来一次,我们会这样选
复盘整个项目,有几条经验值得记下来。
第一条,别先买机器再立项。最初用办公台式机硬撑了两个月,表面省钱,实际把数据准备周期拉长了一倍。回过头算,浪费的人力早就超过两台工作站。
第二条,显存买大不买小。训练时为了省预算选了显存偏小的卡,输入分辨率不敢开高,小目标检测效果打了折扣。等换卡时才发现,旧卡残值折损比当初一步到位还贵。
第三条,数据管线要预留余量。CPU和存储看似不紧要,实际训练中显卡空等数据的情况出现过好几次。多开数据加载进程、预留内存和存储余量,比盲目堆显卡更能稳住整体效率。
第四条,大模型部署提前规划。报告生成系统立项比检测晚半年,部署时才发现内网机器显存不够,临时补卡耽误了上线。如果一开始就按”检测训练加报告服务”双需求规划,采购一次到位,能省一轮折腾。
常见问题
缺陷样本太少,直接上深度学习靠谱吗?
样本少恰恰是视觉检测项目的常态。靠成像规范化、合成缺陷增广、损失加权这些手段,几千张样本也能训出可用的模型。关键是先把成像条件固定住,否则样本再多,分布漂移照样拖垮效果。
质检项目里,CPU和GPU各自的分工是什么?
粗略地说:图像增强、数据加载与增广主要靠CPU多核和内存带宽,检测模型训练和大模型推理主要靠GPU的算力与显存。GPU决定训练多快,CPU决定GPU是否挨饿。两头均衡,流水线才顺。
小缺陷总漏检,换更大的模型有用吗?
先别急着换模型。小目标漏检更多与输入分辨率、图像增强质量和标注精度有关。把输入分辨率提上去、把低照度和反光问题在预处理阶段解决,往往比换更大的检测网络见效更快,也更省算力。
检测报告自动生成,能用公网大模型接口吗?
要看数据性质。检测报告通常含构件编号、工艺参数和客户验收条款,多数供货协议明确这些数据不得离厂。这种情况下内网部署开源模型是唯一合规路径,也是长期成本更低的路径。
GLM-4.5-Air的激活参数只有120亿,显存能按120亿算吗?
不能。混合专家架构的显存按总参数算,激活参数省的是算力,省不了显存。106B总参数Q4量化约需64GB显存,按120亿算会严重低估。
内网部署大模型,选Q4量化会不会影响报告质量?
Q4对大多数报告生成场景足够用,措辞规范、术语准确这两点基本不受影响。如果要做极精细的合同条款比对,可以考虑Q8档,显存翻倍,精度余量更足。
结语
这个项目跑完,检测系统的漏检率降了下来,报告出具从按小时计变成按分钟计。回头看,硬件投入的每一分钱都对应着某个具体环节的提速:数据准备快一点,迭代周期就短一点;训练快一点,新缺陷就能早一周被抓住;报告快一点,质检员就能把精力放在真正需要人判断的地方。机器是为人买的,别让机器成为新的瓶颈。
工作站配置选型欢迎咨询~
微信号:maxftxwx
fuyiqin@xasun.com












