
一个专业 和它的三次算力跳变
通信工程是个老牌专业,但最近几年它研究的对象换了好几茬。本科阶段还在啃 4G 的 OFDM 和 MIMO,进实验室发现组里已经在做 6G 的通感一体化,再往前沿看,低轨卫星互联网已经把“基站搬上天”,星座组网、星地融合成了最热的关键词。方向热,算力需求跟着热。
有个背景值得先交代。2024 年底,湖北省发改委认定 48 家湖北省工程研究中心,其中包括依托华中科技大学网络空间安全学院建设的”新一代移动通信(6G/B6G)湖北省工程研究中心”。据工人日报 2025 年 1 月报道,中心负责人、华中科技大学教授江涛介绍,团队自 2008 年组建信息通信与网络实验室,2017 年成立天地一体化信息网络湖北省工程实验室,2021 年又成立第六代移动通信(6G)研究中心,在移动视频传输、低轨卫星通信网络、多场景覆盖、大维智能共生无线通信系统等方面取得多项突破性进展。人民网 2025 年 5 月的报道也把这个中心列为湖北布局 6G 的标志性平台。
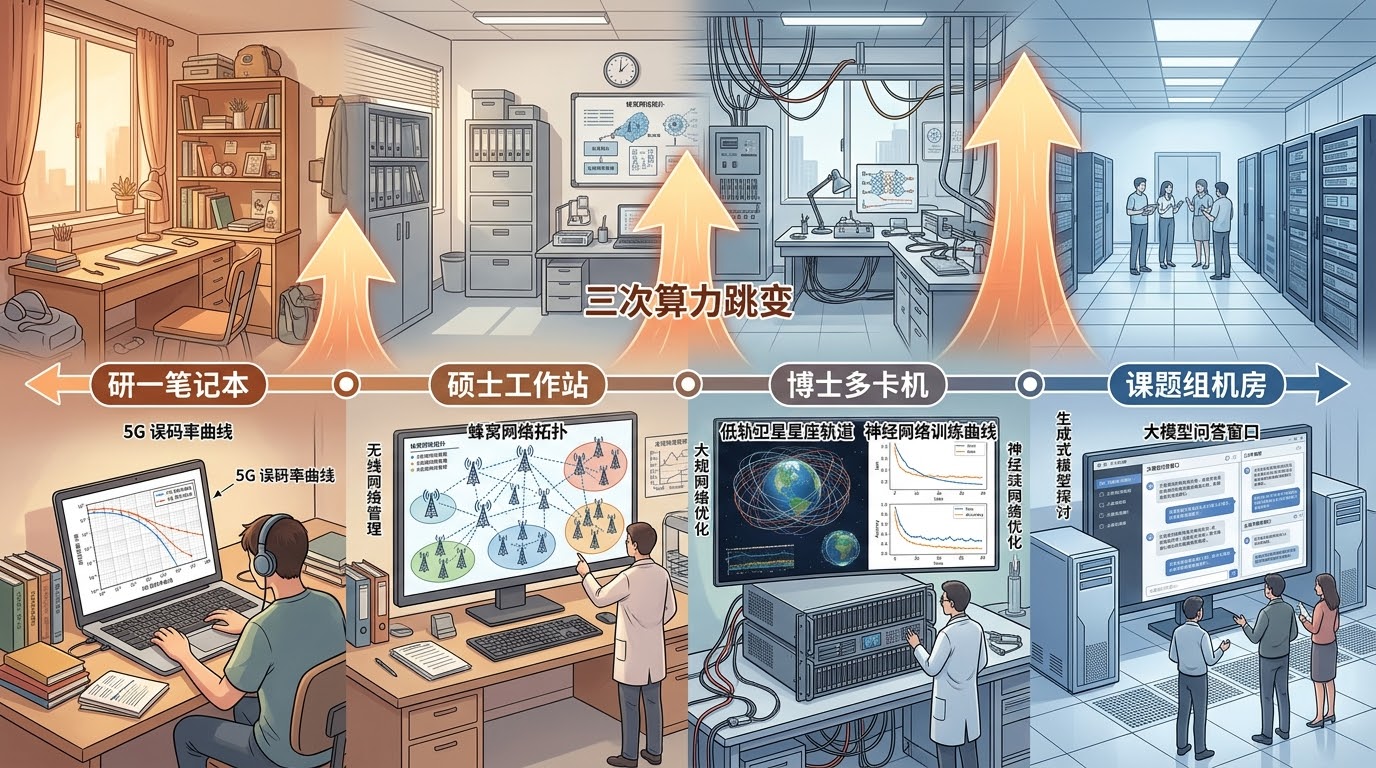
平台是国家的,机器是自己课题组的。一个通信工程研究生从入学到带团队,算力需求至少要经历三次跳变。这篇就按时间线把这三次跳变讲清楚,每一跳对应什么负载、卡在什么硬件上、该换什么样的工作站。
起点 研一:一台游戏本与 5G 链路仿真
研一进组,大部分人背着一台游戏本就上岗了。第一个任务是链路级仿真:用 MATLAB 配 5G NR 波形,调子载波间隔、循环前缀、LDPC 和 Polar 编译码参数,跑误码率曲线。单帧计算量不大,但蒙特卡洛误码率统计要跑成千上万帧,游戏本的风扇从天黑转到天亮。
这个阶段的负载脾气很鲜明:波形生成和编译码逐帧串行推进,吃 CPU 单核主频;误码率扫描天然并行,吃核心数;内存占用随子载波数和帧长线性涨,配置开大了 32GB 内存说满就满。显卡基本在旁边看戏。所以研一这台机器的核心诉求就两条:主频高、内存够。游戏本散热压不住长时间满载,降频之后连纸面性能都保不住,这是第一个隐性坑。
第一跳 硕士中期:系统级仿真把笔记本压垮
课题往上走一层,从”一条链路”变成”一张网络”。系统级仿真要建几十上百个小区,跑调度算法、切换策略、干扰协调,工具从 MATLAB 换成 ns-3 或 OMNeT++,信道模型按 3GPP 38.901 规范配置,大规模 MIMO 的波束管理也要进来。
负载特征整个变了。网络节点数上去之后,仿真状态数据大致随节点数平方增长,内存很容易顶到 64GB 以上;一次全网快照、一次参数扫描的输出动辄几十 GB,硬盘 IO 开始拖后腿;每个场景独立,天然适合多开并行,核心数直接决定一晚上能铺多少组数据。笔记本在这里会同时撞上三堵墙:内存容量、散热、存储。大多数人换机器,都换在这一跳。
第二跳 博士开题:星座仿真是另一个量级的计算
博士课题往前沿再进一步,就是低轨卫星互联网。星座仿真要算轨道、算时变拓扑、算星间链路的路由切换,工具从网络模拟器换成 STK 或自研轨道推演代码,时间步一格一格往前推,蒙特卡洛反复重跑。地面网络里基站不动,卫星网络里一切都动,计算量直接上一个量级。
更关键的是,6G 研究已经把 AI 写进了空口。神经网络做信道估计、做波束预测、做资源调度,这些模型的训练和推理都要 GPU。仿真生成的波形数据集喂给网络,训练出的模型再回仿真环境验证,数据在 CPU 仿真和 GPU 训练之间来回倒。这时候机器的配置逻辑彻底变了:CPU 管推演和调度,GPU 管学习,内存和存储管数据中转,缺一不可。
还有一点容易被忽略:这个方向的课题经常和航天单位、运营商合作,仿真参数、轨道数据、未公开的协议改进方案都在保密协议范围内。机器不仅要算得快,还要把数据留在屋里。
第三跳 课题组公用平台:排队与争抢
博士中后期,组里师弟师妹都来了,新机器变成公用平台。早上一群人抢 CPU 跑系统级仿真,下午抢 GPU 训练神经网络,晚上还有人排队等大模型帮忙改代码。单机时代”我自己协调”的逻辑彻底失效,平台要面对的是多任务并发、显存配额、作业优先级和 7×24 小时满载稳定性。ECC 内存从可选项变成必选项——连续跑十几小时的星座推演,一位软错误就能废掉整晚的结果。
大模型本地部署 通信仿真的智能副驾
通信课题组用大模型,场景很具体:3GPP 协议规范动辄上千页,查条文、比对版本是体力活;MATLAB 与 ns-3 仿真脚本调参改写耗掉半宿。这些活交给本地大模型,能省出整块研究时间。
为什么必须本地部署?三条理由。保密:课题常与航天单位和运营商合作,仿真参数与轨道数据都在保密协议范围内,公网对话框等于违约。离线:外场和内网没有公网。成本:文献问答与代码辅助全天候高频,按 token 计费的 API 拉长到博士周期并不便宜。
模型选型两个就够。DeepSeek-R1-Distill-Qwen-32B 由深度求索 2025 年 1 月随 DeepSeek-R1 开源,约 320 亿参数稠密模型,基于 Qwen2.5-32B 蒸馏,多步推理强,管协议解读、报错诊断、论文草拟。Qwen3-30B-A3B 由阿里通义 2025 年 4 月开源,混合专家(MoE)架构,总参数 305 亿、每 token 只激活约 33 亿,问答和代码补全又快又省。
显存估算用同一个公式:参数量(B)× 量化字节数 × 1.2(KV 缓存与系统开销预留),FP16、Q8、Q4 分别为每参数 2、1、0.5 字节。算例一:Qwen3-30B-A3B 的 Q4 约 18 GB,24 GB 显存从容运行;MoE 省算力不省显存,显存按总参数算。算例二:DeepSeek-R1-Distill-Qwen-32B 的 Q4 约 19 到 22 GB,24 GB 起步,长上下文往 32 GB 以上留;FP16 约 77 GB,得选 96 GB 显存的旗舰卡。
量化三档:FP16 几乎无损但体积翻倍,Q8 损失一到三个百分点,Q4 损失五到十个、只有 FP16 四分之一体积;日常用 Q4,关键推导再切高精度。
速度差着数量级:纯 CPU 内存推理通常个位数 tokens/s,单卡 GPU 能到几十到上百 tokens/s,几十页协议文稿几分钟出摘要——这就是工作站和普通电脑的分水岭。
推理之外是微调:LoRA 微调 32B 模型显存增量约 3 到 5 GB,48 GB 即可边推理边微调;全参数微调是推理的数倍到十数倍,32B 要数百 GB,归多卡平台管。
软件清单
仿真层:MATLAB 配 5G Toolbox 负责链路级,ns-3 和 OMNeT++/INET 负责系统级,GNU Radio 做软件无线电验证,星座轨道用 STK 或开源的 Orekit,Python 科学计算栈做胶水。AI 层:CUDA 驱动打底,vLLM 或 SGLang 对外提供 OpenAI 兼容接口,Ollama 做轻量验证,llama.cpp 兜底离线场景。工程层:Git 管代码,Docker 管环境,仿真数据用 HDF5 归档。授权上,MATLAB 与 STK 按课题组正版口径提前规划,别等验收才发现 license 不够。
如果他们一开始就知道
- 别拿游戏本顶科研机。研一觉得够用,研二系统级仿真一上规模就趴窝,卡住进度的常常是机器。
- 别把预算全砸显卡。通信仿真的前半程靠 CPU 主频和内存吃饭,这两样先保证,再谈 GPU。
- 内存一次买够。平台内存插槽就那么多,后期想加常常被迫整套换平台,前期多买一根比后期换板子便宜得多。
- 大模型部署早做打算。等接了保密项目再折腾离线环境,比一开始就本地部署麻烦得多。
- 给升级留口子。从单机到课题组公用平台是大概率事件,电源功率、PCIe 插槽、机箱空间都要提前留余量。
UltraLAB 配置怎么选
这些年看通信方向的课题组配机器,最容易踩的坑是”买偏了”:链路仿真阶段狂堆显卡,到了星座仿真和 AI 空口阶段才发现 GPU 不够用、内存早就爆满。前面把时间线上的负载变化和显存账都摆清楚了,下面按四个典型节点给参考档位,全是报价表里的实际机型,下单前按课题组的人数、星座规模和模型并发量微调内存与存储即可。
方案A:入门学习与链路仿真档
适用场景:研一阶段,5G 链路级仿真、课程级蒙特卡洛误码率扫描,Qwen3-30B-A3B 与 32B 级模型的 Q4 量化本地推理、协议条文问答。
| 硬件类别 | 具体配置 | 说明 |
|---|---|---|
| CPU | Intel Ultra9 285K (24核, 8P核5.6GHz) +水冷 | 8个高主频P核负责链路级仿真逐帧串行计算,水冷压住蒙特卡洛长时间满载不降频 |
| GPU | RTX5090D v2 24GB+水冷 | 24 GB显存正好覆盖32B级模型的Q4量化本地推理 |
| 内存 | 128GB DDR5 | 大内存吸收误码率扫描随子载波数和帧长线性增长的状态数据 |
| 存储 | 4TB NVME + 8TB SATA | NVMe承载仿真热数据,SATA大容量盘归档批量扫描输出 |
| 显存 | 24 GB | 满足32B模型Q4约19到22 GB的显存底线 |
| 显存带宽 | 1.34 TB/s | 高带宽保证协议问答与代码补全的解码速度 |
推荐机型:A350 153128-MCT
硬件解析:方案A的定位是”主频优先、显卡够用”:24核高主频CPU配128GB内存覆盖链路仿真的全部瓶颈,24GB显存恰好卡在32B模型Q4量化的及格线上,研一阶段的仿真与本地推理一机包办,不把预算浪费在闲置的显卡上。
方案B:课题攻坚与推理增强档
适用场景:硕士课题,大规模系统级仿真与批量参数扫描,DeepSeek-R1-Distill-Qwen-32B 常驻推理加 LoRA 领域微调,兼顾神经网络信道建模入门。
| 硬件类别 | 具体配置 | 说明 |
|---|---|---|
| CPU | Intel Core Ultra 9 285K 24核(8性能核全核5.5GHz/16能效核全核3.8GHz) | 24核并行铺开多场景系统级仿真,高频P核保住逐帧计算速度 |
| GPU | RTX Pro 5000 48G | 48 GB显存让32B模型长上下文推理与LoRA微调同卡常驻,不必排队抢卡 |
| 内存 | 96GB DDR5 | 承接几十上百个小区全网快照随节点数平方增长的内存占用 |
| 存储 | 4TB NVMe | NVMe高速盘应对参数扫描动辄几十GB的快照输出 |
| 显存 | 48G | 32B模型Q4权重加长上下文KV缓存后仍有富余 |
| 显存带宽 | 1.3TB/s | 支撑高频次协议条文问答的吞吐 |
推荐机型:A350 15696-MCE
硬件解析:方案B把升级重心压在显存上:48GB单卡显存让32B长上下文推理和LoRA微调可以并存,24核高频CPU继续扛系统级仿真的并行扫描,是从”仿真为主”过渡到”仿真加微调并重”的中间档,一次到位避免二次换机。
方案C:博士课题与模型微调档
适用场景:星座级卫星互联网仿真、神经网络空口训练,32B 级模型 FP16 高保真推理与 LoRA 微调,超长协议文档 RAG 知识库。
| 硬件类别 | 具体配置 | 说明 |
|---|---|---|
| CPU | Xeon金牌6530 32核2.7G | 32核喂星座轨道推演的时间步推进与蒙特卡洛并行重跑 |
| GPU | RTX Pro 6000 96GB | 96 GB显存单卡装下32B模型FP16高保真权重与LoRA微调增量 |
| 内存 | 128GB DDR5 | 承接时变拓扑与星间链路数据在CPU仿真和GPU训练之间的中转 |
| 存储 | 4TB NVMe | 高速盘承载波形数据集与RAG知识库的高频读写 |
| 显存 | 96G | FP16约77 GB的32B模型权重加KV缓存余量充足 |
| 显存带宽 | 1.8TB/s | 高带宽加速神经网络空口训练的迭代 |
推荐机型:AX430 127128-MCF
硬件解析:方案C换用工作站级Xeon平台把长时满载的可靠性补上,96GB显存单卡恰好覆盖32B模型FP16的显存账,128GB内存承接星座仿真的海量拓扑数据,面向博士课题”仿真、训练、高保真推理”三线并行的长周期工况。
方案D:课题组共享平台档
适用场景:课题组多人并发,星座仿真批量作业与大模型 API 服务同时开跑,多模型常驻,70B 级模型 Q4 量化推理。
| 硬件类别 | 具体配置 | 说明 |
|---|---|---|
| CPU | 2×Xeon金牌6530 64核2.7-4G | 双路64核承接多人并发提交的系统级仿真与轨道推演作业 |
| GPU | 4×RTX 6000D 84G | 四卡合并336 GB显存池,70B Q4量化推理与多模型常驻同时开跑 |
| 内存 | 512GB DDR5 | 多任务并发与星座批量作业的大容量内存池 |
| 存储 | 8TB NVMe | 大容量高速盘扛住多用户快照、数据集与模型权重的混部读写 |
| 显存 | 336G | 70B级模型Q4约40 GB权重加多模型并发余量充足 |
| 显存带宽 | 4×1.6TB/s | 四卡并行带宽支撑API服务的高并发解码 |
推荐机型:GX660M 227512-MD4E
硬件解析:方案D是课题组级的共享算力池:双路64核加512GB内存把CPU仿真并发拉满,四卡84GB显存合并成336GB统一显存池,70B量化推理与多模型常驻可以并行开跑,对应从单机到平台化的最后一跳,也是排队争抢问题的终局解法。
常见问题
链路仿真到底吃 CPU 还是 GPU
吃 CPU,具体是单核主频加内存容量。OFDM 波形生成和编译码逐帧串行推进,主频低一等,同样的帧数就要多跑半小时;蒙特卡洛扫描可以并行,核心数决定一晚上能铺多少数据点。显卡在这个阶段基本闲置,别为它加预算。
系统级仿真为什么越跑越慢
多半是内存不够开始 swap,或者快照文件把硬盘写满。全网仿真的状态数据随节点数平方增长,内存按目标网络规模的三倍规划,热数据放 NVMe,归档走大容量盘。
24 GB 显存能不能跑 32B 模型
Q4 量化能,FP16 不能。上下文拉到 32K 或者两人同时提问,KV 缓存会吃掉余量,建议 32 GB 起步、48 GB 从容,跑 FP16 直接看 96 GB。
MoE 模型激活参数只有 3B,显存是不是很小
这是最常见的误解。显存按总参数 305 亿算,Q4 约 18 GB。省下来的是算力:每 token 只算约 33 亿参数,解码自然快。MoE 省算力,显存一分省不了。
笔记本能撑到毕业吗
课程作业能,课题不能。散热降频、内存上限、没有 ECC,三条都踩在长时仿真的命门上。真要做课题,从方案A起步,后面按节点升级。
结语
回头看这条时间线,算力需求的增长从来不讲道理:链路仿真要主频,系统级仿真要内存和核心,星座仿真加 AI 空口要 GPU,课题组平台全都要。它很少线性爬升,总是在课题升级的节点上指数级跳变。早一点看清自己站在哪个节点,机器就能一次买对,把换机的节奏握在自己手里。











