
本文采用技术分析视角,以清华大学分布式学习研究为参照系探讨行业趋势。文中提及的学术成果均来自公开文献,不代表任何官方立场。硬件配置建议仅供参考。
一、写在前面:数据不出域,模型怎么训?
2024年,一个让AI圈头疼的问题愈发尖锐:大模型训练需要海量数据,但数据分散在各个机构、医院、银行,谁也不愿意把”家底”交出来。
在北京邮电大学计算机学院,齐涛博士(2024年毕业于清华大学电子工程系)的研究给出了一个方向。他提出了差分隐私知识迁移方法,让分布式学习在保护隐私的同时,将现有方法在相同安全条件下对学习性能的损害降低了84.2%。
而在清华丘成桐数学科学中心,户将团队在2024年获得了ICASSP唯一最佳论文奖(从近3000篇接收论文中脱颖而出的唯一一篇),他们的研究方向正是流形优化与联邦学习——解决数据异质性和通信限制下的分布式优化难题。
与此同时,清华交叉信息研究院姚期智院士(图灵奖得主,2024年获基础科学终身成就奖)领导的团队,正在探索大语言模型训练中的分布式优化策略,他们提出的TPA注意力架构是对DeepSeek V3的MLA机制的改进方案。
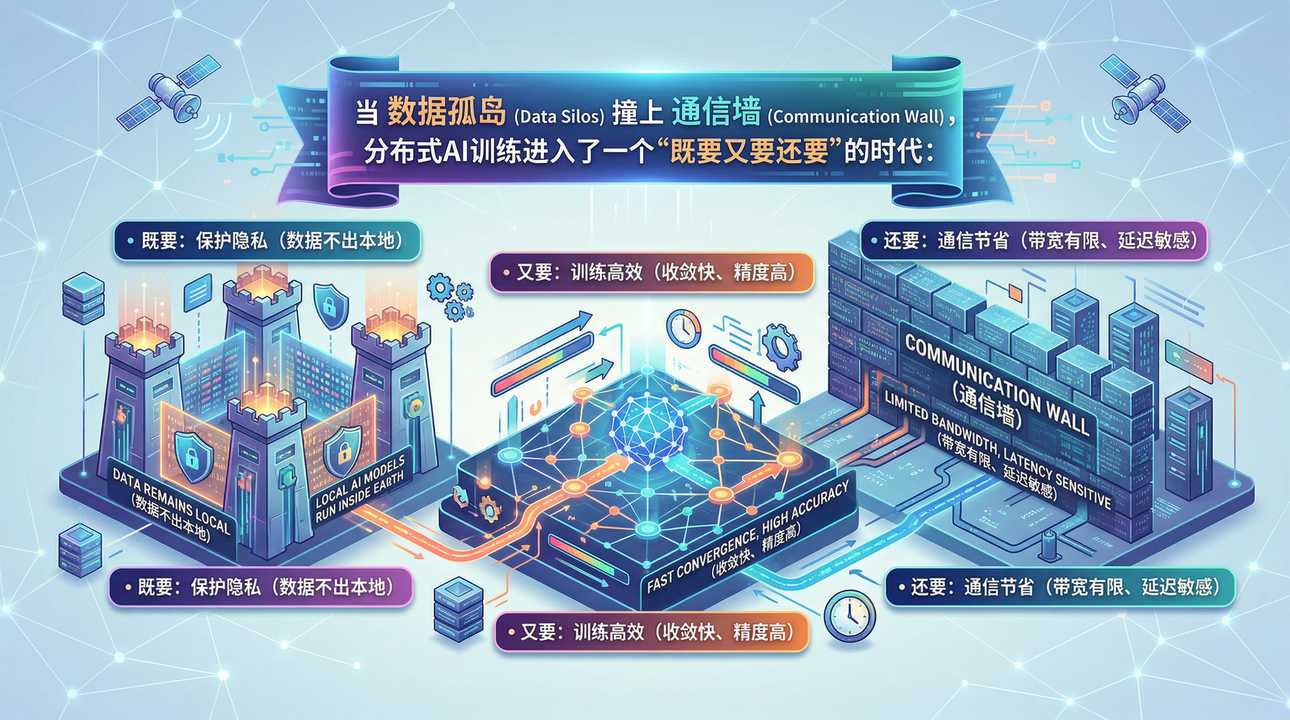
当数据孤岛(Data Silos)撞上通信墙(Communication Wall),分布式AI训练进入了一个”既要又要还要”的时代:
- 既要保护隐私(数据不出本地)
- 又要训练高效(收敛快、精度高)
- 还要通信节省(带宽有限、延迟敏感)
本文从算法本质、前沿技术、行业痛点三个维度,聊聊联邦学习与分布式优化的硬件配置逻辑。
二、算法本质:联邦学习的三重困境
1. 数据异质性:Non-IID的”噩梦”
联邦学习的经典假设是数据独立同分布(IID)——每个客户端的数据都来自同一个分布。但现实中:
- 医院A擅长心血管疾病,医院B擅长肿瘤诊断
- 银行C的用户是都市白领,银行D的用户是农村商户
- 手机E的用户爱刷短视频,手机F的用户只打电话
这种统计异质性(Statistical Heterogeneity)导致:
- 客户端漂移(Client Drift):每个客户端朝着本地最优更新,偏离全局方向
- 收敛震荡:全局模型在不同客户端的局部最优之间”摇摆”
- 精度下降:相比集中式训练,联邦学习的最终精度可能下降3%-7%
数学描述:xminf(x)=i=1∑mpifi(x)
其中 fi 是第 i 个客户端的局部目标函数,pi 是权重。问题出在 fi 之间差异太大。
2. 通信瓶颈:带宽是”硬通货”
在大模型时代,参数量动辄数十亿甚至千亿。每次通信轮次,客户端需要上传完整的模型梯度或参数更新。
通信量计算:
- GPT-3级别模型(175B参数):每个梯度约700GB(FP32)或350GB(FP16)
- 100个客户端参与:每次轮次需要传输35TB-70TB数据
- 在10Gbps网络下:这需要8-16小时——比本地计算还慢!
现实困境:
- 移动设备的WiFi不稳定
- 跨地域数据中心延迟高
- 边缘设备带宽受限
3. 系统异质性:设备”参差不齐”
联邦学习的客户端可能是:
- 高端服务器:8× A100,NVLink互联
- 普通PC:1× RTX 3060,千兆以太网
- 边缘设备:树莓派级CPU,4G网络
这种系统异质性导致:
- 掉队者问题(Stragglers):慢设备拖慢全局进度
- 计算通信不匹配:快设备计算完等慢设备上传
- 资源利用不均:算力强的设备无法充分发挥
三、前沿技术:破解分布式优化的三大武器
武器1:异质性自适应算法
针对Non-IID数据,研究者提出了一系列改进算法:
| 算法 | 核心机制 | 代表工作 |
|---|---|---|
| FedProx | 本地添加近邻正则项,限制偏离全局模型 | Li et al., 2020 |
| SCAFFOLD | 传输控制变量(方差缩减),纠正客户端漂移 | Karimireddy et al., 2020 |
| FedDyn | 动态正则化,自适应调整本地优化目标 | Acar et al., 2021 |
| MOON | 模型对比学习,对齐客户端特征空间 | Li et al., 2021 |
清华贡献:
- 户将团队:Riemannian Natural Gradient Methods(SIAM 2024),将自适应方法推广到流形优化
- AAAI 2025:Decentralized projected Riemannian stochastic recursive momentum method,在去中心化场景下实现自适应优化
武器2:梯度压缩与通信优化
梯度量化(Quantization):
- 1bit量化:只传输梯度符号,压缩率32×
- 2bit量化:符号+阈值,压缩率16×
- 误差补偿:累积压缩误差,在下一轮修正
梯度稀疏化(Sparsification):
- Top-K:只传输绝对值最大的K个梯度
- Rand-K:随机采样K个梯度
- 自适应稀疏度:根据网络状况动态调整K
SlimGC策略(2025年最新):
- 将压缩操作从GPU卸载到CPU,减少GPU资源竞争
- 使用模型备份技术,实现计算与通信重叠
- 在16 GPU集群上,将1bit压缩算法的训练吞吐量提升74.3%
武器3:隐私计算技术
差分隐私(Differential Privacy, DP):
- 在梯度中添加 calibrated noise(高斯噪声或拉普拉斯噪声)
- 隐私预算(Privacy Budget, ε)控制隐私强度
- 但噪声会降低模型精度,需要在隐私-效用间权衡
安全聚合(Secure Aggregation):
- 使用安全多方计算(MPC)加密梯度
- 服务器只能看到聚合结果,无法获取单个客户端梯度
- 清华齐涛团队:差分隐私知识迁移(Nature Communications 2023),将隐私风险降低99%
同态加密(Homomorphic Encryption):
- 允许在加密数据上直接计算
- 计算开销极高(比明文慢100-1000倍)
- 目前主要用于关键场景(如金融联合风控)
四、行业痛点:分布式训练的四大焦虑
痛点1:收敛速度与精度的”鱼和熊掌”
现象:
- 本地训练轮次(E)太多 → 客户端漂移严重 → 全局模型发散
- 本地训练轮次(E)太少 → 通信频率高 → 带宽爆炸
FedAvg的收敛界(非凸情形):E[∥∇f(x)∥2]≤优化误差ηTEf(x0)−f∗+随机梯度噪声mLησ2+客户端漂移客户端漂移L2η2(E−1)2
关键发现:客户端漂移项与 (E−1)2 成正比——本地训练越多,漂移越严重。
痛点2:掉队者拖慢全局进度
场景:100个客户端参与训练,其中10个是老旧手机。
- 服务器等待最慢的客户端上传梯度
- 其他90个客户端算力闲置
- 整体训练速度被拖累10倍以上
解决方案对比:
| 方案 | 优点 | 缺点 |
|---|---|---|
| 异步聚合 | 无需等待慢设备 | 梯度陈旧(staleness),收敛不稳定 |
| 客户端选择 | 只选快设备 | 数据代表性下降,模型偏差 |
| 分层聚合 | 按能力分组 | 实现复杂,需要动态分组 |
痛点3:隐私预算快速耗尽
差分隐私的 composability:每轮通信都会消耗隐私预算。
现实困境:
- 训练1000轮,每轮ε=0.01,总隐私预算ε=10(满足(10, 10⁻⁵)-DP)
- 但噪声标准差与 O(T) 成正比——训练越久,噪声越大
- 最终模型精度可能下降5%-15%
清华方案:齐涛团队的FedSampling(IJCAI 2023),通过优化采样策略,在相同隐私预算下提升收敛速度4倍。
痛点4:大模型的”通信墙”
GPT-3级别的模型,即使使用1bit量化,每次通信仍需传输约11GB数据。
计算:
- 100个客户端 × 11GB = 1.1TB/轮次
- 10Gbps网络下,需要15分钟传输
- 如果1000轮训练,仅通信就需要10天!
行业趋势:
- 梯度压缩:从1bit到0.5bit(符号+稀疏化)
- 本地聚合:多个轮次本地更新后再通信
- 模型分片:不同客户端训练不同层(垂直联邦学习)
五、硬件配置分级:从边缘设备到数据中心的四级跃迁
Level 1:边缘型——移动端与物联网设备
定位:参与联邦学习的客户端(如智能手机、边缘网关)
核心配置:
| 配件 | 推荐规格 | 说明 |
|---|---|---|
| CPU | ARM Cortex-A78 / Apple M系列 | 低功耗优先 |
| 内存 | 8-16GB LPDDR5 | 本地小模型训练 |
| 存储 | 128-256GB UFS 3.1 | 本地数据集存储 |
| 网络 | 5G/WiFi 6 | 上传梯度依赖 |
| NPU | 4-16 TOPS INT8 | 本地推理加速 |
避坑提示:
- 边缘设备主要做本地训练,不是训练大模型的主力
- 注意功耗限制,长时间训练可能触发温控降频
- 本地数据集通常很小(MB级),无需大存储
Level 2:节点型——中小企业与部门级服务器
定位:联邦学习参与方的主力训练节点(如医院科室、银行分行)
核心配置:
| 配件 | 推荐规格 | 说明 |
|---|---|---|
| CPU | AMD EPYC 9124 (16核32线程) | 数据预处理并行 |
| 内存 | 128GB DDR5-4800 ECC | 中等规模模型训练 |
| 显卡 | RTX 4090 24GB | 本地模型微调 |
| 存储 | 2TB NVMe SSD | 本地数据集+模型缓存 |
| 网络 | 10GbE 以太网 | 与中心服务器通信 |
避坑提示:
- 24GB显存可训练1-7B参数的模型(使用LoRA/QLoRA)
- 如果是Transformer模型,注意激活值内存占用
- 与中心服务器的带宽可能是瓶颈,考虑梯度压缩
Level 3:中心型——联邦学习协调服务器
定位:聚合全局模型、协调训练流程的中心节点(如联邦学习平台运营商)
核心配置:
| 配件 | 推荐规格 | 说明 |
|---|---|---|
| CPU | 双路 AMD EPYC 9655 (2×96核192线程) | 聚合大规模梯度 |
| 内存 | 1TB DDR5-4800 ECC REG | 加载全局模型+多客户端缓冲 |
| 显卡 | 4× RTX Pro 6000 Blackwell 96GB NVLink | 全局模型微调与评估 |
| 存储 | 8TB NVMe SSD (企业级) + 100TB HDD | 模型版本管理与日志 |
| 网络 | 25GbE/100GbE 以太网 | 同时连接数百客户端 |
| 加速卡 | 智能网卡 (DPU/IPU) | 加密/压缩卸载 |
避坑提示:
- 中心服务器需要同时维护数百个客户端的连接状态
- 聚合操作主要是内存带宽密集型,CPU缓存要大
- 考虑使用参数服务器(Parameter Server)架构分散负载
Level 4:集群型——跨地域数据中心
定位:国家级或行业级联邦学习平台(如医疗联邦学习联盟、金融风控联盟)
核心配置:
| 组件 | 配置要点 |
|---|---|
| 训练节点 | 8× H100 80GB NVLink全互联,支持千亿参数模型 |
| 参数服务器 | 32× 高内存节点(每节点2TB+),分片存储全局参数 |
| 存储集群 | 1PB+ Lustre/CEPH并行文件系统 |
| 网络架构 | 100GbE InfiniBand NDR,RDMA加速 |
| 安全模块 | FPGA加速的同态加密/差分隐私计算卡 |
| 软件栈 | PyTorch Distributed / DeepSpeed / FATE联邦学习框架 |
特殊考量:
- 跨地域延迟可能高达50-100ms,需要异步或半同步策略
- 安全计算开销巨大,可能需要专用硬件加速
- 考虑分层聚合:区域内先聚合,再跨区域聚合
六、避坑指南:分布式优化的五大陷阱
陷阱1:盲目追求本地训练轮次
误区:”本地训练越多,通信越少,效率越高”
现实:
- E(本地epoch)太大会导致客户端漂移
- 对于Non-IID数据,E>5时收敛可能发散
- 经验法则:从E=1开始,逐渐增加到E=3-5观察收敛
建议:
- 使用FedProx或SCAFFOLD缓解漂移
- 动态调整E:收敛初期小E,后期大E
陷阱2:忽视梯度压缩的精度损失
误区:”1bit量化压缩32倍,肯定比8bit好”
现实:
- 1bit量化引入的误差可能需要更多轮次补偿
- 对于某些任务(如NLP),高频小梯度也很重要
- SlimGC发现:对小梯度直接传输(不压缩)可能比强制压缩更快更准
建议:
- 使用自适应压缩:大梯度压缩,小梯度原样传输
- 配合误差补偿机制(error feedback)
陷阱3:隐私预算规划失误
误区:”每轮ε=0.01很小,总预算没问题”
现实:
- 1000轮后,总预算ε=10,隐私保护已经很弱
- 噪声标准差随轮次累积,后期模型被”淹死”
- 某些攻击(如成员推断)在ε>1时仍然有效
建议:
- 使用隐私会计(Privacy Accounting)工具跟踪预算
- 考虑Rényi差分隐私(RDP)进行 tighter analysis
- 关键模型用ε<1,一般模型可适当放宽
陷阱4:掉队者处理不当
误区:”所有客户端必须每轮都参与”
现实:
- 等待掉队者会拖累90%的快设备
- 异步更新可能导致模型发散
建议:
- 设置超时机制(timeout),超过时间即忽略
- 使用分层联邦学习(Hierarchical FL):本地聚合+全局聚合
- 掉队者的数据可以通过知识蒸馏迁移到全局模型
陷阱5:网络拓扑设计失误
误区:”所有客户端直连中心服务器最简单”
现实:
- 中心服务器是单点瓶颈和故障点
- 跨地域通信成本高
建议:
- 去中心化拓扑:Ring/Grid/Random图结构,邻居间通信
- 分层拓扑:区域内星型,区域间全连接
- 清华户将团队的研究表明:去中心化Riemannian优化在异质数据下可实现线性加速
七、写在最后:分布式AI的未来图景
联邦学习与分布式优化正在从”能用”走向”好用”。
短期趋势(1-2年):
- 梯度压缩从1bit走向0.5bit(符号+稀疏化)
- 异质性自适应算法成为标配(类似Adam在优化中的地位)
- 隐私计算硬件加速(如Intel TDX、AMD SEV-SNP)
中期趋势(3-5年):
- 完全去中心化:无需中央服务器,纯P2P拓扑(类似区块链)
- 个性化联邦学习:每个客户端拥有独特的本地头部网络
- 跨模态联邦学习:图像、文本、语音在不同机构间的联合训练
长期愿景:
- 全球联邦学习网络:跨国家、跨机构的AI协作训练
- 数据确权与激励:基于区块链的数据贡献计量与收益分配
- 可信AI生态:隐私保护+可解释性+公平性的三位一体
正如清华智能产业研究院刘洋(《联邦学习》主要作者)所言:
“联邦学习的终极目标不是技术本身,而是构建一个数据可用不可见、价值可算不可偷的AI协作生态。”
硬件投资的原则:
- 边缘轻量:客户端设备重推理轻训练,NPU比GPU更合适
- 中心重聚合:中心服务器重内存带宽,CPU缓存比核心数更重要
- 网络优先:带宽是分布式训练的硬约束,投资网络比投资算力ROI更高
- 安全前置:隐私计算不是”可选功能”,而是从一开始就要设计的架构要素
当数据孤岛成为常态,分布式优化能力将成为AI infra的核心竞争力。不是每个机构都能建超算中心,但每个机构都可以成为联邦学习网络中的一个节点——这才是AI民主化的真正含义。
文章关键词:联邦学习、分布式优化、数据异质性、梯度压缩、差分隐私、通信墙、数据孤岛、FedAvg、FedProx、SCAFFOLD、去中心化优化、隐私计算、清华户将、齐涛、刘洋
相关阅读推荐:
- McMahan et al., AISTATS 2017, Communication-Efficient Learning of Deep Networks from Decentralized Data
- Li et al., ICML 2020, Federated Optimization in Heterogeneous Networks
- Karimireddy et al., ICML 2020, SCAFFOLD: Stochastic Controlled Averaging for Federated Learning
- 齐涛 et al., Nature Communications 2023, Differentially private knowledge transfer for federated learning
- 户将 et al., SIAM 2024, Riemannian Natural Gradient Methods












