
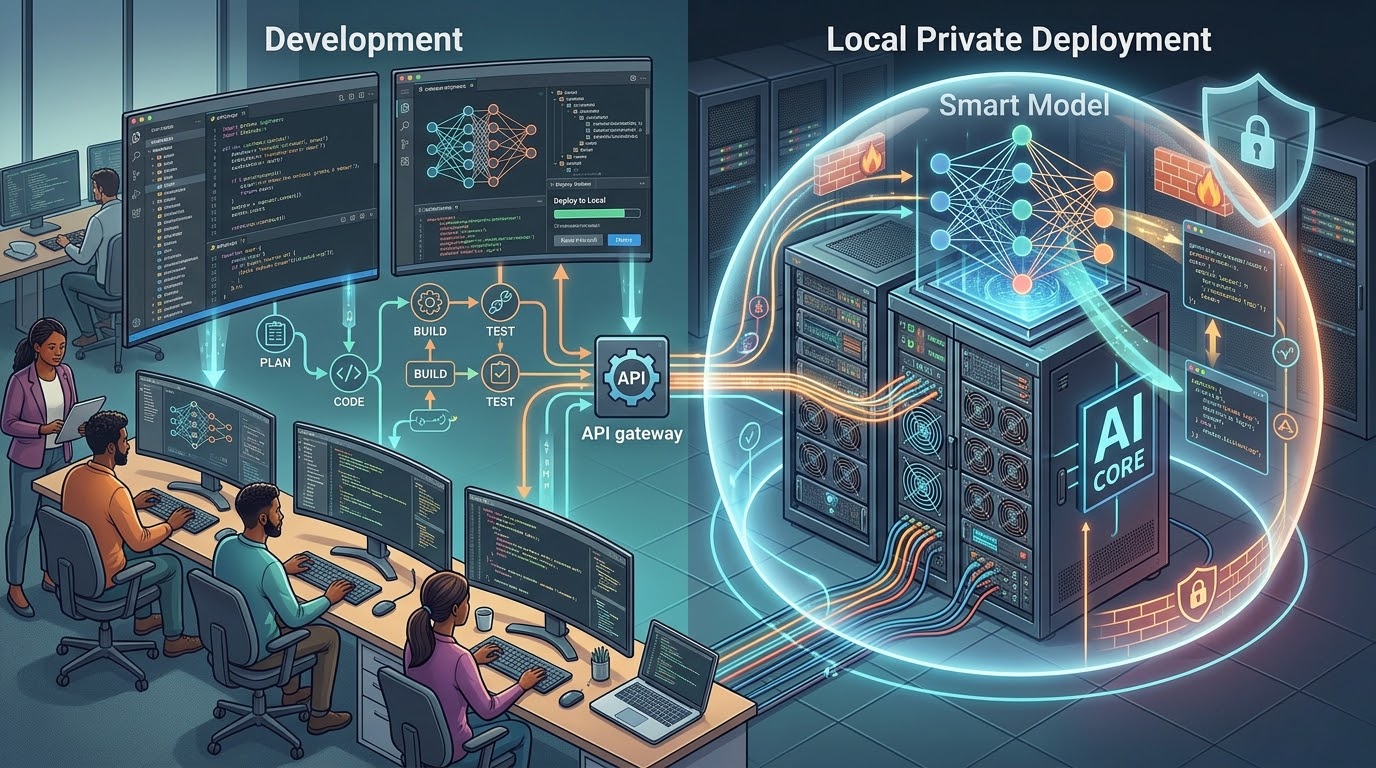
一、起点:研一那年,一台笔记本和一段”会写代码的代码”
2024年秋天,小陈保研进了软件工程方向。开学第一周,导师没让他读论文,而是丢给他一句话:先去搞明白,现在这些能帮人写代码的AI助手,到底是怎么跑起来的。
那段时间正是AI编程工具最火的时候。周围的同门写代码,起手式已经变成”先让AI生成个初版,再人工改”。小陈一开始也是云端工具的忠实用户,直到他试图在自己的游戏本上复现这一切——模型装好了,推理一启动,风扇狂转,每秒钟只能蹦出几个token。他第一次直观感受到:云端那些行云流水的补全背后,是本地硬件完全够不着的算力。
他把兴趣做成了调研,结果发现这个领域远没有想象中成熟。南京航空航天大学等单位的研究团队2023年在Empirical Software Engineering上发表过一项名为TurduckenGen的工作,专门处理代码生成里一类很隐蔽的麻烦:生成模型写出来的代码常常过不了语法约束这一关,尤其是Turducken风格的代码——声明式片段嵌在命令式程序里,比如Java程序中嵌入一段SQL查询。他们的思路是给代码token附加类型信息、把语法约束学习作为辅助任务,再用编译器反馈从候选结果里筛出真正能跑的那一份。这项工作在两个公开数据集上超过了六个当时的主流基线,人工评估里生成代码的可读性和语义相似度也都更好。
这个发现让小陈意识到:智能软件开发这个方向,看起来是软件问题,落到研究层面,全是算力问题。生成、筛选、验证,每一步背后都是模型在跑,而模型每跑一步都要吃显存、吃带宽。
二、第一次扩容:硕士中期,代码不能上云的那一刻
硕士中期,小陈的课题正式定为代码生成质量的自动评估。真正的转折发生在课题开展的第三个月:合作企业送来一批未公开的项目代码做实验素材,协议里白纸黑字写着——数据不得离开课题组控制的机器。
云端AI助手这条路,从那一刻起被关上了。本地私有化部署从”兴趣爱好”变成了”课题刚需”。
他翻出之前记在备忘录里的估算公式:所需显存约等于参数量(以B为单位)乘以量化字节数,再乘1.2的预留系数。这个1.2是给KV cache和系统开销留的余量,上下文越长、并发越高,系数还得往上涨。以他当时想跑的14B级模型为例,FP16精度下要占约34GB显存,换成Q4量化,14乘0.5乘1.2,只要8.4GB左右,模型本体加缓存控制在9GB上下。
他的游戏本只有8GB显存。连Q4量化的入门档都装不下。
也是在这个阶段,他把量化三档彻底弄明白了。FP16是每个参数2字节,精度无损但体积翻倍;Q8折半到1字节,精度损失通常不到1%,几乎无感;Q4再减半到0.5字节,损失开始可感知,但对代码补全、注释生成这类任务完全够用,所以成了消费级显卡的默认选择。说白了一句话:量化省的是显存,换的是一点点精度,对软件开发场景来说,这笔买卖划算。
课题催得紧,他等不起慢慢攒机,向导师申请了课题经费里第一笔设备支出。这台机器要干的事情很具体:本地跑14B级模型的Q4推理,承担日常补全、评审、测试用例生成,同时保住那批不能上云的代码。
三、第二次扩容:博士开题,安全关键软件遇上大模型
博士开题,小陈把方向扎进了安全关键软件——航电、飞控这类”出一个错就是事故”的领域。这个选择把他对算力的需求又往上推了一档。
这个方向不是他凭空想出来的。南京航空航天大学计算机学院的杨志斌教授团队近几年一直在做这件事:把大语言模型引进安全关键软件的开发流程。从自然语言需求到形式化规约的转换、AADL架构建模、FMEA故障模式影响分析,再到Rust代码的漏洞检测,团队2025年以来密集公开了一批发明专利,其中就包括基于LoRA微调的综合化航电系统需求分析方法。用模型的力量去辅助”需求—架构—验证”这条传统上纯人工的链路,正在成为安全关键软件研究的一条明线。
但安全关键三个字意味着完全不同的质量标准。常规代码补全,14B模型生成个七七八八,人再改改就能用;可一旦涉及需求歧义消解、形式化规约转换这类长链路推理,小模型的幻觉会成倍放大。他开始评估Llama-3.3-70B这个量级的模型:700亿参数,Q4量化后按公式算,70乘0.5乘1.2约42GB,落在39到43GB这个区间,FP16更是直奔168GB。单张消费级显卡已经装不下了。
更现实的问题是领域适配。航空术语、AADL规约、FMEA条目这些语料,公开数据里几乎找不到,课题组只能自己积累。直接全参数微调不现实——7B模型全参数微调就要80GB以上显存——LoRA这种轻量化微调成了唯一可行的路:冻结主干,只训练低秩适配层,对14B模型做LoRA,在推理底座上只要再增加3到5GB显存。
他博士前两年的核心工作,就是把这套”本地大模型加领域LoRA”的验证流程搭起来。
四、第三次扩容:课题组平台,从一个人到一群人
流程跑通之后,麻烦变了性质。师弟师妹加入,组里人人都想用这台机器跑推理;企业合作的评测任务一批接一批,模型本体、LoRA权重、代码语料、评测结果堆满了盘;最忙的时候,提交一个评测任务要排队三天。
个人工作台的模式到此为止。课题组需要一台真正意义上的共享算力平台:多任务并发推理、评测流水线常驻、权重和语料集中管理、谁提交谁排队有日志可查。这时候硬件需求的重心也悄悄变了——从”单卡能跑多大的模型”变成”整机能同时喂饱几个任务”。解码速度由显存带宽决定,并发能力由显存总量决定,而语料的加载和checkpoint的读写,开始反复考验存储IO。
小陈回头看这三年,自己的算力需求跳了三次档,没有一次是线性增长,全是断崖式的跳变。
五、本地私有化部署的硬账:显存、速度与微调
聊到这,有必要把本地私有化部署这笔硬账算清楚,这也是选机器前必须建立的坐标系。
先说为什么非要本地。对软件工程方向,理由很实际:一是数据主权,未公开的科研代码、企业合作代码、涉密项目代码,任何离开本机的传输都是风险;二是长期成本,课题组按年付的云端API费用,折算过来常常够买一块高端显卡;三是离线可用,航展、外场、企业内网这些断网环境,云端助手全部失效。
再说选型。软件开发场景目前比较务实的两个锚点:微软Phi-4(14B),140亿参数,补全、评审、单测生成的主力;Llama-3.3-70B,700亿参数,负责需求分析、规约转换这类高难度推理。两者搭配,覆盖从日常编码到课题攻坚的全谱系。
显存估算沿用前面的公式:所需显存约等于参数量乘以量化字节数乘以1.2。
| 模型 | FP16 | Q8 | Q4 | Q4舒适档 |
|---|---|---|---|---|
| Phi-4(14B) | 约34 GB | 约17 GB | 约9 GB | 12~16 GB显存 |
| Llama-3.3-70B | 约168 GB | 约84 GB | 约39~43 GB | 48 GB以上或双卡 |
速度的差距同样要心里有数。CPU纯内存推理通常只有个位数tokens/s,写一段百行的函数要等几分钟,只能当玩具;单卡GPU能拉到几十到上百tokens/s,才谈得上日常可用。同显存容量下,带宽更高的卡解码更快,这是区分显卡推理档位的重要参数,也是”能跑”和”好用”之间的分水岭。
最后区分推理和微调。LoRA微调对14B模型的显存增量约3到5GB,消费级高端卡加少量投入就能承担;全参数微调完全是另一个物种,7B模型就要80GB以上。配置机器前先想清楚自己要做什么:只做推理,预算可以压得很低;要做LoRA,显存得留出余量;想全参数微调,那已经从工作站话题滑向小型集群话题了。
六、回头看:那些当时没人告诉他的事
第一,起步别把预算一次花完。小陈研一就动过”一步到位”的念头,现在庆幸当时没买——三年里需求跳了三次档,任何”顶配”在两年后都会变成”刚好够用”。
第二,显存容量和显存带宽是两回事。能装下模型只代表能开机跑起来,解码快不快全看带宽。买卡时只看容量数字,是最常见的误判。
第三,微调不是万能药。LoRA解决的是格式和术语的适配,解决不了数据质量。语料脏,微调出来的模型只会更脏。
第四,存储IO是最容易被低估的瓶颈。语料加载、权重切换、checkpoint读写,机械硬盘能把一次几分钟的实验拖到半小时。
七、配置参考
聊了这么多技术细节,最后还是要回答最实际的问题:一个软件工程课题组,给智能软件开发配机器,到底该怎么配?高校买设备和自家装机完全是两码事,要走采购流程、过资产验收,还得考虑能不能撑过两届学生的毕业周期。结合前面分析的显存需求、速度量级和微调门槛,下面按任务规模分四档,你可以按自己所在的阶段对号入座。
方案A:个人起步档
适用场景:研究生个人使用,本地跑14B级模型Q4量化推理,承担代码补全、评审、测试用例生成,适合刚入门智能软件开发方向、以学习和轻量课题为主的阶段。
价格区间:4~7万
推荐机型:A350 15364-MBT
- CPU:Intel Core Ultra 7 265K 20核(8性能核全核5.3GHz/12能效核全核3.8GHz)(5.3GHz为全核超频实测优化频率)
- GPU:RTX 5090D v2 24G 水冷
- 内存:64GB DDR5
- 存储:2TB NVMe
- 显存带宽:1.34 TB/s
方案B:课题攻坚档
适用场景:硕士中后期到博士初期,需要更从容地运行14B级模型FP16或Q8精度,并兼顾小规模LoRA微调与代码评测流水线,适合课题进入实质攻坚阶段、开始积累领域语料的用户。
价格区间:10~18万
推荐机型:AE450 145128-MC2T
- CPU:AMD锐龙Pro 7970X 32核4.5G(4.5GHz为全核超频实测优化频率)
- GPU:双RTX 4090 48G 水冷(48GB为第三方定制版,非NVIDIA官方规格)
- 内存:128GB DDR5
- 存储:4TB NVMe
- 显存带宽:2×1.01 TB/s
方案C:模型微调与验证档
适用场景:面向70B级模型Q4推理与系统性LoRA领域适配,承担需求分析、规约转换等高难度推理任务,适合安全关键软件、形式化验证这类对生成质量要求苛刻的研究方向。
价格区间:20~40万
推荐机型:AX430 127384-MC2E
- CPU:Xeon金牌6530 32核2.7-4G(2.7GHz为全核超频实测优化频率)
- GPU:2×RTX 6000D 84G
- 内存:384GB DDR5
- 存储:4TB NVMe
- 显存带宽:2×1.57 TB/s
方案D:课题组共享平台档
适用场景:多人并发推理、评测流水线常驻、权重与语料集中管理,满足整个课题组在智能软件开发方向上的共享算力需求,适合人员较多、项目密集的实验室。
价格区间:50~80万
推荐机型:GX660M 227640-MD4E
- CPU:2×Xeon金牌6530 64核2.7-4G(2.7GHz为全核超频实测优化频率)
- GPU:4×RTX Pro 6000 96G
- 内存:640GB DDR5
- 存储:8TB NVMe
- 显存带宽:4×1.79 TB/s
八、常见问题
云端API那么方便,为什么非要本地私有化部署?
对公开代码的通用补全,云端API确实够用。但课题组手里真正值钱的代码往往不能离开本机——未公开的科研成果、企业合作数据、有保密要求的项目。本地部署买的是数据主权和断网可用,这两样云端给不了。
本地14B模型写代码,水平到底够不够?
日常补全、注释、单测生成,14B级模型Q4量化后完全可用,配合好的提示词能顶半个助手。短板在跨文件的长链路推理和复杂需求理解,这类任务该交给70B级模型,或者干脆人工兜底。
已经有服务器了,为什么还要工作站?
两者不矛盾。服务器适合常驻服务和批量任务,工作站的价值在工位级的交互体验:低延迟调试、可视化操作、随开随用。对学生来说,一台触手可及的工作站,使用频率远高于排队申请的服务器账号。
LoRA微调是不是小显存也能做?
能做,但别指望太省。LoRA的增量确实小,14B模型只增加3到5GB显存,但底座推理的显存一份都省不掉。24GB显存可以做14B的LoRA,70B的LoRA就得48GB以上再往上走了。
跑代码大模型,为什么显存够还是会卡?
先查带宽,再查存储。解码速度由显存带宽决定,容量够而带宽低的卡,跑起来就是慢。另外语料和权重如果存在机械盘上,加载和切换的等待会直接吃掉体感速度。
安全关键软件方向用大模型,有什么特别要注意的?
把模型输出当建议,把形式化验证当裁判。大模型可以帮忙生成规约草稿、测试用例和故障树初稿,但任何进入安全关键流程的产物,都必须过形式化工具的验证。人的签字负责,机器只做辅助。
结语
智能软件开发这三年走下来,小陈最深的体会是:这个方向的算力需求,从不按年度匀速增长,它跟着课题难度跳变。今天觉得够用的配置,两年后可能就是整个实验室的瓶颈。配机器这件事,本质上是在给未来的自己买保险——保额多少,取决于你敢不敢赌课题永远停在原地。











