
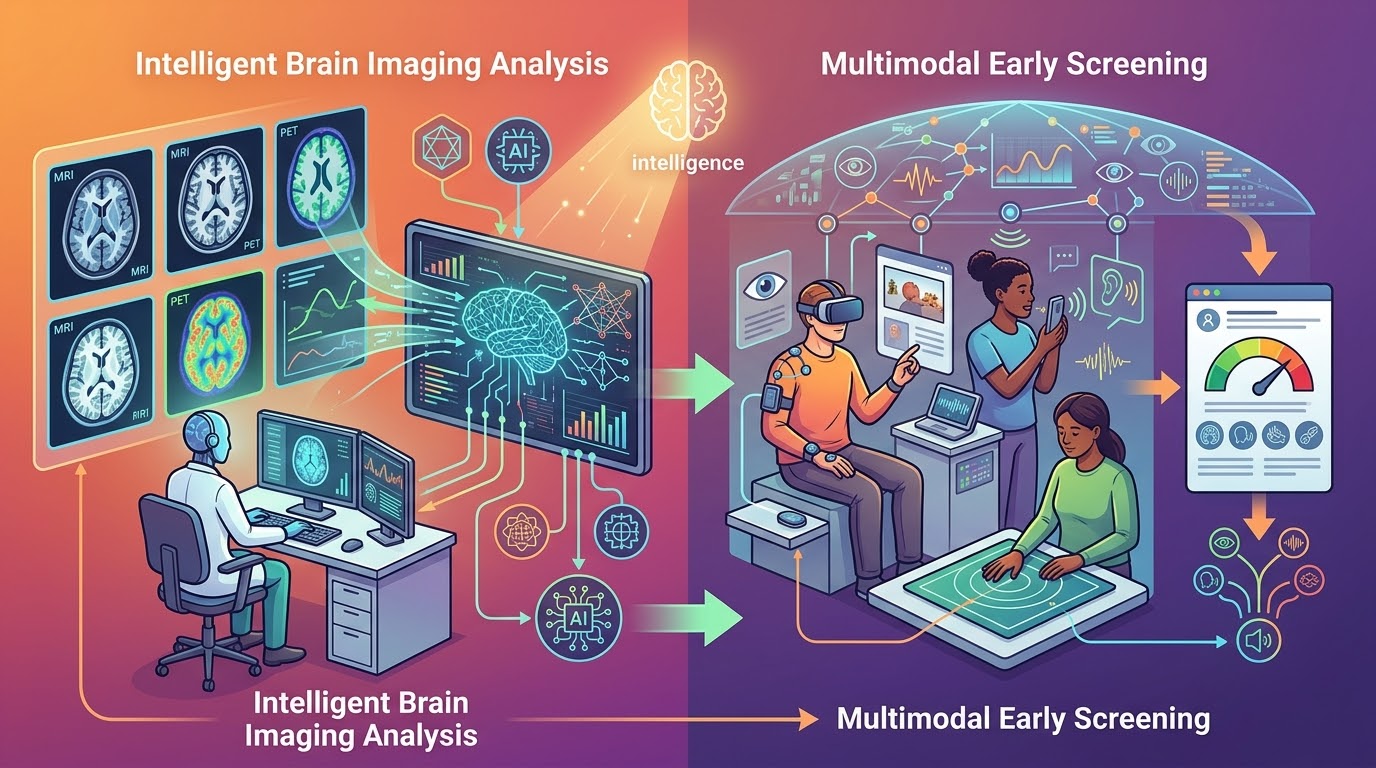
一、缘起:当阿尔茨海默病早筛撞上算力天花板
2026年初,科技日报在报道江苏”人工智能+”产业布局时提到一个细节:南京航空航天大学张道强教授团队将多模态脑影像进行整合,用人工智能技术判断患者脑影像与基因的关系,帮助医生辨别哪些基因改变会影响脑功能及脑结构,相关技术已获教育部自然科学奖二等奖。
这个团队的公开学术报告《智能影像基因组学与疾病诊断应用》列出过一张完整的技术清单:医学影像(MRI/CT)快速重建、多图谱医学影像分割、脑网络分析、多模态医学图像融合分类、影像-基因关联分析,应用病种覆盖阿尔茨海默病、精神分裂症、肺癌与乳腺癌。张道强在历年的学术报告中反复强调过一个临床事实:阿尔茨海默病的最佳干预窗口在出现症状之前的潜伏期与轻度认知功能障碍阶段,患者一旦进入痴呆阶段,现有的治疗手段基本无力回天。”早发现”三个字,把整套脑影像智能分析流程推到了临床转化的门口。
我们接触过的一个医工联合课题组,2025年接到的正是这类任务:联合医院影像科,基于结构与功能磁共振构建轻度认知障碍的辅助筛查模型,样本规模约两千例。组里的算力家底是一台五年前的台式机加一张旧消费级显卡。项目跑了一年,他们总结出一条规律:医学影像AI的算力瓶颈,往往出现在你想象不到的环节。下面按项目推进的四个节点,把这笔算力账算清楚。
二、节点一:数据整理与影像预处理–最容易被低估的环节
医学影像数据进来,第一个环节是清洗,训练模型还排在后头。原始DICOM序列要转成NIfTI格式,然后依次做颅骨剥离、空间配准、强度非均匀性校正、时间层校正。每一步单看都不算难,但每一步都要把整幅三维体素扫一遍。以1毫米各向同性的T1结构像为例,单例数据的预处理流水线跑完,顺利半小时,遇上质量差的数据一两个小时也常见。两千例数据,光是预处理就要吃掉一台普通电脑数周的连续机时。
这个阶段的负载特征很鲜明:CPU密集,且吃内存带宽。配准算法要在两幅图像之间反复搜索最优空间变换,图谱映射要把每个体素对号入脑区,全是浮点搬运活,显卡帮不上太多忙。课题组最初那台旧机器,卡就卡在预处理排队上–全组只有一个人能跑数据,其他人干等。
对应到硬件思路,这一阶段的钱应该花在CPU多核性能、内存容量和一块足够快的系统盘上,图形计算反而可以先放一放。这也是医学影像课题与很多人直觉相反的地方:模型还没开始训练,机器已经在喊累了。
三、节点二:脑网络构建–矩阵游戏的内存胃口
功能磁共振(fMRI)数据预处理完之后,课题组进入脑连接组学环节:按脑图谱(例如AAL图谱的116个脑区)把全脑切成功能单元,计算每对脑区之间血氧信号的时间相关系数,拼成一幅116乘116的功能连接矩阵。一个被试一幅矩阵,两千例就是两千幅对称矩阵。接下来还要在这些矩阵上提取图论特征、设计图核方法做分类–特征维度动辄数千,相对特征数而言样本量仍显不足,典型的小样本高维问题。
这一步的硬件主角换成了内存。矩阵运算本身不复杂,但批量加载、批量运算时,内存容量和带宽决定了脚本能不能一口气跑完。课题组在这里翻过车:一台内存偏小的机器跑批处理,半夜触发交换分区,速度直接跌两个数量级,一个该天亮出结果的任务跑了三天。
内存之外,存储也开始见底。结构像、功能像、弥散像各一份原始数据,预处理中间结果再翻一两倍,两千例的完整数据目录轻松占到数TB,而且这类数据只进不出–医院会不断补充随访数据。项目做到中期,存储扩容几乎是从零开始就要预留的科目。
四、节点三:多模态融合模型训练–显存与算力的正面战场
筛查模型进入正式建模阶段,课题的技术含量也拉满了:结构磁共振提供皮层厚度与灰质体积,功能磁共振提供脑区连接模式,弥散张量成像提供白质纤维走向,如果再做影像-基因关联分析,还要并入基因型数据。把这些模态融合进同一个预测框架,是近年医学影像AI的主流路线,也是前述南航团队获教育部自然科学奖二等奖成果的核心方向。
多模态融合意味着模型训练的成本成倍上涨。三维卷积网络处理整幅脑影像,一个批量(batch)塞进显存的数据量就是二维图像任务的好几个量级;再加上小样本场景必须做的重复交叉验证–同一套流程以不同数据划分重复训练成百上千次–显存和算力被同时架在火上烤。
课题组那24GB显存的旧卡在这个阶段被分配了新任务:跑小批量、裁剪体素、降分辨率,能凑活,但每个实验周期从几天拉长到一两周。更隐蔽的代价是探索半径被压缩了:本来可以同时试三种网络结构和五组超参,现在只能串行排队,哪组先出结果就先用哪组,科研上这是用妥协换时间。参数扫描一旦铺开,单张消费级显卡的显存就成了天花板,训练排队直接决定论文进度。
五、节点四:结果分析与可解释性–迭代阶段的双重消耗
模型有了初版结果,审稿人的问题随之而来:模型到底看懂了什么?医学影像AI论文越来越要求可解释性分析–显著性映射、梯度加权类激活图,逐一回溯模型关注脑区的可视化证据。生成这类图需要把数据重新前向传播几百上千次,单次消耗不大,架不住次数多。
更耗的是迭代。筛查模型要按年龄、性别、扫描设备分层验证,多中心数据还要做跨站点泛化测试,每一轮修改都意味着数据重新预处理、模型重新训练、结果重新统计。课题组算过一笔账:从初版模型到投稿版本,全流程完整跑了十一轮,其中六轮的瓶颈在训练,三轮的瓶颈在预处理,剩下两轮卡在存储读写。所谓迭代效率,就是各个环节里最短的那块板。
六、大模型内网离线部署:把文献助手和报告助手留在课题组
医学影像AI课题组有个耗时黑洞:文献。PubMed每年新增的“阿尔茨海默病+磁共振”论文数以百计,开题、中期、投稿都要重筛;报告初稿、记录问答、代码排错一样不产创新性,却实打实消耗研究生整块时间。一台内网离线的大模型服务,是课题组最划算的一笔投入。
为什么强调内网离线?患者影像与病历受伦理隐私约束,脱敏后原则不出院不出校,公有云API天然被排除;合作医院节点在院内内网,本地离线模型才能接入真实流程;按累积文献与报告量折算,三五年API账单常超过一台工作站本金。
选型上,Gemma-3-27B覆盖大部分图文场景:谷歌开源270亿参数多模态模型,能读影像截图与文字,128K上下文吞长文献,筛读、问答、报告初稿都够用;更强逻辑推演交给DeepSeek-R1,671B总参数MoE架构。
显存估算一条公式:
所需显存 ≈ 参数量(B) × 量化字节数 × 1.2
FP16、Q8、Q4每参数分别2、1、0.5字节;1.2为KV cache与系统开销系数。代入两个模型:
| 模型 | FP16 | Q8 | Q4 |
|---|---|---|---|
| Gemma-3-27B | 约65 GB | 约32 GB | 约16 GB |
| DeepSeek-R1(MoE,按总参数量计) | 约1610 GB | 约805 GB | 约400 GB |
量化怎么选?FP16满血无损但显存翻倍;Q8损失微乎其微、显存减半;Q4精度有可见下降,但问答、报告草稿够用,显存仅为FP16的四分之一。DeepSeek-R1是MoE:显存按总参数671B计而非每步激活的37B,省算力不省显存。
速度量级:CPU纯内存推理每秒个位数token,基本不可用;单张GPU跑Q4量化Gemma-3-27B,解码每秒几十到上百token,远超阅读速度。
微调与推理的分野:LoRA适配Gemma-3-27B做领域训练,显存增量约4~6 GB,流畅Q4推理的24GB机器顺带完成;全参数微调27B是另一个量级,权重、梯度、优化器状态全驻显存约430 GB,多卡专业平台才玩得起。R1全参数微调是预训练实验室的事,LoRA也得先装进约400 GB的Q4权重。
七、软件工具链:医学影像的开源家底
这个方向的好处是开源生态极成熟,预算紧张也能起步。预处理与配准有FSL、SPM、ANTs;皮层重建与形态学分析用FreeSurfer;弥散数据处理用MRtrix3;深度学习侧,MONAI和nnU-Net几乎成了医学影像分割任务的标准框架,配合SimpleITK做图像读写,Nipype把整条流水线串成可复用的工作流。这些工具大多以CPU负载为主,唯独深度学习框架挑显卡、挑显存。软件清单本身不花钱,但它们对硬件的胃口,就是前面四个节点里逐层加码的那张账单。
八、配置参考:四档方案对应四种课题规模
从算法原理到代码实现,中间隔的是编程能力;从代码实现到实际跑出结果,中间隔的往往就是硬件。医学影像AI课题组最容易犯的错,是在预处理阶段舍不得投入、在训练阶段又省错了地方。结合前面四个节点暴露出的瓶颈–CPU密集的前期流水线、吃内存的脑网络矩阵、烧显存的深度学习训练,再加一台要常驻运行的本地大模型服务–我们把几种典型任务规模对应的配置思路整理成四档,供你在写采购申请之前对照。
方案A:影像组学与小样本机器学习入门
适用场景:几百例规模的回顾性研究,以数据预处理、影像组学特征提取和传统机器学习建模为主,偶发小规模深度学习实验;适合课题组第一台共享设备。
价格区间:4~7万
- 推荐机型:A350 156128-MCX
- CPU:Intel Ultra9 285K (24核, 8P核5.6GHz) +水冷(5.6GHz为全核超频实测优化频率)
- GPU:RTX 5070Ti 16GB
- 内存:128GB DDR5
- 系统盘:4TB NVME
- 数据盘:8TB SATA
- 显存带宽:896.0 GB/s
方案B:深度学习分割与分类常规训练
适用场景:数千例数据,三维卷积网络分割或分类模型的常规训练,nnU-Net级别的网络结构,交叉验证与参数扫描能控制在一两天内出结果。
价格区间:10~18万
- 推荐机型:AE450 145128-MC2T
- CPU:AMD锐龙Pro 7970X 32核4.5G(4.5GHz为全核超频实测优化频率)
- GPU:双RTX 4090 48G 水冷(48GB为第三方定制版,非NVIDIA官方规格)
- 内存:128GB DDR5
- 存储:4TB NVMe
- 显存带宽:双1.01 TB/s
方案C:多模态融合与本地大模型服务
适用场景:结构、功能、弥散多模态数据联合建模,同时内网离线部署Gemma-3-27B级别的本地大模型承担文献挖掘与报告辅助,并为LoRA领域微调预留显存余量。
价格区间:20~40万
- 推荐机型:AX430 127384-MC2E
- CPU:Xeon金牌6530 32核2.7-4G(2.7GHz为全核超频实测优化频率)
- GPU:2×RTX 6000D 84G
- 内存:384GB DDR5
- 存储:4TB NVMe
- 显存带宽:2×1.57 TB/s
方案D:多中心研究与全组共享平台
适用场景:多中心、上万例数据的影像-基因关联分析,全组共享的高并发训练与推理平台,兼顾DeepSeek-R1级别大模型借助内存卸载方案的本地运行试验。
价格区间:50~80万
- 推荐机型:GX660M 227640-MD4E
- CPU:2×Xeon金牌6530 64核2.7-4G(2.7GHz为全核超频实测优化频率)
- GPU:4×RTX Pro 6000 96G
- 内存:640GB DDR5
- 存储:8TB NVMe
- 显存带宽:4×1.79 TB/s
九、如果重来一次:课题组复盘出的四条教训
第一条,先算存储再谈算力。医学影像数据只进不出,随访数据年年追加,项目中期再买存储比一开始就规划好贵得多,还牵涉数据迁移的折腾。
第二条,预处理阶段的内存按峰值规划。配准和批处理触发的交换分区能让速度跌两个数量级,按平均占用配内存是新手最容易犯的错。
第三条,多模态别一步到位。先跑通单模态基线拿到可发表的结果,再逐步并入新模态,每一步都验证增益,比一上来堆满全部模态省出一台机器的钱。
第四条,大模型按舒适档配显存。别按理论最小值规划,上下文一长、并发一高,KV cache会把余量吃得干干净净,留足呼吸空间才有实用性。
十、常见问题
影像组学入门,第一台设备该侧重什么?
侧重CPU多核性能、内存容量和系统盘速度。入门阶段的主战场是预处理流水线,影像组学特征提取和传统机器学习对显卡要求不高,把预算倾斜到数据吞吐上,比先买一张高端显卡实在得多。
内存和显存,哪个先成为瓶颈?
看阶段。数据整理、脑网络构建和统计分析阶段,内存与内存带宽先见底;进入深度学习训练后,显存成为硬约束。两个都要按峰值规划,交换分区和显存溢出都是”跌两个数量级”级别的故障。
消费级显卡能不能用于科研训练?
能起步,但会很快触顶。小批量、裁剪体素的实验可以跑,代价是探索半径被压缩、实验周期拉长。一旦涉及三维网络、多模态融合或大规模参数扫描,显存天花板就会反过来决定你能做什么。
医学数据不出院,本地大模型怎么落地?
选开源模型内网离线部署。Gemma-3-27B做文献筛读、报告初稿和记录问答,Q4量化后单张显卡即可运行;更强的推理任务交给DeepSeek-R1级别的模型,或用内存卸载方案在本地试验。数据全程不出内网,伦理审批也顺。
一台机器多人共用,怎么避免互相拖慢?
按负载错峰调度,预处理和大模型推理安排在空闲时段,训练任务设资源上限;存储目录做统一规范,避免重复拷贝吃掉磁盘。如果排队成为常态,说明该考虑第二台设备或向上一档方案升级了。
笔记本能承担到什么程度?
轻度的文献管理、代码开发和小规模影像组学分析可以胜任,但预处理流水线、深度学习训练和本地大模型服务都超出笔记本的散热与显存极限。笔记本适合做终端,不适合做计算主力。
结语
回到开头那两千例轻度认知障碍筛查模型。课题收尾时,课题组算过一笔总账:十一轮迭代里,六轮卡在训练、三轮卡在预处理、两轮卡在存储。医学影像AI的竞争,表面上是算法和数据的竞争,底层是一台机器能不能让每个环节都跑得动。脑影像智能分析已经站上临床转化的门槛,而支撑这一切的,是一台被精心配平的算力工作站。











