
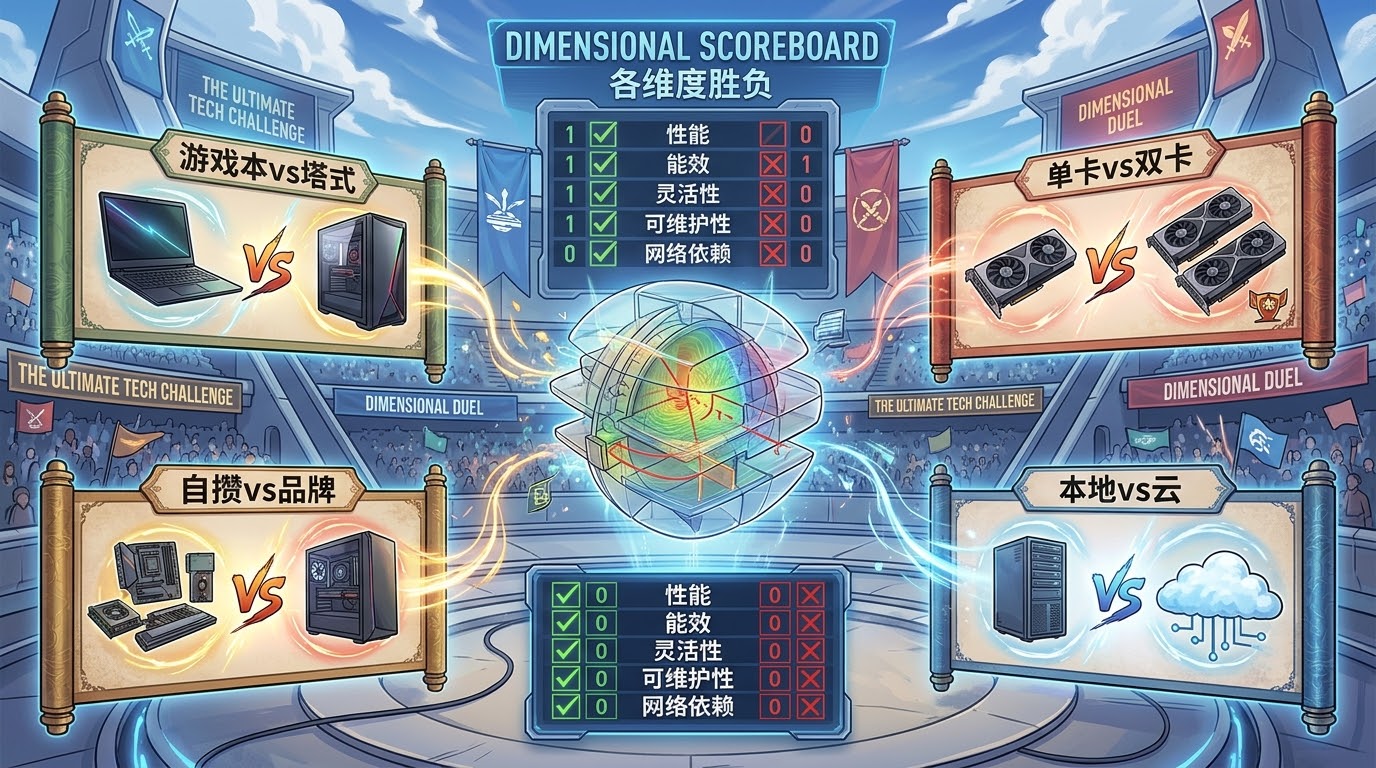
开场 一个问题 两种答案
课题组要换设备,导师问了一句:“买几台顶配的电竞游戏本,大家背着去实验室,行不行?”
做天线设计的学生摇头,但真要他讲清楚差距在哪,一时间也列不出几条硬核理由。这个场景在微电子方向的实验室里反复上演:一边是笔记本、自攒机、云端租用这些“看起来够用”的选项,一边是塔式图形工作站这种“正经装备”,预算有限,钱到底该花在哪?
先看清这门课在算什么。天线与电磁器件设计的流程是:建模、全波仿真、迭代优化、加工、测试,其中七成时间耗在仿真迭代上。2021年8月,国际权威杂志《增材制造》在线刊发了华中科技大学光学与电子信息学院吕文中教授团队的成果《3D打印低温烧结5G MIMO陶瓷龙勃透镜天线》:团队引入超材料结构实现高介电常数陶瓷介质的梯度分布,结合转换光学理论,用SLA紫外光固化3D打印工艺制备出低剖面龙勃透镜,在Ku波段实现了±15°的波束扫描,对馈源的增益提升超过5 dBi。这类设计的共同点是:梯度介电常数分布、透镜曲面与馈源的位置关系,每一毫米的几何微调都要靠全波仿真回验,离开算力寸步难行。
下面摆擂台,四场对决,把“两种答案”的差距一项项算清楚。
Round 1 游戏本 vs 塔式工作站
第一项比散热。游戏本的整机散热上限通常在145W上下,跑游戏是短促爆发,跑电磁仿真是八小时起步的匀速重载——HFSS的频域求解器一旦开始扫频,CPU会被压到满载数小时。笔记本撞到温度墙后降频运行,同样一个算例,求解时间拉长两三成并不稀奇。塔式工作站的风道为持续满载设计,CPU可以长时间稳在标称的全核频率上,这是两类机器的分水岭。
第二项比内存。未知数规模一上量级,内存就是天花板:频域有限元用直接求解器时,内存占用随未知数近似平方增长;用迭代求解器,矩阵乘向量迭代对内存带宽极其敏感。一个上千单元的相控阵全波模型,把内存推到100GB以上很正常。游戏本内存封顶一般就是64GB到96GB,塔式工作站起步128GB,上到384GB只是配置单上的选项。
第三项比稳定性。电磁仿真实验室常见“过夜算例”:晚上提交,早上看结果。游戏内存没有ECC,一夜满载下来一次单比特翻转,早上等你的就是报错或者悄悄跑偏的结果。
| 对比维度 | 电竞游戏本 | 塔式图形工作站 |
|---|---|---|
| 持续满载散热 | 撞温度墙降频 | 按全核满载设计风道 |
| 内存上限 | 64~96GB,难扩展 | 128GB起步,可扩至数百GB |
| ECC内存 | 无 | 有 |
| 显卡扩展 | 不可更换 | 按需加装 |
| 使用场景 | 演示、出差救急 | 交付级算例 |
结论很直接:游戏本能“跑起来给人看”,塔式才能“跑完交出去”。
Round 2 自攒机 vs 品牌工作站
第二场的论点是“我自己攒一台,配置一样还便宜”。账面上可能成立,实际用起来有三个坑。
第一个坑是兼容性。HFSS、CST这类商业求解器对平台有认证列表,对内存通道、BIOS版本、驱动组合都敏感。自攒机最容易踩的是内存混搭:四条不同批次内存插上去能点亮,但四通道跑不满,迭代求解的内存带宽直接打七折——你买了同样的CPU,却只用到七成的求解速度。
第二个坑是稳定性。品牌工作站的电源功率、散热风道、主板布线是按整机满载系统设计的,还有ECC内存和冗余电源兜底;自攒机的每个部件单独看都不差,凑在一起没人对整体负责。7×24小时满载的电磁仿真,压的正是这套系统能力。
第三个坑是隐性成本。自攒机出了问题,排查周期以天计,坏一个风扇等三天快递,课题组博士生两周的调试时间,折算成科研进度,比省下的差价贵得多。
| 对比维度 | 自攒机 | 品牌工作站 |
|---|---|---|
| 部件兼容性 | 混搭风险自担 | 整机认证测试 |
| 持续满载稳定性 | 无人对整体负责 | 电源/风道/ECC系统设计 |
| 故障停机 | 自行排查,周期以天计 | 商用备件,快速响应 |
| 真实成本 | 差价被调试时间吃掉 | 三年总成本可控 |
结论:自攒机的“便宜”是幻觉,账要按三年总成本算,只盯装机单必然吃亏。
Round 3 单卡旗舰 vs 双卡并行
第三场是预算充足之后的纠结:同样一笔钱,买一张旗舰计算卡,还是买两张中端卡?
先把求解器的脾气摸清。频域有限元(HFSS的主力算法)用直接法时主要吃内存容量和带宽,迭代法吃内存带宽,GPU加速在频域求解里能参与的部分有限;时域有限积分法(CST的主力算法)对GPU友好得多,加速收益直接体现在单卡显存容量和显存带宽上;矩量法(FEKO一类)要装配稠密矩阵,内存容量第一位。换句话说:时域负载看单卡,频域负载看内存子系统,双卡的价值取决于你的软件能不能把第二张卡吃满。
再说双卡的两个暗坑。其一,多数求解器的多卡并行要么按模块授权,要么只支持特定求解类型,买了第二张卡发现授权不含,等于白配。其二,两张中端卡的显存不会叠加成一张大卡,单卡装不下的模型,双卡也未必装得下,除非求解器明确支持分布式内存求解。
结论:单卡大显存是“确定能用到的性能”,双卡是“先确认求解器和授权吃得满,再掏钱”。
Round 4 本地塔式 vs 云端租用
第四场比的是“我还要不要买机器”。云端按小时租一台仿真服务器,听起来省心,但要过三道关。
第一道是数据安全。相控阵、卫通载荷、电磁兼容整改这些项目,模型和测试结果往往带保密要求,资料不出域是硬杠杠,公有云首先出局。第二道是交互体验。电磁仿真的前处理是重GUI操作:建模、剖分、看场分布,走远程桌面每一步都有延迟感,日常迭代体验跟本地机器完全两回事。第三道是成本结构。云端按小时计费适合峰值冲刺——比如结题前集中扫一批参数;但课题组日常是“改一点、跑一下、看结果、再改”的高频迭代,按三年算总账,本地塔式的持有成本远低于云端常驻租用。
结论:两者是互补关系——本地塔式扛日常高频迭代,云端扛结题前的峰值冲刺。先用云端试出自己算例的真实胃口,再决定本地买什么档次,这个顺序最省钱。
大模型本地化部署 电磁设计知识库怎么落地
仿真算力之外,新需求也要一并规划:把大模型请进实验室。电磁方向的用法很具体——设计规范问答(设计规则、电磁兼容限值随问随查)、仿真报告助手(场图和S参数整理成初稿)、HFSS/CST脚本生成与报错诊断。为什么必须本地部署:一是相控阵与电磁兼容项目资料保密,模型对话不能出域;二是暗室和外场测试环境网络受限,离线可用是刚需;三是课题组的设计规则和历史型号数据能灌进本地知识库做检索增强,越用越顺手。
模型选型两个就够。Qwen2.5-32B-Instruct 阿里通义2024年9月开源,32.5B参数稠密模型,128K上下文,负责日常问答、脚本生成与报告起草。GLM-4.5 智谱2025年7月开源,MoE架构,总参数355B、每轮推理激活32B,128K上下文,工具调用与长程推理突出,适合规范核查、多文档交叉比对这类重推理任务;同系列 GLM-4.5-Air 总参数106B,更轻量。
显存账先算清:所需显存约等于参数量(B)乘量化字节数再乘1.2预留系数(覆盖KV缓存与系统开销),FP16每参数2字节,Q8为1字节,Q4为0.5字节。算例一:Qwen2.5-32B-Instruct 的Q4量化约19到22GB,24GB显存是舒适线。算例二:GLM-4.5 是MoE,显存按总参数355B计算,Q4约213GB,单卡装不下,需多卡合计240GB以上;GLM-4.5-Air 的Q4约64GB,一张84GB级别的专业卡即可容纳。
量化三档:FP16几乎无损但显存翻倍;Q8损失约一到三个百分点;Q4损失五到十个百分点、体积仅为FP16的四分之一,是默认选项,关键结论再切高精度复核。
速度要有预期:纯CPU内存推理只有个位数tokens/s,问一句等几十秒;单卡GPU推理能到几十到上百tokens/s,解码速度看显存带宽,一篇仿真报告几分钟出初稿,这是工作站相对普通电脑的价值。
推理之外是微调的分水岭:QLoRA 对 Qwen2.5-32B 做电磁领域适配,量化加载加LoRA增量约需26到30GB显存;全参数微调哪怕7B模型也要80GB以上。想清楚“只推理”还是“推理加微调”,档位往哪探就清楚了。
软件清单
操作系统按求解器要求选Windows工作站版或Linux。电磁仿真主力三件套:ANSYS HFSS(频域有限元)、CST Studio Suite(时域有限积分)、Altair FEKO(矩量法/多层快速多极子),射频电路侧配ADS或Cadence AWR。脚本与数据处理用MATLAB和Python(NumPy/SciPy),版本管理用Git。大模型服务用vLLM对外提供OpenAI兼容接口,轻量验证可用Ollama。注意商业求解器的授权口径:多数按核数或按卡授权,采购机器前先核对授权阶梯,别把预算花超在授权上。
综合评分与赢家组合
四场打完,把比分汇总一下:
| 对决场次 | 胜出方 | 胜出理由 |
|---|---|---|
| 游戏本 vs 塔式工作站 | 塔式工作站 | 持续满载、内存扩展、ECC全面占优 |
| 自攒机 vs 品牌工作站 | 品牌工作站 | 三年总成本与稳定性胜出 |
| 单卡旗舰 vs 双卡并行 | 单卡旗舰 | 显存确定性胜出,双卡看软件脸色 |
| 本地塔式 vs 云端租用 | 互补组合 | 本地管日常迭代,云端管峰值冲刺 |
这些年帮不少微电子方向的课题组配机器,发现一个规律:大家最容易踩的坑在于“买偏了”——把时域求解器的预算砸在了CPU上,把频域求解器的预算砸在了显卡上,最后两头都不满意。结合前面四场对决的结论和电磁仿真的负载特征,下面按赢家组合给出四档参考机型,都是报价表里的实际机型,下单前可按课题组的目标模型规模和并发人数微调。
性价比冠军
适用场景:个人桌面级使用,微波器件与中小规模天线建模仿真学习,Qwen2.5-32B-Instruct 级模型Q4量化本地推理常驻,兼顾课程与毕设。
| 硬件类别 | 具体配置 | 说明 |
|---|---|---|
| CPU | Intel Ultra9 285K (24核, 8P核5.6GHz) +水冷 | 24核高频处理器是HFSS/CST中小规模算例求解的主力 |
| GPU | RTX5090D v2 24GB+水冷 | 24GB显存让Qwen2.5-32B Q4量化常驻,并为时域求解留加速余量 |
| 内存 | 128GB DDR5 | 达到文中”频域求解128GB起步”的底线,个人算例不必省内存 |
| 存储 | 4TB NVME + 8TB SATA | NVMe保证系统与求解器响应,8TB数据盘容纳算例与场图归档 |
| 显存 | 24 GB | 32B模型Q4量化的舒适线 |
| 显存带宽 | 1.34 TB/s | 高带宽直接决定大模型解码与GPU求解的吞吐 |
推荐机型:A350 153128-MCT
硬件解析:典型的个人桌面甜点位——24核高频CPU与128GB内存守住中小规模频域求解的底线,24GB显存恰好让32B级模型Q4常驻,把”仿真学习+本地大模型”两件事压进一台机器,是赢家组合里的入门答案。
稳定高效之选
适用场景:课题组主力机,HFSS频域求解高速计算型负载,大内存支撑千万级未知数的直接法与迭代法求解,多人排班共享。
| 硬件类别 | 具体配置 | 说明 |
|---|---|---|
| CPU | AMD霄龙9375F (32核4.4GHz) +水冷 | 32核全核4.4GHz正是频域有限元直接法与迭代法最敏感的高频多核形态 |
| GPU | RTX A1000 | 亮机级专业卡,把预算让给CPU与内存,符合频域负载”显卡让位内存”的结论 |
| 内存 | 192GB DDR5 | 越过相控阵全波模型100GB级的门槛,直接法与迭代法都有翻倍余量 |
| 存储 | 4TB NVME SSD | 大算例文件高速读写,缩短载入与写盘等待 |
| 显存 | 8 GB | 满足GUI前处理与轻量可视化,不承担GPU求解 |
| 显存带宽 | 192.0 GB/s | 匹配亮机卡定位,频域主求解路径不依赖GPU加速 |
| 性能指标 | C3.2T | 整机综合算力指标,对应频域高速计算型定位 |
推荐机型:AE450 144192-MCB
硬件解析:这是一台把预算全部倾斜到频域求解真正吃的子系统上的机器——32核全核4.4GHz加192GB大内存是主角,显卡刻意收敛为亮机级专业卡,正对应”频域负载看内存子系统”的结论,是课题组主力机的性价比形态。
性能冠军
适用场景:大规模电磁仿真(时域、频域求解)专家级平台,大显存单卡支撑时域加速与70B级模型Q4辅助设计,电磁兼容规格智能检查。
| 硬件类别 | 具体配置 | 说明 |
|---|---|---|
| CPU | Xeon 6952P (96核3.2GHz) +水冷 | 96核大算力兜住超大规模频域/时域网格的CPU侧求解 |
| GPU | RTX 6000D 84GB+水冷 | 84GB单卡大显存是”单卡旗舰”路线的落点,时域加速与70B级Q4辅助设计同卡共存 |
| 内存 | 512GB DDR5 | 512GB支撑千万级以上未知数的直接法与迭代法求解 |
| 存储 | 4TB NVME / 20TB SATA | 系统盘与数据盘分离,匹配长期大算例归档 |
| 显存 | 84 GB | 单卡容纳70B级模型Q4量化(约64GB)后仍有富余 |
| 显存带宽 | 1.57 TB/s | 大模型解码与GPU求解的共同速度来源 |
| 性能指标 | GPU FP32:80T(计算规模9.6亿网格) | 标注9.6亿网格级计算规模,对应超大规模电磁仿真定位 |
推荐机型:AX450 132512-MCE
硬件解析:单卡旗舰结论的代表作——96核CPU与512GB内存兜住频域直接法的胃口,一张84GB大显存专业卡同时吃下时域加速与70B级模型Q4辅助设计,一机覆盖电磁仿真的两大负载,把”确定能用到的性能”写进配置单。
扩展性冠军
适用场景:仿真与大模型一体化平台,多卡大显存并行支撑超大规模时域仿真和GLM-4.5级MoE模型团队私有化部署,全课题组并发使用。
| 硬件类别 | 具体配置 | 说明 |
|---|---|---|
| CPU | 2×Xeon金牌6530 (64核2.7~4GHz) | 双路64核兜底CPU密集求解与全课题组多任务并发 |
| GPU | 4×RTX Pro 6000 96G +水冷 | 四张96GB专业卡共384GB显存,GLM-4.5级MoE Q4与超大规模时域仿真可并行布局 |
| 内存 | 512GB DDR5 | 512GB大内存配合多卡分布式求解与多人排班共享 |
| 存储 | 系统盘 4TB NVMe 数据盘 20TB SATA | 系统与数据物理分离,承载团队级数据量 |
| 显存 | 4×96 GB | 合计384GB,越过文中GLM-4.5多卡合计240GB以上的部署门槛 |
| 显存带宽 | 4×1.79 TB/s | 四卡各自独立高带宽,多卡推理与求解互不争抢 |
推荐机型:GX660M 232512-MD4F
硬件解析:仿真与大模型一体化的顶配形态——双路CPU、512GB内存与四张96GB专业卡,把超大规模时域仿真和GLM-4.5级MoE私有化部署装进同一台机器,团队并发也不用排队,是四场对决全部结论叠加后的终极答案。
常见问题
电磁仿真到底吃CPU还是吃显卡
看求解器。HFSS的频域有限元主要吃CPU多核和内存带宽、容量;CST的时域求解吃单卡GPU显存和显存带宽;FEKO的矩量法吃内存容量。先摸清自己常用的求解器,再决定预算往CPU还是显卡倾斜。
内存该配多大
按未知数规模估:频域直接法的内存随未知数近似平方增长,迭代法近似线性。实践上,一个中等规模相控阵全波模型就能把内存推到100GB以上,建议128GB起步,预留翻倍空间。跑过夜算例务必选ECC内存。
双卡为什么有时候没用
两个原因:一是求解器多卡支持有限,授权可能按卡另算;二是双卡显存不叠加,单卡装不下的模型双卡未必装得下。买双卡前先确认软件的多卡求解类型和授权口径。
32B大模型和仿真软件抢一张卡怎么办
错时使用。白天仿真求解优先,大模型跑轻量问答与脚本补全;夜间批量扫参时,把大模型的显存配额压到Q4最小档。24GB显存的机型让32B模型Q4常驻没有压力,84GB以上的机型可以让70B级模型与日常仿真共存。
结语
擂台打完了,每个赢家都只对一类痛点负责。落到你自己的课题上,顺序只有一个:先摸清求解器和模型规模的胃口,再按四场对决的结论对号入座。机器没有完美的,但账算清楚的采购,永远不会错。











