
一场四千支战队的大练兵
2025年7月19日至20日,第十八届全国大学生信息安全竞赛创新实践能力赛总决赛在河南郑州举行。根据赛事组委会公开的参赛手册,本届赛事吸引全国高校4240支战队、14145名学生报名,经过初赛与五个分区赛的层层筛选,最终80支战队、320名选手站上总决赛舞台。赛题覆盖CTF解题赛、AWD攻防赛,并首次把网络空间测绘、人工智能安全、量子安全等前沿方向纳入考核。
这项连续举办十八届的赛事,被称为国内级别最高、覆盖最广的网络安全学科竞赛。它同时也是一面镜子:攻防对抗已经从少数天才黑客的绝活,变成一项有标准流程、有工程体系、有大量计算支撑的专业工作。
同样的变化也发生在科研端。2023年11月,第二届“华为杯”中国研究生网络安全创新大赛在杭州举行,华中科技大学“网安守望者”团队凭“慧识——恶意代码对抗检测与源头追踪系统”拿下创意作品赛全国一等奖。公开报道显示,该团队依托国家网络安全人才与创新基地,围绕恶意代码检测性能、抗混淆能力和信息挖掘深度做系统化研究。这类工作的背后,是流量数据、样本数据、情报数据的持续加工,对算力的消耗并不亚于一场中型仿真。
往产业侧看,趋势更直接:每年的护网行动与重保任务、安全运营中心(SOC)的日常告警研判、威胁情报厂商的生产线,都在重复同一套动作——采集、检测、分析、还原、出报告。问题随之而来:支撑这套动作的工作站,到底该按什么逻辑配?
从流量到情报 这条流水线在算什么
网络攻防与威胁情报生产的典型工作流,可以拆成五段。
第一段是数据采集。流量镜像、全包抓取(pcap)、终端日志、蜜罐诱捕记录、威胁情报源订阅,统统汇入本地。一个10Gbps出口镜像一天的原始包就能达到数TB量级,这是整个流程的“原料仓”。
第二段是检测分析。入侵检测系统(Suricata)、网络分析框架(Zeek)对流量做规则匹配与协议还原;机器学习模型对加密流量、DNS异常、恶意域名做分类打分。学术论文中常见的恶意流量检测方案,多用一维卷积或循环神经网络对统计特征序列建模,推理本身不重,但样本量和特征维度一上来,批量处理就很吃资源。
第三段是恶意样本分析。静态层面做PE结构解析、导入表与字符串提取、模糊哈希(ssdeep、TLSH)相似度比对;动态层面把样本丢进沙箱跑行为,记录进程树、注册表、网络外联。沙箱是纯粹的I/O密集型负载,同时要求多实例并发隔离。
第四段是情报生产。从告警和样本中抽取IOC(失陷指标),做去重、富化、置信度评分,映射到MITRE ATT&CK战术技术矩阵,沉淀进威胁情报平台,构成可检索、可关联、可推送的知识库。
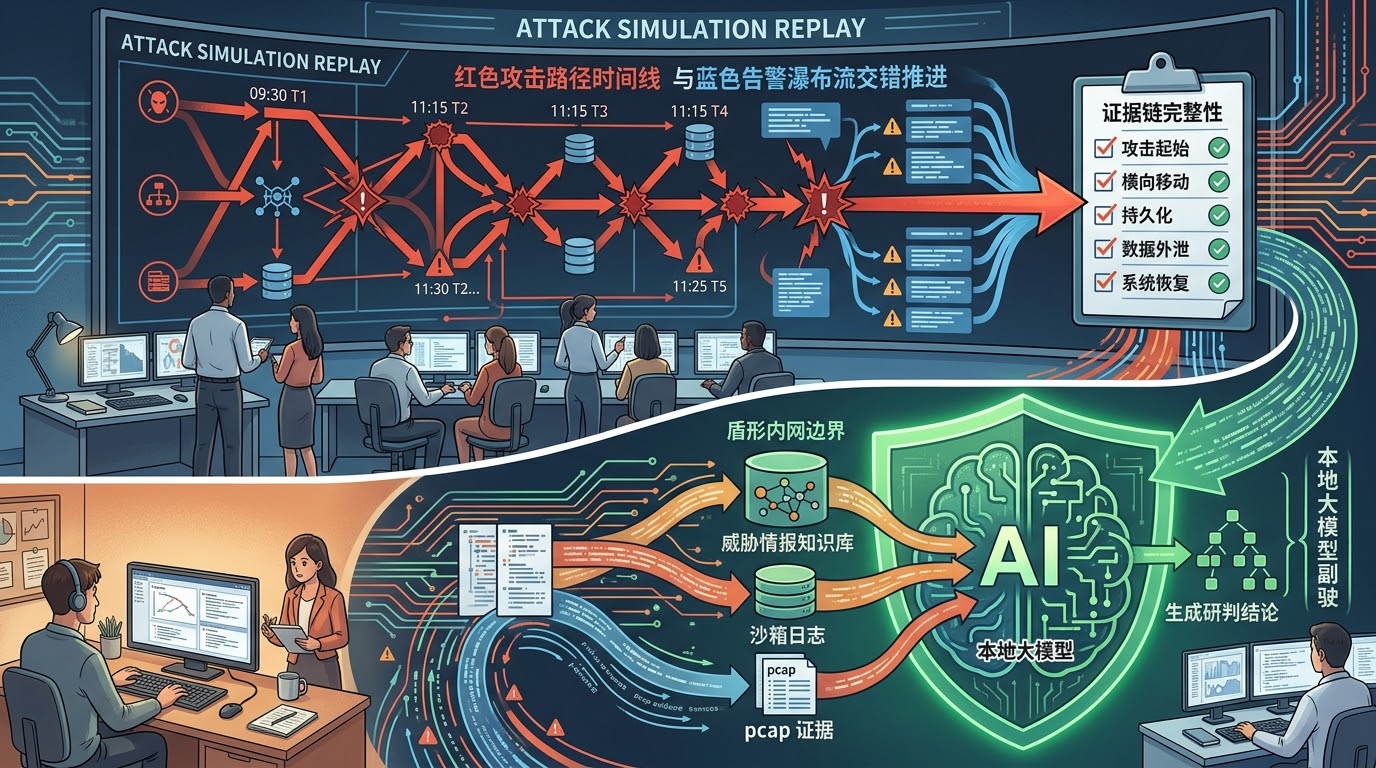
第五段是演练复盘。攻防演练结束后,要把分散的日志、告警、流量片段串成完整的攻击路径,评估防守方的检测盲区和响应时延,产出复盘报告。这一步目前消耗最多人时,也是大模型最能帮上忙的地方。
计算特点与数据IO特征
把五段流水线摊开看,硬件需求画像就清楚了。
CPU侧的特点是“多核并行加单核冲刺”并存。包处理、日志解析、规则匹配可以高度并行,核心数直接决定稳态吞吐;而Suricata的单个高速流处理、正则编译、单个大pcap的逐包解码,又会被单核性能卡脖子。所以这颗处理器既要核多,也不能频率太低。
内存是第二道门槛。日志检索平台(Elasticsearch一类)的堆内存、威胁情报知识库的图计算、沙箱的多虚拟机并发,都会把内存容量顶上去。内存一旦不够,平台开始交换,检索和关联分析的响应时间会成倍恶化。
GPU的角色在变化。传统安全分析对显卡要求不高,但机器学习检测模型推理、恶意样本的深度学习分类,再叠加近年兴起的大模型辅助研判,显卡已经从“可选件”变成“常驻件”,而且显存容量直接决定能跑多大的模型。
存储是隐形的成本大户。原始pcap按法规和业务要求往往要留存数月,冷数据量以十TB计;热数据侧,日志平台索引的写入放大、沙箱快照的频繁读写,又要求NVMe级别的随机性能。分层存储几乎是唯一务实的答案。
最后是网络。全包抓取要吃满万兆镜像流量,采集网卡、驱动卸载能力、写盘吞吐三者缺一,抓出来的包就会丢帧,后续分析全是错的。
把瓶颈翻译成硬件语言
把上面的特征翻译成采购语言,这台机器的长相大致是:一颗多核且高主频的处理器,承接并行的包处理与日志解析;足够大的内存,让日志平台和知识图谱全程驻留;一张显存充裕的显卡,同时覆盖检测模型推理和大模型部署;存储按“NVMe热数据加SATA大容量冷数据”分层配置;万兆网口打底,视流量规模考虑专用采集卡。
反过来看几个常见误区:只堆CPU核心数,日志平台照样被内存拖垮;只买大显存显卡,抓包丢帧会让所有分析失真;硬盘只配一块大容量SATA盘,沙箱并发和日志写入会互相踩踏。攻防场景的特殊之处在于,任何一环掉链子,损失的不只是运行时间,更贵的是证据链的完整性。
大模型私有化部署 情报生产的副驾驶
为什么安全团队对大模型私有化部署如此上心?原因很具体。其一,告警原文、流量载荷、样本细节都涉及敏感信息,把内部安全数据贴进公有云模型对话框,多数单位的保密制度过不了审。其二,告警研判是7×24小时的长期消耗,按API调用付费的账单拉长看并不便宜,本地一次投入更可控。其三,很多演练环境本身运行在隔离网里,离线可用是硬要求。
模型选型上,两个真实开源模型足以覆盖主力场景。Qwen3-14B由阿里通义团队于2025年4月开源,约148亿参数,中文能力强、函数调用完善,适合承担IOC提取、告警摘要、情报日报草拟这类高频任务。DeepSeek-R1-Distill-Qwen-32B由深度求索于2025年1月开源,约320亿参数,是经过强化学习蒸馏的推理模型,适合承担告警研判、攻击路径推理、演练复盘问答这类需要多步思考的任务。
显存账要先算清楚。估算口径为:所需显存约等于参数量(B)乘以量化字节数再乘以1.2的预留系数(覆盖KV缓存与系统开销),其中FP16每参数2字节,Q8为1字节,Q4为0.5字节。Q4量化下每10亿参数大约占0.6 GB,已含部分KV缓存。
| 模型 | FP16 | Q4量化 | Q4舒适档 |
|---|---|---|---|
| Qwen3-14B(约148亿) | 约28 GB | 约9 GB | 12~16 GB显存 |
| DeepSeek-R1-Distill-Qwen-32B(约320亿) | 约64 GB | 约19~22 GB | 24 GB显存 |
按这个口径,Qwen3-14B在Q4下约需9 GB显存,加上长上下文余量,16 GB显存可以从容运行;DeepSeek-R1-Distill-Qwen-32B在Q4下约需19到22 GB,24 GB显存是起步线,上下文拉长或多人并发时还要再留余量。
量化等级的选择逻辑是:FP16几乎无损但显存翻倍,Q8损失约一到三个百分点,Q4损失约五到十个百分点但体积只有FP16的四分之一,是消费级显卡上的默认选择。日常摘要和情报草拟用Q4足够,涉及关键研判结论时可以切换高精度版本复核。
速度量级上要有心理预期:纯CPU内存推理通常只有个位数tokens/s,分析一条告警要等几十秒,实用性很差;单卡GPU推理则能达到几十到上百tokens/s,一份复盘材料几分钟内出初稿,这才是工作站相对普通电脑的真正价值。
推理之外还要考虑微调。用LoRA对14B级模型做安全领域适配,显存增量大约3到5 GB,前述显存余量足以覆盖;而全参数微调哪怕7B模型也要80 GB以上显存,这意味着微调能力直接决定配置档位能否上探,选型时要想清楚“只推理”还是“推理加微调”。
落到场景,本地大模型可以干三件实事:挂在威胁情报知识库上做RAG问答,新人查IOC背景、查历史事件不再需要翻共享盘;当告警研判副驾,把Suricata和沙箱的原始输出整理成结构化结论供分析师确认;在演练复盘阶段,把零散的日志证据串成时间线初稿,人工再修再核。数据全程不出内网,这才是私有化部署对安全团队的真实含义。
软件清单
操作系统建议Ubuntu Server或openEuler,隔离网环境提前备好离线源与镜像仓库。流量分析层用Zeek做协议日志化、Suricata做实时检测、Arkime做全包检索,Wireshark负责交互式排障。日志平台选Elasticsearch或OpenSearch,内存规划从安装第一天就做。沙箱选CAPE Sandbox(Cuckoo的活跃分支),支持Windows行为分析的可定制环境。威胁情报平台用MISP做IOC交换与共享,用OpenCTI做ATT&CK映射与知识图谱,底层图库配Neo4j。机器学习侧是PyTorch加scikit-learn的常规组合。大模型服务用vLLM或SGLang对外提供OpenAI兼容接口,轻量验证可用Ollama;全部服务建议容器化,用Docker Compose或K3s统一管理。授权方面,Elastic、Splunk等商业组件与开源组件的合规边界要提前确认。
UltraLAB配置怎么选
高校和团队买安全方向的设备,跟买仿真机器有个明显不同:机器往往要放在实验室或运营工位常年开机,既走采购流程,又要撑过几届学生的轮转使用,稳定性、噪音和售后权重要上调。前面把流量分析、情报生产、大模型私有化部署三条线的算力账算清了,下面按负载规模给三个参考档位,都是报价表里的实际机型,装机前可按实际数据规模微调内存与存储容量。
方案A:轻量分析档
适用场景:单人或小规模战队,日常流量回放分析、日志检索、恶意样本初筛,以及Qwen3-14B级模型辅助研判与报告草拟。
推荐机型:A350 15364-MBT
- CPU:Intel Core Ultra 7 265K,20核(8性能核全核5.3GHz/12能效核全核3.8GHz)(5.3GHz/3.8GHz为全核超频实测优化频率)
- GPU:RTX 5090D v2 24G 水冷(GPU水冷散热,24 GB GDDR7 显存,384 bit 位宽)
- 内存:64GB DDR5
- 存储:2TB NVMe
- 显存带宽:1.34 TB/s
方案B:情报生产档
适用场景:三至八人的课题组或小组,威胁情报库加RAG问答常态化运行,DeepSeek-R1-Distill-Qwen-32B级推理模型常驻,兼顾批量样本分析与LoRA领域微调。
推荐机型:AR350 148192-MCT
- CPU:AMD锐龙9950X3D(16核,4.85.7GHz)+水冷(CPU水冷散热)(4.85.7GHz为全核超频实测优化频率)
- GPU:RTX 4090 48G+水冷(GPU水冷散热,48 GB GDDR6X 显存,384 bit 位宽)
- 内存:192GB DDR5
- 系统盘:4TB NVMe
- 数据盘:8TB SATA
- 显存带宽:1.01 TB/s
方案C:复盘与服务中心档
适用场景:多人并发的攻防演练复盘环境,多模型同时在线服务,32B级模型的LoRA微调与知识库持续扩建,日志平台与沙箱全负载并发。
推荐机型:AX430 127128-MCF
- CPU:Xeon金牌6530(32核,2.7GHz)(2.7GHz为全核超频实测优化频率)
- GPU:RTX Pro 6000 96GB(96 GB GDDR7 显存,512 bit 位宽)
- 内存:128GB DDR5
- 存储:4TB NVMe
- 显存带宽:1.79 TB/s
常见问题
抓包丢帧怎么排查
先确认采集网卡和驱动支持线速处理,再看CPU单核占用是否触顶,最后核对写盘吞吐。三层里任何一层先饱和,丢帧就会从偶发变常态。定位后对症升级:换多队列网卡、把包处理线程绑核、热数据写NVMe。
日志平台越跑越慢怎么办
十有八九是内存和分片问题。索引按月滚动,冷索引关闭或快照到SATA层;堆内存按官方建议配比设置,别无限上调挤占系统页缓存。磁盘水位超过七成就要开始清理,否则写入会急剧劣化。
14B和32B模型到底怎么选
高频、短输出、追求响应速度的任务交给14B级;需要多步推理的研判、复盘类任务交给32B级蒸馏模型。预算允许就两个都部署,按任务路由,这是本地部署相对云端单模型的隐性优势。
隔离网环境怎么装模型和更新规则
装机阶段在有网环境把模型权重、Docker镜像、Suricata规则库、MISP情报源全部拉齐,打包进内网介质;之后按月度节奏离线更新。规则库和情报源的新鲜度决定检测能力的下限,这一步不能省。
安全数据本身怎么管
pcap和样本含有真实用户信息和恶意代码,平台权限要分级,对外共享前做脱敏,备份介质与工作站分离存放。技术手段之外,组内明确哪些数据可以进模型上下文,制度先行,工具兜底。
工作站配置选型欢迎咨询~
微信号:maxftxwx
fuyiqin@xasun.com












