
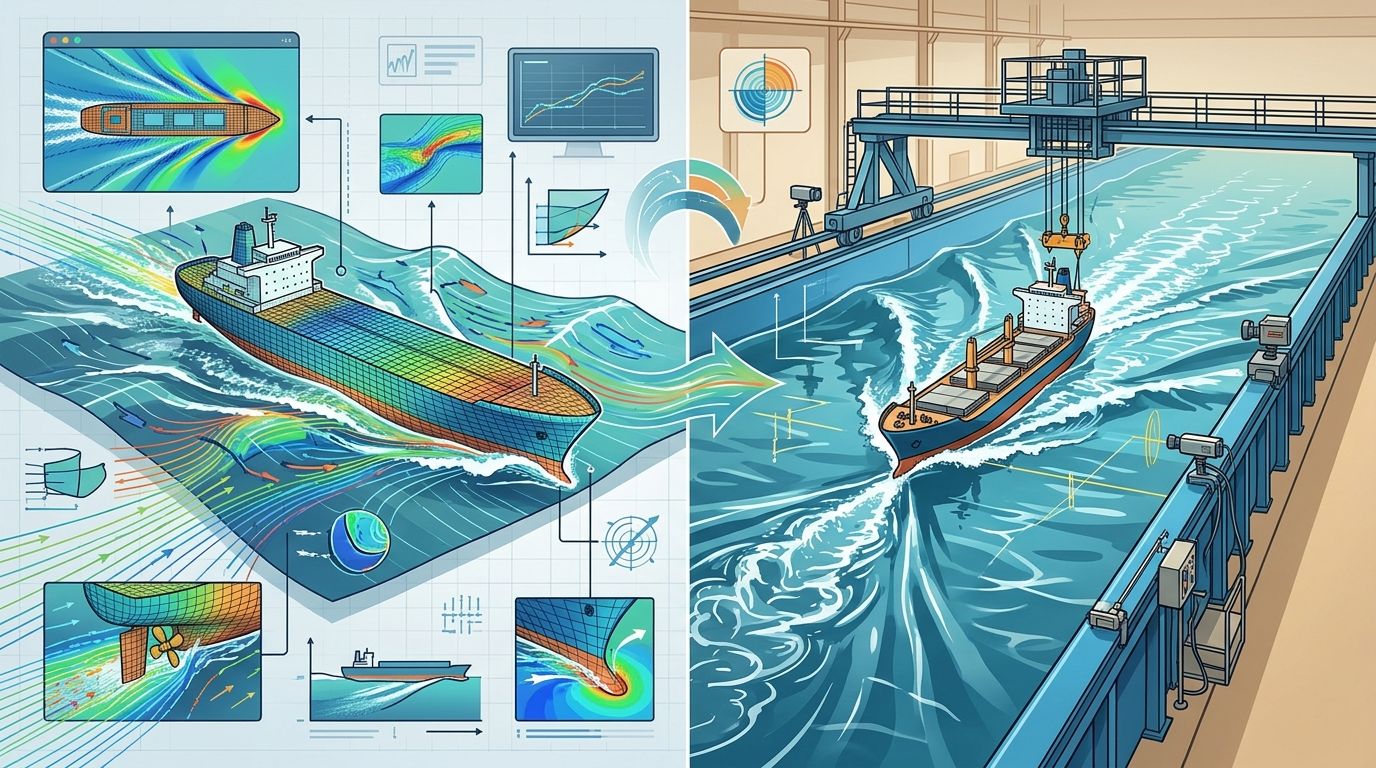
从一艘船模说起
做船舶水动力方向的人,第一课几乎都是在水池边上的。船模造好、配重调平,拖车拖着它从水池这一头跑到那一头,天平记下阻力,浪高仪记下波面,一组工况下来,一天就过去了。
华中科技大学船舶与海洋工程学院建有华中地区最大的船模拖曳水池实验室,池长一百七十五米,是国际船模试验水池会议(ITTC)的成员单位之一。2023年4月,依托这个水池等一批设施,该学院获批的“全国舰船科普教育基地”正式揭牌。水池这类设施的地位,到今天也没有动摇:实船尺度下的粘性相似、真实波浪环境的复杂性,很多问题数值方法暂时还替代不了。
但水池试验贵、慢、名额紧。一条新船型从概念到定型,要比较几十个甚至上百个方案,不可能每个方案都下水。于是CFD——计算流体力学——成了这个学科里另一根支柱。
船舶水动力CFD在算什么
船在水里跑,受到的力可以拆成几份。粘性摩擦阻力来自水贴着湿表面流动产生的剪切;粘压阻力来自船体曲率造成的压力分布;航速一提上来,兴波阻力迅速抬头,船行波把能量源源不断地带走。工程上用傅汝德数区分航速区间:低速船摩擦占大头,中高速船兴波主导。阻力预报的活儿,就是把这些分量一份份算准,再加起来。
耐波性是另一摊事。船在波浪里不会老老实实平着走,纵摇、垂荡、横摇六个自由度都在动,动得厉害了还要算波浪增阻——同样的主机功率,在风浪里航速可能掉一成以上。耐波性计算要在数值水池里造出规则波或不规则波,让船体在波里自由运动,求解器要同时处理自由面、六自由度刚体运动和船体受力,计算量比静水阻力大出一个量级。
再往深走一步,是操纵性和自航问题。船、螺旋桨、舵搅在一起互相干扰,桨抽进来的流不均匀,舵又躲在桨的尾流里。这类问题需要重叠网格配合DFBI(动态流体相互作用)模型,让附体在自己的局部坐标系里转,网格之间插值交换信息。华中科技大学船舶与海洋工程学院的研究者做过一个典型示范:用STAR-CCM+对KCS标准船模做斜拖试验和平面运动机构(PMM)仿真,提取水动力导数,再代回MMG操纵运动方程预报回转性能,结果与模型试验吻合良好。这条路线的意义在于,CFD从“算一条阻力曲线”延伸出去,反过来给系统辨识和操纵仿真提供输入。
算这笔账之前,先看看资源消耗长什么样
船舶CFD吃资源,是结构性的。
网格是第一道坎。一条带附体的单体船自航模型,单元数量千万级起步,要捕捉自由面和尾流细节,加密到三、五千万也不稀奇。造波计算还要在计算域里留出一截数值水池,波传播区域网格太粗,波还没传到船边就散了形。网格量直接决定内存占用和求解时间,八千万单元的算例,光网格文件就得好几个GB。
第二道坎是瞬态。URANS求解波浪中的船体运动,时间步长要满足自由面CFL数小于1,一个波周期切成一两百步,每条工况模拟十几个波周期起步才能谈统计稳定。粗算下来,一个耐波性规则波工况,几百核时很正常;不规则波的海况组合一铺开,几千核时就出去了。
第三道坎是验证。ITTC的验证确认规程要求至少三套疏密不同的网格做收敛性研究,配合时间步长无关性分析。不少人嫌这一步费钱,但不做这一步,算出来的阻力差百分之五,说不清是物理还是误差。前面提到的MMG那条路线之所以能站住,就是因为水动力导数先和试验数据对上了。
资源约束下的取舍
课题组的预算总是有限的。钱就这么多,机时就这么多,怎么花在刀刃上,是这个方向最实际的工程问题。下面四个取舍,几乎每个做船舶CFD的组都要面对。
取舍一:算得细,还是算得完
细网格加密自由面,阻力系数可能再准一个百分点;但这一个百分点的代价,可能是单个工况耗时翻三倍。合理的路线是漏斗形的:概念筛选阶段用粗网格加半船对称边界,跑十几个方案的相对优劣,选出两三个候选;终评阶段再放开对称面、加密网格、按ITTC规程做收敛验证,拿绝对值。把精算留到最后,漏斗上面那层越便宜越好。
取舍二:商业软件,还是开源求解器
STAR-CCM+、FLUENT这类商业软件上手快、文档全,自带重叠网格和造波模块,但授权费用不能只看首年——不少CFD软件按核数或按HPC token计费,一百核并行跑一个月,账单可能比工作站本身还贵。OpenFOAM免费,naoe-FOAM-SJTU这类面向船舶的开源求解器在造波、耐波性预报上已经相当成熟,还允许自己动手改物理模型;代价是学习曲线陡,出了问题得啃源代码。一个常见的组合是:研究性质的算例用开源深挖,交付性质、工期紧的任务用商业软件兜底。
取舍三:本地工作站,还是超算排队
超算的峰值算力诱人,但排队是隐形成本。一个参数改完想立刻看结果,排在别人后面等两天,思路就凉了。本地工作站的真正价值是交互性:前处理、试算、收敛性摸底都在本地完成,批量工况打包扔超算过夜,两头都不耽误。这也是为什么课题组哪怕握着超算账号,往往还是要留一台自己的算力工作站。
取舍四:一条船算到底,还是一批船扫过去
很多横向课题的真实需求,是在设计空间里快速扫一圈:球艏长度改三档,船宽改两档,排水量分布微调,找出阻力最低的方案族。这类任务适合广撒网——网格适度放粗,工况铺开跑,用相对趋势指导方案收敛,最后只对入选方案做精细预报。资源有限时,广撒网往往比单点钻深更能出成果。
大模型本机部署:给课题组配一个不外泄的“外脑”
这几年大模型成了科研流程里的新变量。文献综述、代码辅助、报告润色、数据解读,这些事务性工作吃掉课题组大量时间。把开源大模型部署在本机图形工作站上,数据不出内网,推理不依赖外部API,对船舶这种常涉及型号信息的行业,几乎是必走的一步。下面按六个要素把这件事讲清楚,模型池限定在两个真实可用的开源模型:Qwen3-30B-A3B和DeepSeek-R1-Distill-Qwen-14B。
任务场景
船舶CFD课题组用大模型,落点其实很具体:读文献、提炼综述要点;把试验报告和仿真日志里的表格转成初步分析结论;辅助写OpenFOAM算例字典和Python后处理脚本;润色投稿论文和项目申报书;起草组会汇报和结题材料。这些事不要求模型上知天文,但要求它稳、快、口径一致,而且说过的每句话都不能流出课题组的服务器。
模型选择
两个模型分工不同。Qwen3-30B-A3B是混合专家(MoE)架构,总参数约三百亿,每次推理只激活三十亿左右,日常问答、写作、摘要这类高吞吐任务响应快,适合作为全组共用的前台助手。DeepSeek-R1-Distill-Qwen-14B是从DeepSeek-R1蒸馏的推理模型,参数一百四十亿,遇到复杂问题会先输出一段推理链再给出结论,做公式推导、代码调试、试验数据归因这类需要多想几步的任务更合适。一个管日常,一个管攻坚,预分配在模型池里按需调用。
量化与显存估算
显存估算是部署前必须算清的账。经验公式很简单:显存占用约等于量化后的权重,再加上KV cache和运行时开销。Qwen3-30B-A3B按FP16存放权重大约要六十一GB,用AWQ或GPTQ量化到INT4后压缩到十七GB上下;DeepSeek-R1-Distill-Qwen-14B的FP16权重约三十GB,INT4量化后九GB左右。别忘了KV cache:上下文开长、并发一多,它还能再吃下几GB到十几GB。另外,MoE模型虽然每次只激活三十亿参数,全部权重却都得驻留显存,这一点常有人踩坑——按激活参数去配显存,加载时直接报错。
推理框架
服务化部署优先看vLLM和SGLang,两者都支持连续批处理,多人同时提问不用排队等单条生成完,对外提供OpenAI兼容接口,课题组现有的工具链改个地址就能接上。想快速验证效果,Ollama和llama.cpp几行命令就能把模型跑起来,适合先摸底再正式部署。注意MoE模型对各框架版本有要求,装环境前查一眼框架的模型支持列表,能省半天排错时间。
离线运行与数据安全
船舶水动力的数据经常沾着型号信息和横向课题的合同约束,物理隔离是最稳妥的选择:部署机不连公网,模型权重和依赖库一次性配齐,后续运维走内网。数据分级也要做起来——公开文献随便喂,组内数据脱敏后再进提示词,涉密内容干脆不接触大模型。再定一条规矩:定期清理对话日志和缓存文件,服务器上不留多余副本。
运维监控
本地推理服务也是生产服务,得有人盯。基础层面,用nvidia-smi看显存占用和温度,写个小脚本定时巡检、异常告警;进阶一点,上Prometheus加Grafana,把显存占用、GPU利用率、首token延迟、生成速度画成面板,谁把卡打满了、哪个模型变慢了,一眼看清。模型版本和提示词模板做归档管理,换版本能回滚,复现实验结果时不至于对着一口黑箱。多人共用时给推理服务设并发上限,避免晚高峰全组一起卡。
投入参考
最后落到配置上。船舶CFD加大模型本机部署的组合,按任务强度大致分三档,每档给出推荐机型与完整硬件参数,供选型时对标:
入门档:以前处理、后处理和文献工作为主
推荐机型:A350 15696-MCB
- CPU:Intel Ultra9 285K(24核,8P核5.6GHz)+水冷
- GPU:RTX A2000(6GB GDDR6版,显存带宽288 GB/s)
- 内存:96GB DDR5
- 存储:4TB NVME + 8TB SATA
这档的力气全花在前后处理的痛点上。几何清理和网格剖分是单线程密集环节,8个性能核跑到5.6GHz正顶在这个要害上;后处理可视化吃的是图形驱动稳定性,RTX A2000是专业图形卡,对常用CAD/CAE前后处理软件的OpenGL接口支持完整;96GB内存足够把千万级网格的模型整个加载进来做剖分、检查和局部加密。需要说明的是,这张卡的显存只有6GB,本地大模型推理不在它的能力范围内——课题组的外脑部署请交给下面两档,这台机器专心把前后处理和文献事务接住。
主力档:能承担常规尺度CFD试算与本机推理
推荐机型:AE450 145128-MC2T
- CPU:AMD锐龙Pro 7970X(32核,4.5GHz)(4.5GHz为全核超频实测优化频率)
- GPU:双RTX 4090 48G+水冷(每卡48GB GDDR6X,显存带宽每卡1.01 TB/s,双卡共96GB)
- 内存:128GB DDR5
- 存储:4TB NVMe
32核高频CPU把网格生成速度和URANS试算能力捏在了一起,常规尺度的阻力与自航试算、收敛性摸底都在它的射程之内。双48GB显卡按任务分家:一张负责CFD求解的GPU加速和图形后处理,另一张专职本地推理——Qwen3-30B-A3B量化到INT4后约17GB,全部权重驻留再加KV cache,在48GB里游刃有余,DeepSeek-R1-Distill-Qwen-14B可以同时常驻同一张卡,两个模型各就各位,谁也挤不到谁的显存。128GB内存应付千万级网格的试算算例留有余量。
进阶档:兼顾精细耐波性计算与大模型长时在线
推荐机型:AlphaPro660 345640-MDT
- CPU:2×AMD霄龙9575F(128核,4.5GHz)(4.5GHz为全核超频实测优化频率)
- GPU:RTX 4090 48G(48GB GDDR6X,显存带宽1.01 TB/s)
- 内存:640GB DDR5
- 存储:系统盘 8TB NVME(14GB/s),数据盘 20TB SATA
精细耐波性计算是本地求解的硬核负载:URANS瞬态求解对单核性能和内存带宽都敏感,双路128核跑到4.5GHz,把一个规则波工况的墙钟时间压到工程可接受量级,不规则波海况组合可以在本地排队铺开;640GB内存让ITTC规程要求的三套疏密网格同时驻留,收敛性研究不用来回倒数据。系统盘14GB/s的读取带宽直接回应前面那条教训——瞬态结果每个时间步落盘,IO跟不上的机器算起来一顿一顿的,这档不会。48GB显卡支撑30B级量化模型长时在线,多人并发之外还留得出长上下文的KV cache余量,全组共用的推理服务可以7×24小时挂着。
几条踩过坑才懂的提醒
网格收敛性验证那一步省不得。省一次,评审时就会被问一次,而且答不上来。
买机器别只数核心数。船舶CFD常常是内存带宽和磁盘IO先触顶,几十GB的网格文件读写、瞬态结果每个时间步落盘,IO跟不上的机器算起来一顿一顿的。
商业CFD软件的授权计费方式,立项时就问清楚按核还是按token,别等账单出来再去找经费。
大模型的显存按量化后的权重加KV cache估算,再留三成余量。按FP16毛估去买卡,预算至少翻一倍。
水池试验和CFD始终互为印证。华中科技大学那条MMG路线给过示范:仿真提供导数,试验提供标定,两头一对上,预报才敢往外拿。预算再紧,也要留一条和试验数据互相印证的通道。
结语
船舶水动力是一门被现实约束得死死的学问:水池的长度和拖车速度是约束,网格量和机时是约束,课题经费也是约束。在这个约束框架里做取舍,恰恰是这个学科最见功力的地方。一台资源分配得当的图形工作站,加两个随时待命的开源大模型,不能让水变少、浪变平,但能让每个方案算得更明白,让每组数据都留下可追溯的链条。船终究是要下水的,但在下水之前,值得把它在数字水池里先跑明白。
工作站配置选型欢迎咨询~
微信号:maxftxwx
fuyiqin@xasun.com












